Локальные ИИ-агенты представляют собой частную и бесплатную альтернативу таким инструментам, как Claude Code. Их основное преимущество заключается в конфиденциальности: модель работает на локальном диске, поэтому пользователь может обрабатывать файлы в папках, не опасаясь отправки данных на удаленные серверы. Однако при переходе от простых запросов к выполнению многоэтапных инструкций пользователи часто сталкиваются с нехваткой контекстного окна.
Почему локальные агенты быстро исчерпывают лимит контекста
Контекст — это объем текста, который модель удерживает в оперативной памяти в моменте, измеряемый в токенах. При работе агента этот объем расходуется не только на ваши сообщения, но и на ответы модели, описание доступных инструментов и содержимое всех прочитанных файлов. Каждый новый шаг задачи увеличивает нагрузку на контекст.
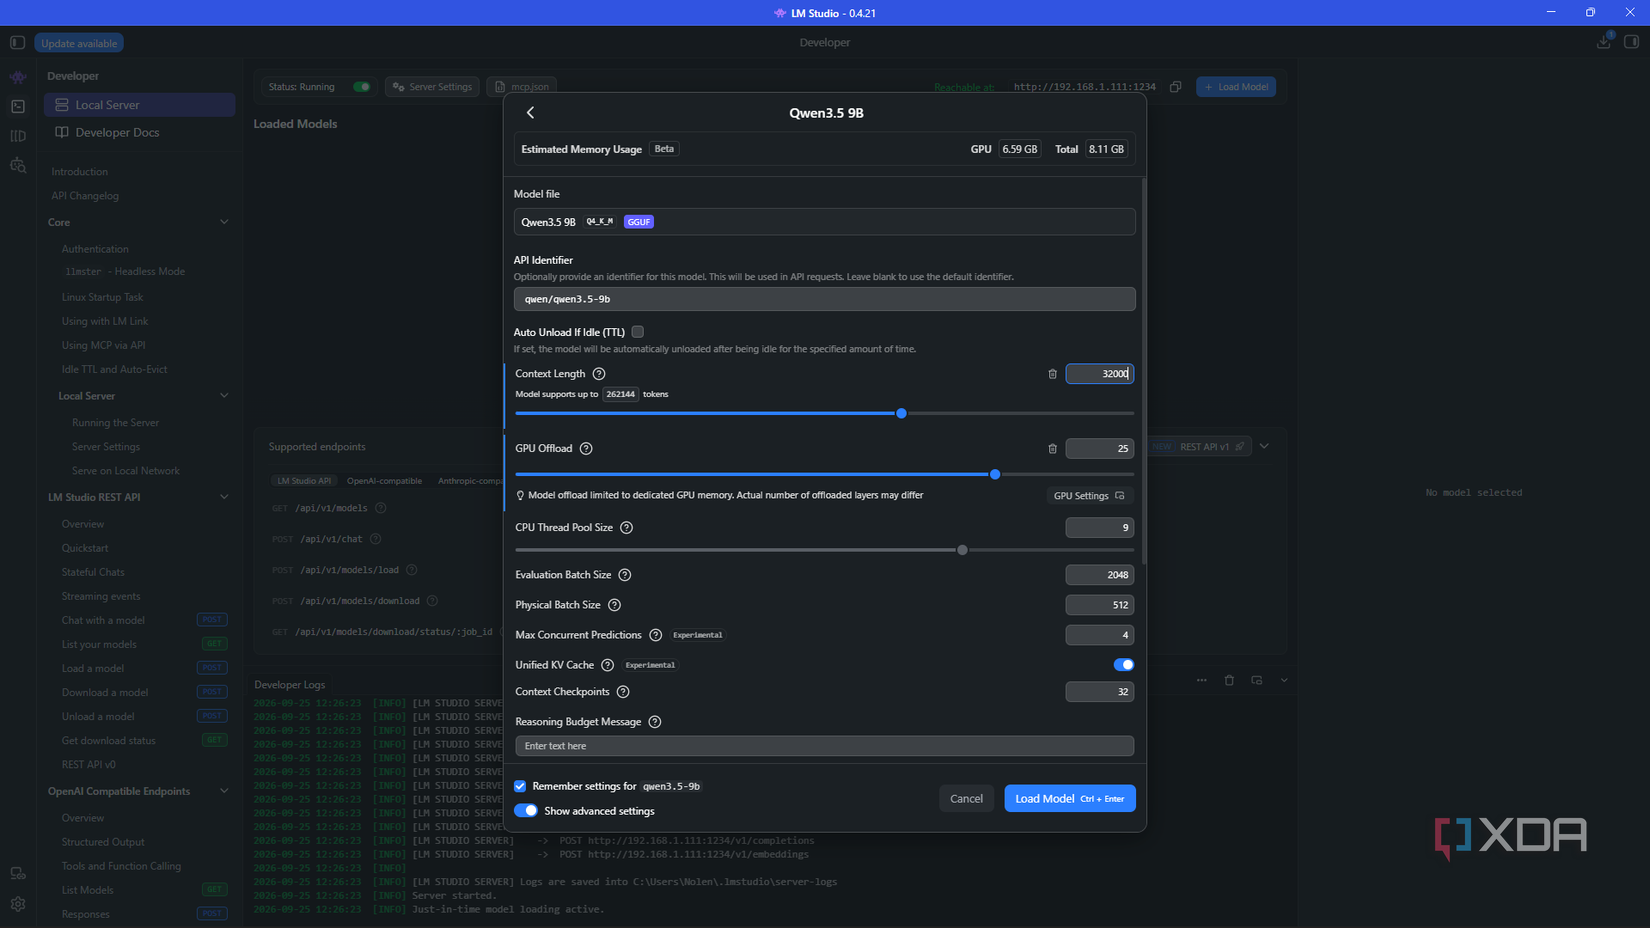
Многие популярные инструменты запуска локальных LLM по умолчанию задают слишком малые значения: LM Studio использует около 2000–4000 токенов, Ollama — до 4000 на картах с VRAM менее 24 ГБ, а llama.cpp придерживается аналогичных лимитов. В то время как разработчики кодинговых агентов рекомендуют иметь минимум 64 000 токенов, такие значения при стандартных настройках могут привести к сбою, так как контекст резервируется в видеопамяти.
Оптимизация VRAM для расширения контекстного окна
На видеокарте с 8 ГБ памяти важно грамотно распределять ресурсы, так как модель Qwen 3.5 9B в квантовании Q4_K_M занимает более 5 ГБ. Выбор квантованной модели (сжатой версии с уменьшенной точностью весов) является первым шагом к успеху: версии Q4 обеспечивают баланс между качеством и потреблением памяти, тогда как Q8_0 требуют вдвое больше ресурсов.
Для эффективной работы рекомендуется:
- Квантование KV-кэша: В настройках сервера (например, LM Studio) можно установить квантование K и V кэша на уровень Q8_0 при включенном Flash Attention. Это экономит видеопамять без существенной потери точности.
- Отключение режима рассуждений: Хотя в малых моделях Qwen 3.5 функция рассуждений (reasoning) по умолчанию отключена, стоит убедиться через логи, что она не активируется принудительно, так как она также расходует бюджет токенов.
- Настройка буфера: Оставляйте около 1,5 ГБ буфера между загруженной моделью и общим объемом памяти, чтобы избежать перелива данных в системную RAM, что ведет к замедлению работы.
Результаты настройки при многоэтапных задачах
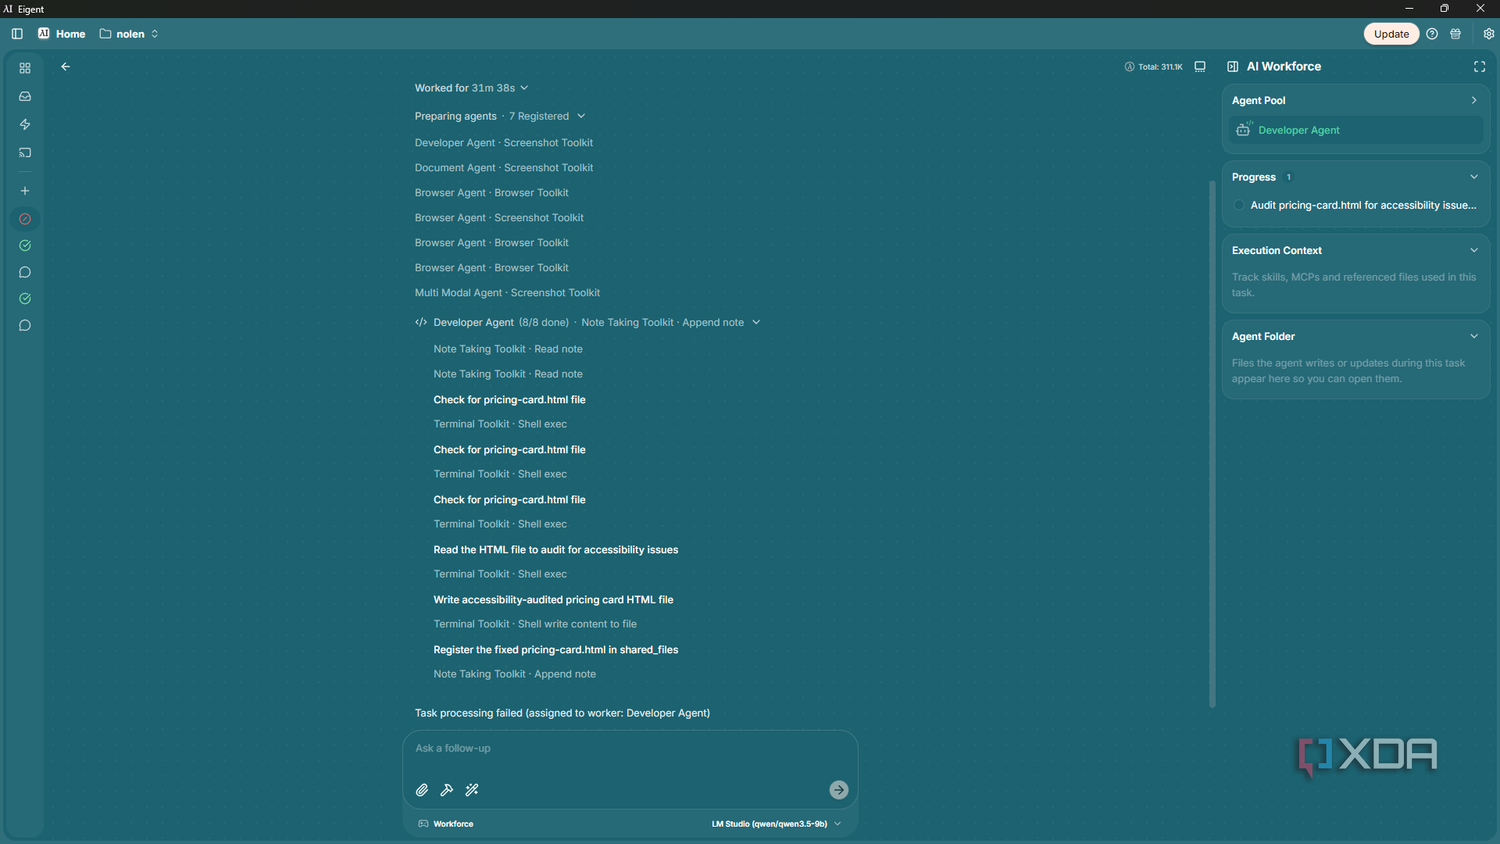
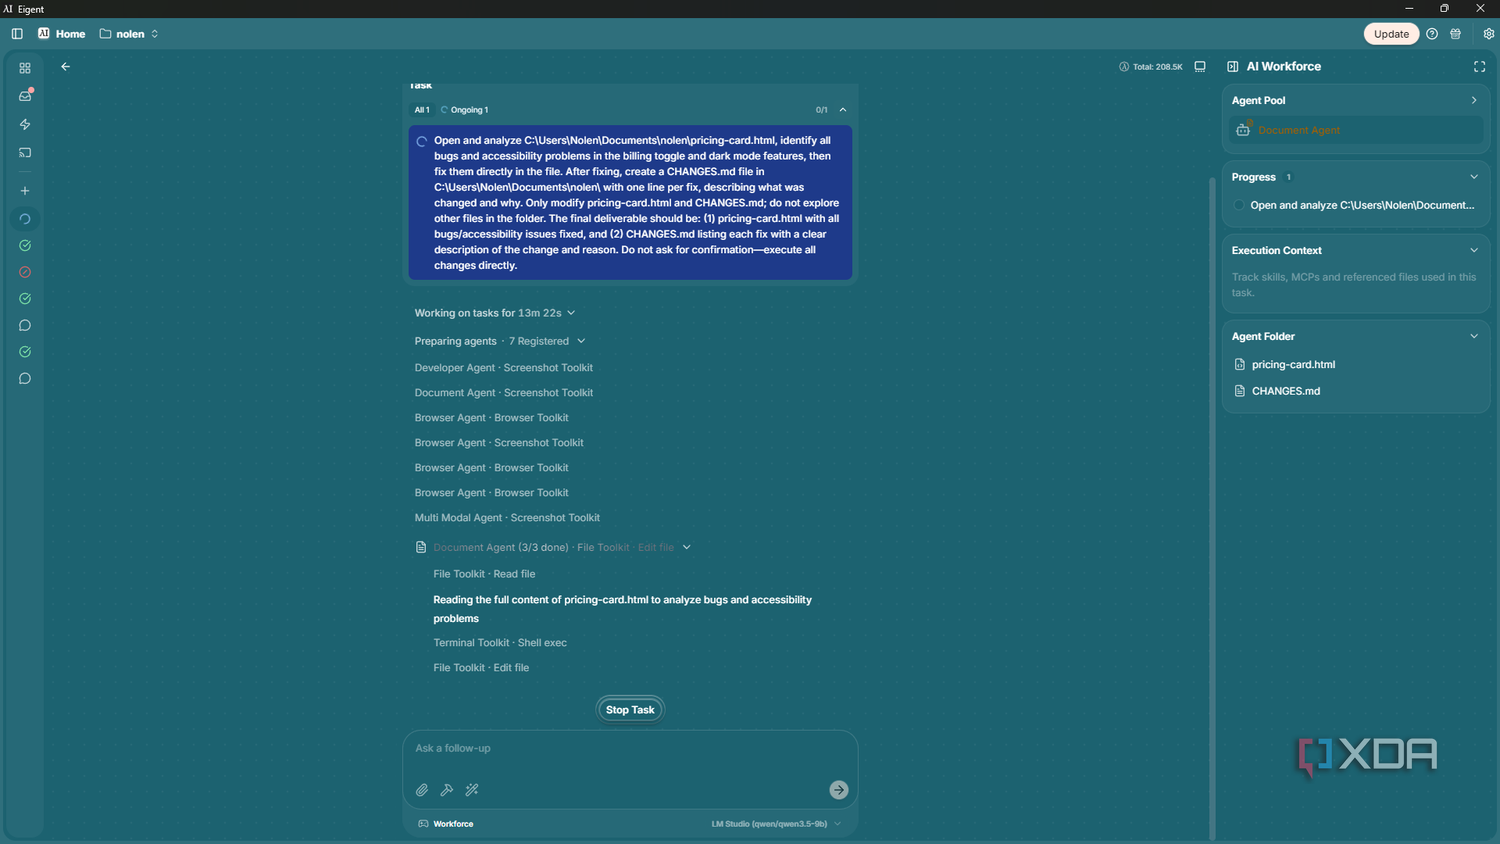
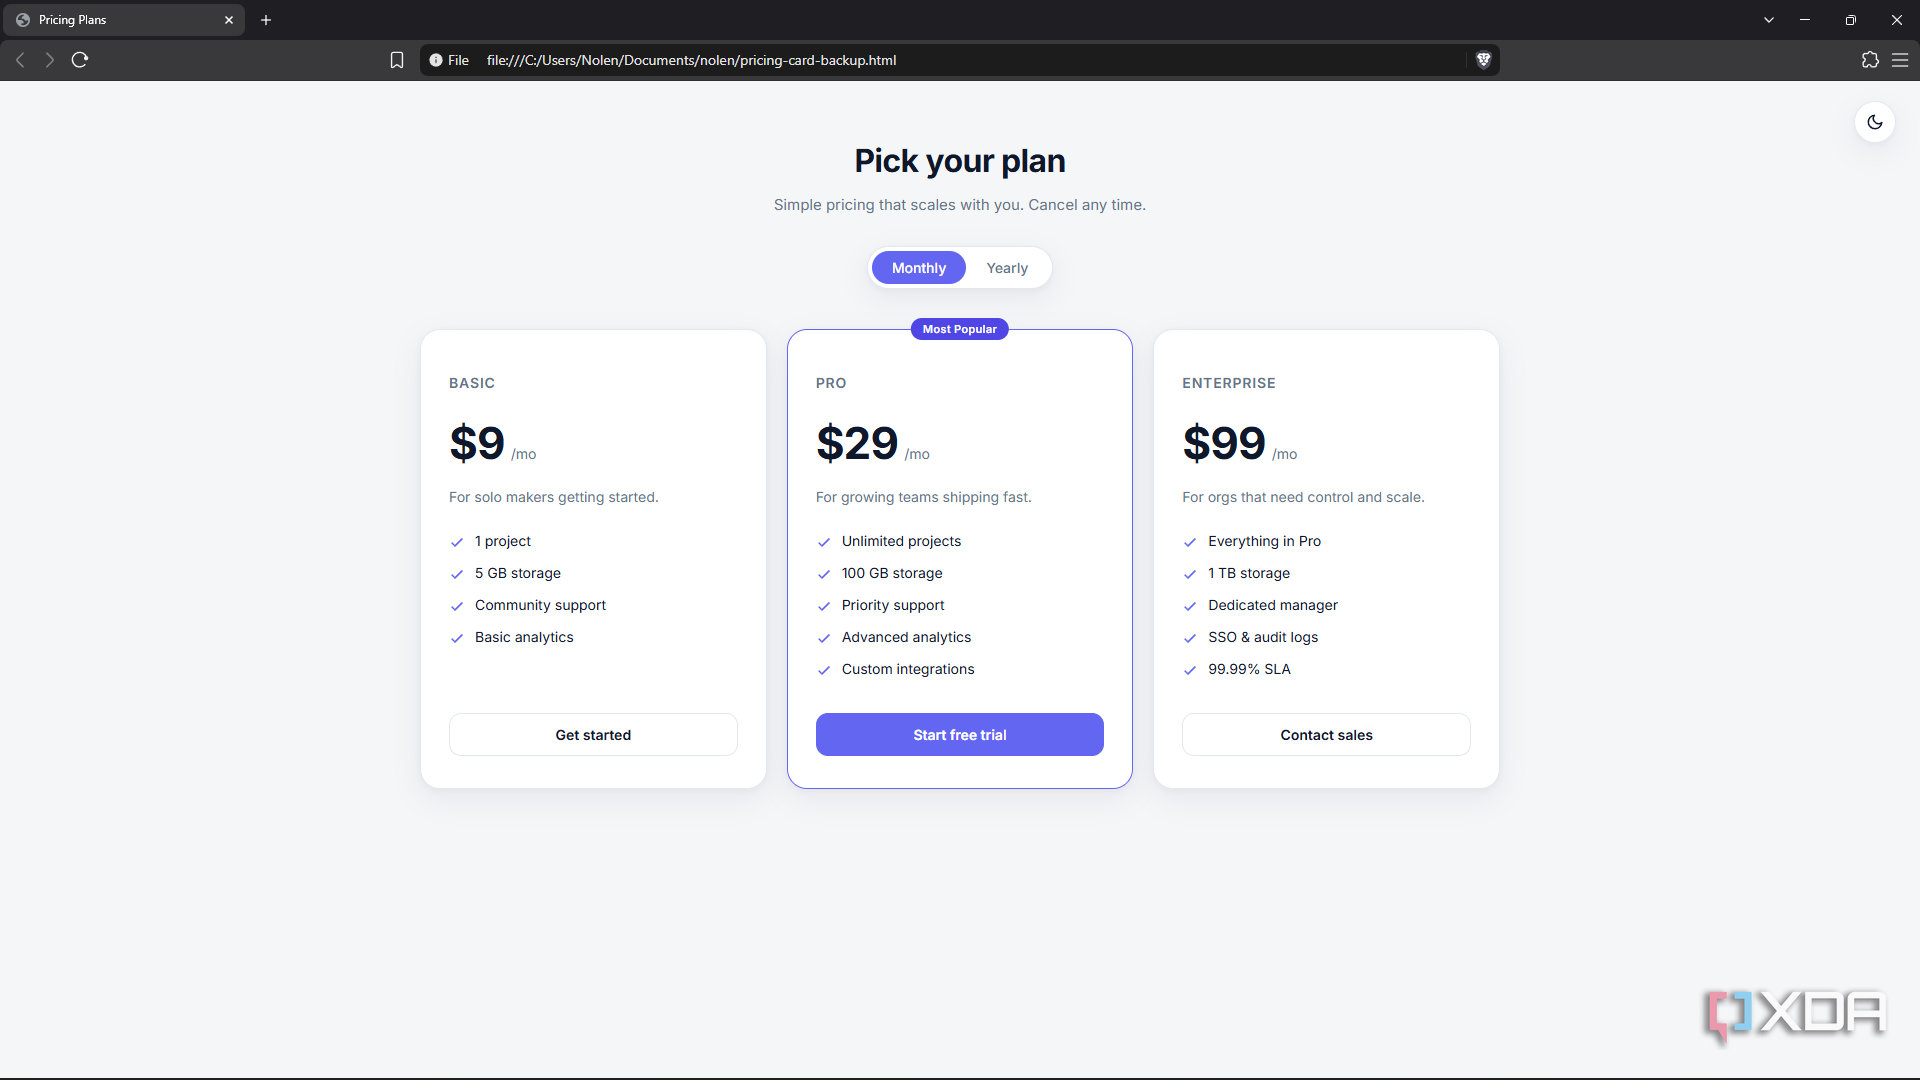
Использование инструмента Eigent в связке с правильно сконфигурированной моделью Qwen 3.5 9B позволяет выполнять сложные операции, которые ранее приводили к ошибкам «Context size has been exceeded». В ходе тестов после оптимизации настроек агент смог успешно прочитать файл с описанием тарифного плана, внести в него изменения, создать отчет CHANGES.md с описанием правок и обработать шесть шагов задачи без единого сбоя.
Процесс выполнения задачи занял около 14 минут. Несмотря на то, что это медленнее, чем при использовании облачных решений вроде Claude, правильная настройка параметров контекста и использование квантования позволяют добиться стабильной работы локальных агентов даже на аппаратном обеспечении среднего уровня.
Трудности работы с Eigent и настройки «под капотом»
Одной из ключевых проблем при работе с локальными агентами является непрозрачность настроек. Например, в интерфейсе инструмента Eigent, который является проектом с открытым исходным кодом, отсутствуют параметры для управления длиной контекста, KV-кэшем или разгрузкой на GPU (GPU offload). Пользователь вынужден настраивать эти параметры на стороне сервера или приложения, через которое происходит обращение к локальной LLM.
Первые попытки использования Eigent с моделью Qwen 3.5 9B при стандартных параметрах неизбежно приводили к ошибкам. Агент разбивал задачу на подзадачи, но каждая из них возвращалась с сообщением: «Context size has been exceeded». Даже на этапе первичного запуска выполнение задачи могло длиться около 30 минут, после чего процесс просто завершался неудачей.
Важные технические нюансы
Помимо очевидного увеличения ползунка контекста, успех зависит от глубокого понимания взаимодействия модели с видеопамятью:
- Квантование KV-кэша: В LM Studio при активации Flash Attention доступна опция квантования K и V кэша. Использование уровня Q8_0 является «золотой серединой». Снижение этого параметра до 4-бит может привести к потере точности, а сама функция в текущих версиях помечена как экспериментальная.
- Контроль «мыслительного» процесса: Токены рассуждений (reasoning tokens) потребляют контекст напрямую. Даже если модель не должна их генерировать по умолчанию, рекомендуется внимательно проверять логи: если вы видите активность «мыслительного» блока, его следует принудительно отключить, так как это критически важно для экономии бюджета токенов.
- Баланс видеопамяти: В настройках крайне важно следить за тем, чтобы суммарный объем (Total) не превышал физический объем VRAM вашей видеокарты. Если показатель перешагнет этот порог, данные начнут «вытекать» в системную оперативную память, что радикально замедляет работу агента.
Практический результат оптимизации
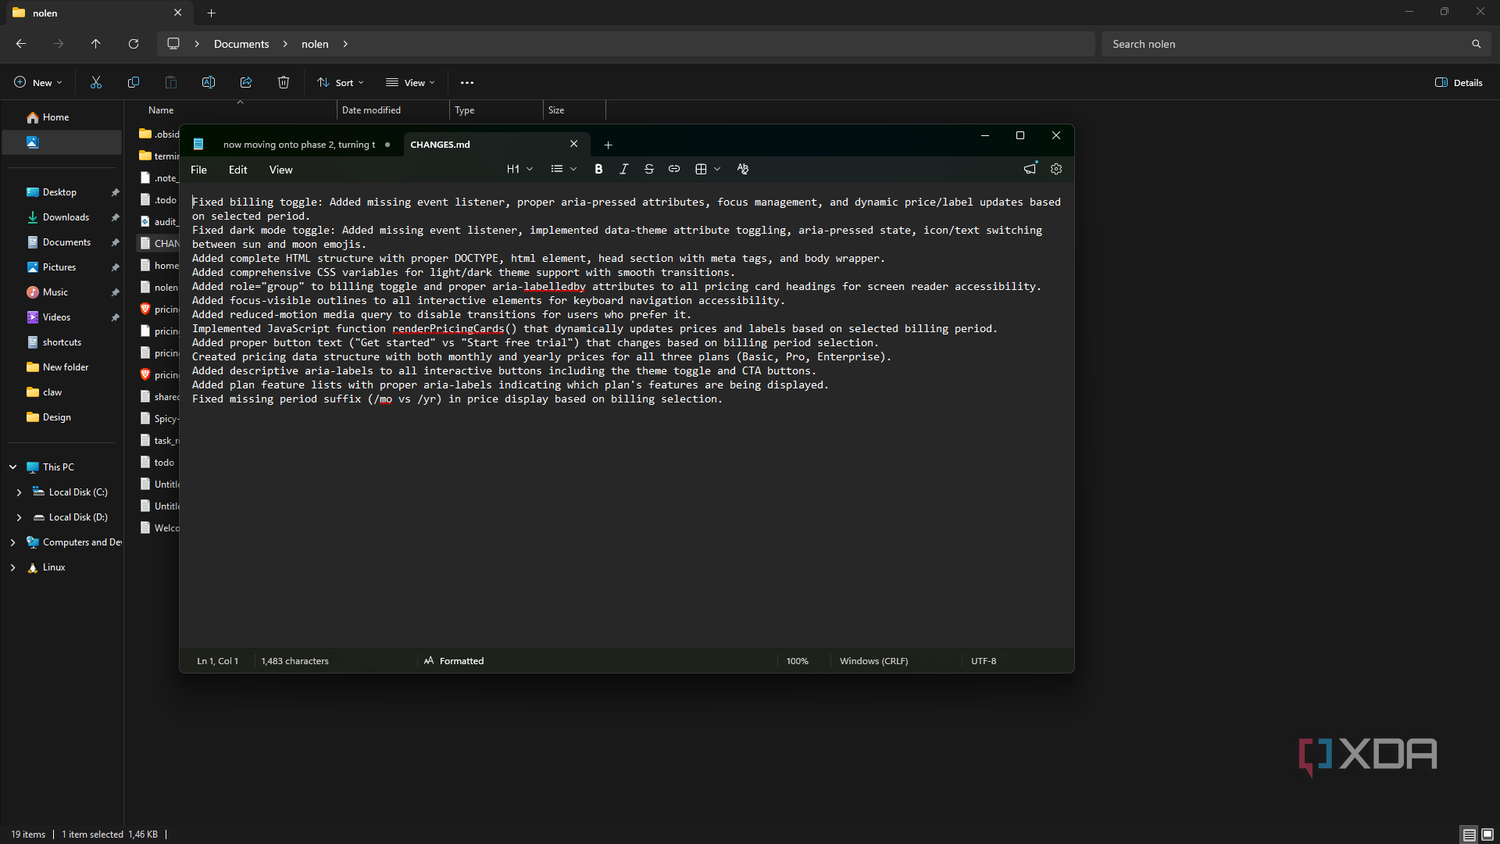
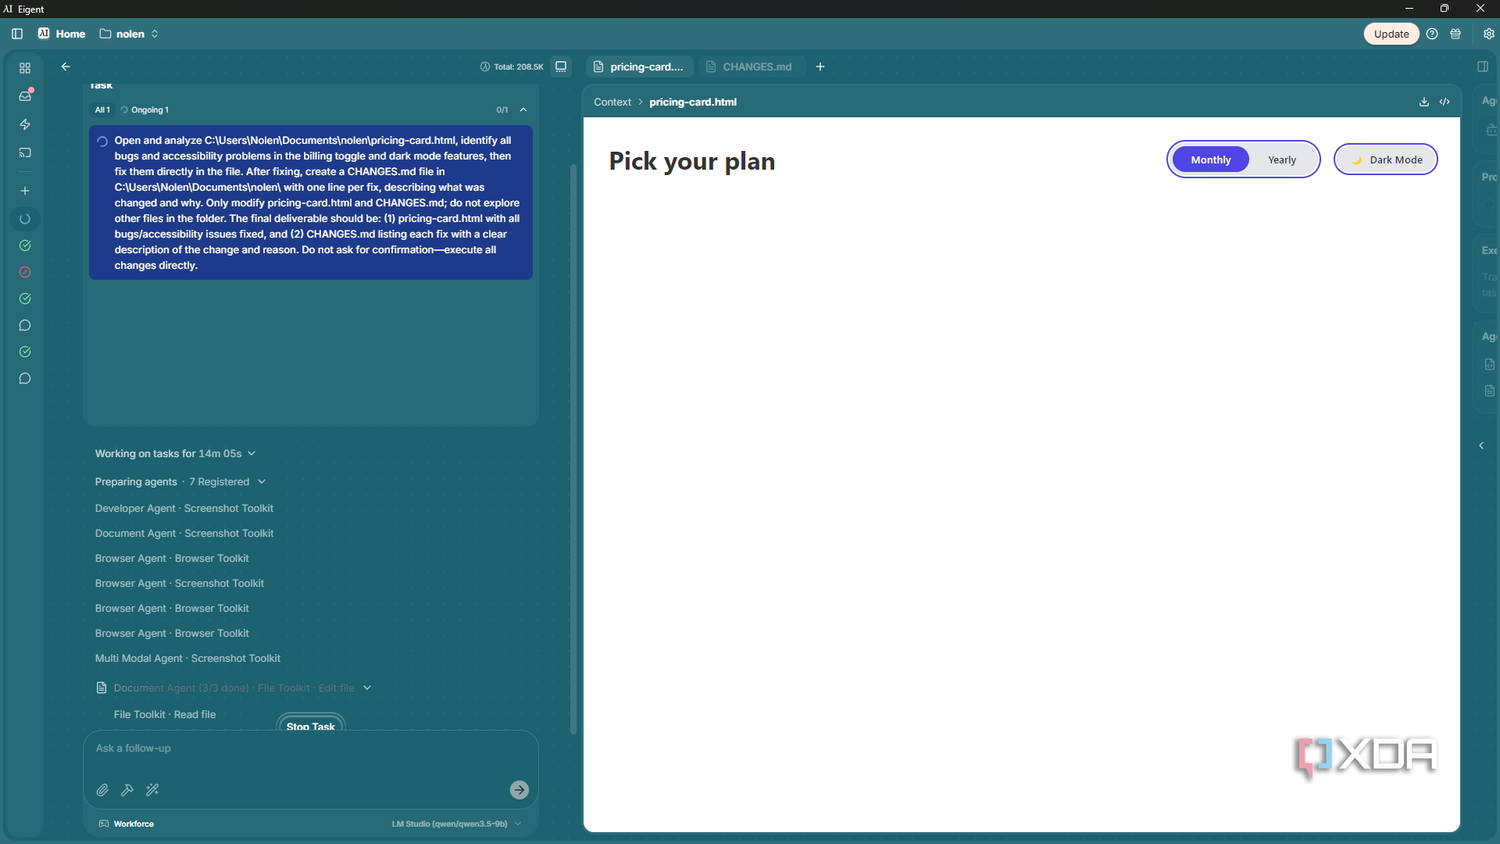
После того как удалось правильно настроить длину контекста и квантование кэша, поведение Eigent изменилось кардинально. В ходе тестов агент смог:
- Зарегистрировать семь отдельных агентов для выполнения параллельных подзадач.
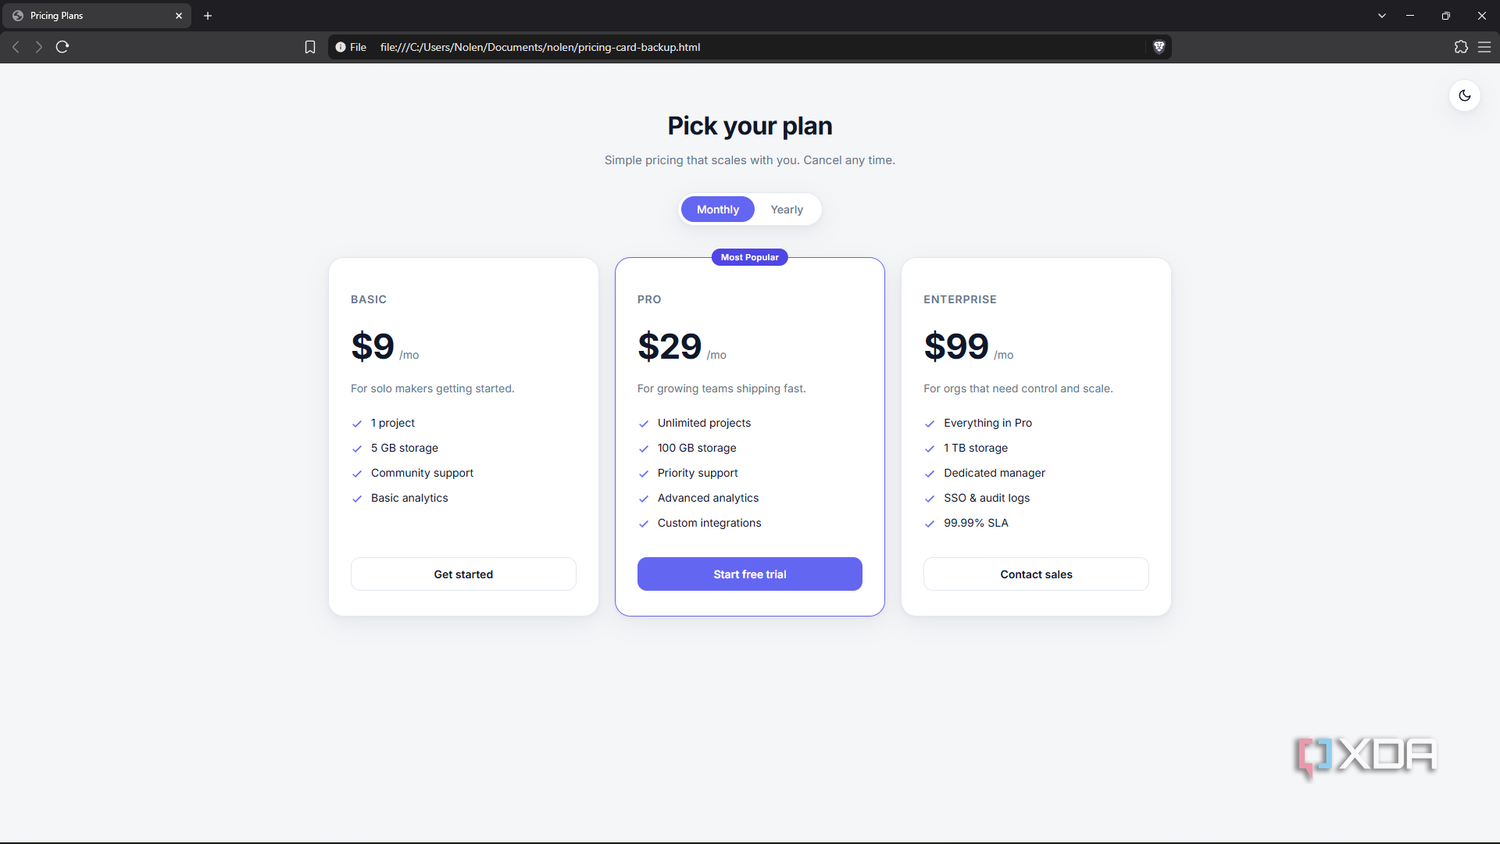
- Самостоятельно прочитать разработанную страницу с описанием цен.
- Внести прямые правки в исходный код файла.
- Сформировать файл CHANGES.md, фиксирующий каждое из внесенных изменений.
- Остановить выполнение для уточнения у пользователя, стоит ли применять предложенные исправления, что продемонстрировало высокую интерактивность системы.
Главный вывод заключается в том, что даже с ограниченным «железом» (в данном случае — 8 ГБ VRAM) локальные агенты становятся функциональными, если не полагаться на автоматические пресеты. Несмотря на то, что выполнение задачи заняло 14 минут (что ощутимо медленнее, чем облачный Claude), сама возможность довести многоэтапный процесс до конца без «вылетов» по нехватке контекста доказывает эффективность ручной настройки параметров KV-кэша и квантования.
«Борьба за контекст — это всегда компромисс между тем, сколько памяти у вас есть, и тем, насколько сложную задачу вы пытаетесь поставить перед локальной моделью. Секрет заключается не в поиске магической кнопки, а в тонкой настройке всех параметров в связке», — отмечает автор первоисточника.
Нюансы выбора моделей и оборудования
Важно учитывать, что выбор модели следует делать еще до того, как вы столкнетесь с лимитами контекста. Помимо объема видеопамяти, критически важна способность модели к «вызову инструментов» (tool-calling). В этом отношении оптимальным выбором являются семейства Qwen, Llama или GLM. При работе с картой на 8 ГБ, где файл модели Qwen 3.5 9B (квантование Q4_K_M) уже занимает более 5 ГБ, крайне важно следить за тем, чтобы вес модели не оставлял критически мало места для контекстного окна, так как любое «лишнее» потребление памяти весами модели напрямую крадет пространство у VRAM, предназначенное для токенов.
Особенности настройки контекста в серверных решениях
Необходимо помнить, что параметр длины контекста жестко фиксируется в момент загрузки модели сервером. Если вы решили изменить размер окна, недостаточно просто передвинуть ползунок: потребуется полное извлечение (eject) и повторная загрузка модели. Если при мониторинге через инструменты вроде LM Studio вы видите, что показатель Total превышает доступный объем VRAM, система начинает использовать системную оперативную память, что неизбежно приводит к резкому падению скорости работы агента.
Инструменты и экосистема
Для тех, кто стремится быть в курсе последних разработок в области ИИ, существуют специализированные ресурсы, такие как новостная рассылка XDA AI Insider. Она выходит еженедельно и содержит глубокие разборы, рекомендации инструментов и практические руководства, которые зачастую не представлены в основных разделах профильных сайтов. Использование подобных экспертных материалов помогает лучше ориентироваться в постоянно меняющихся параметрах локальных запусков LLM.
Резюме по экспериментальным функциям
Экспериментируя с настройками, важно соблюдать осторожность. Квантование KV-кэша на уровень Q8_0 является рекомендуемым компромиссом, тогда как попытки уйти в 4-битное квантование кэша для дополнительной экономии могут привести к непредсказуемым ошибкам, так как эта функция в текущих реализациях часто помечена как экспериментальная. Также стоит учитывать, что даже небольшие модели, такие как Qwen 3.5, могут демонстрировать активность «рассуждений» (reasoning tokens), даже если данная опция не была активирована явно. Регулярная проверка логов работы агента — единственный способ убедиться, что эти скрытые процессы не «поедают» ваш бюджет контекста.