Многие начинающие программисты часто бросают свои личные проекты, сталкиваясь с перфекционизмом и страхом нарушить профессиональные стандарты. Попытки сделать все идеально с самого начала приводят к лишним затратам времени и быстрому выгоранию. Однако существует подход, который может показаться непрофессиональным: намеренное написание «плохого» кода — поспешного, беспорядочного или даже ошибочного.
Обучение через ошибки и исследование границ
Практика написания некорректного кода помогает лучше усваивать новые инструменты и концепции. Когда разработчик намеренно допускает ошибки при изучении фреймворка или языка программирования, он видит, как именно система реагирует на неправильные действия. Это позволяет заранее обнаружить ловушки, в которые можно попасть при серьезной разработке.
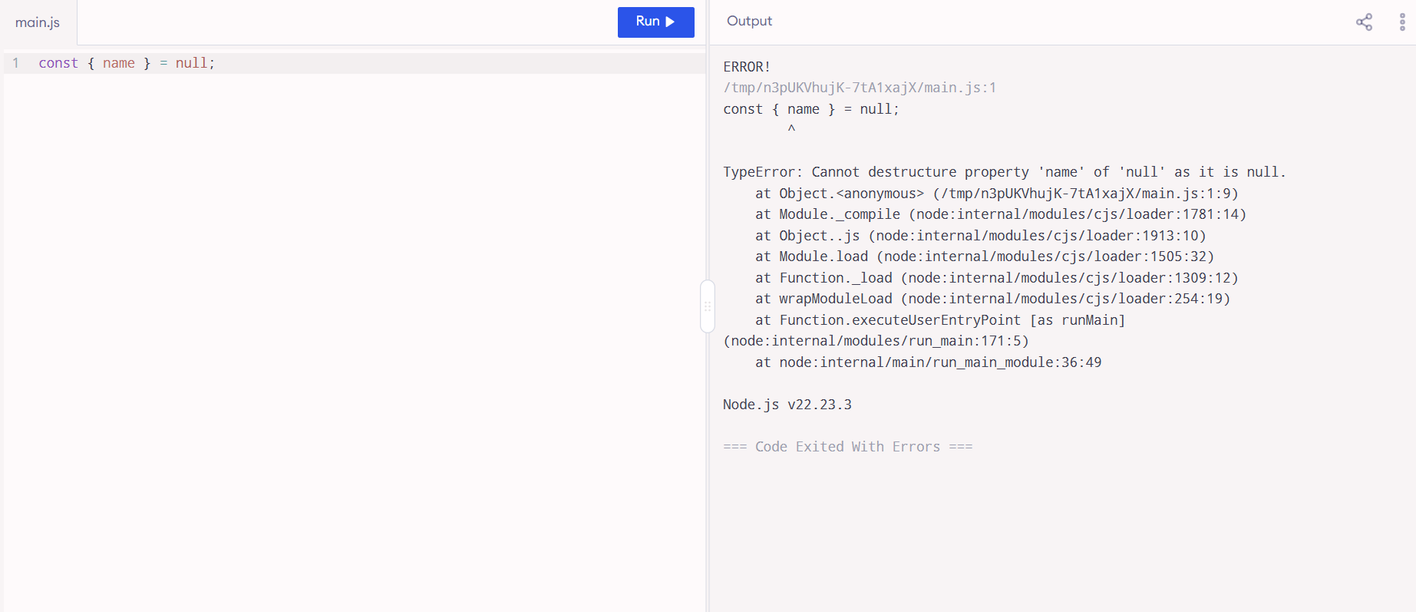
Например, в JavaScript часто возникают специфические ситуации. Ошибка при деструктуризации null выдает понятный тип исключения TypeError, который легко заметить. Однако при работе с методом sort() без передачи функции сравнения (a, b) => a — b, массивы вроде [10, 1, 2, 25] могут сортироваться не так, как ожидает новичок, поскольку значения сравниваются как текст. Столкновение с такими «тихими» ошибками в процессе экспериментов предотвращает их появление в будущем.
Когда принципы чистого кода становятся помехой
Принципы вроде SOLID или использование паттерна «Фабричный метод» являются ценными для профессиональных команд, работающих над крупными проектами. Однако для начинающих разработчиков, которые создают простые приложения, строгое следование этим правилам может стать барьером. Важно понимать, для кого написаны эти рекомендации.
В книге «Программист-прагматик» (The Pragmatic Programmer) отмечается, что прототипирование создает код, который со временем может быть выброшен. Если вы работаете над личным проектом в выходные, не обязательно придерживаться строгих инженерных стандартов. Если код не является частью основной системы и его не будут поддерживать другие люди, жесткое соблюдение правил чистоты может замедлить процесс.
Роль искусственного интеллекта в разработке
Развитие нейросетей и LLM-инструментов привело к распространению «вайб-кодинга» (vibe coding) и разработки с помощью ИИ. Это позволило еще сильнее ускорить процесс написания неидеального кода. Использование ИИ дает два преимущества: возможность быстро генерировать функционал без предварительной очистки и делегирование исправления огрехов самим нейросетям.
Тем не менее, этот метод не является безотказным. Автор столкнулся с проблемой, когда слепая генерация тысяч строк кода через ИИ привела к трудноуловимым багам. При возникновении ошибки стандартный запрос к ИИ с просьбой починить код часто оказывался неэффективным. В результате пришлось самостоятельно разбираться в структуре данных и логике взаимодействия компонентов, что потребовало значительных усилий.
Итоги: баланс между скоростью и качеством
Написание плохого кода не делает разработчика хуже. Напротив, это развивает понимание того, когда можно допустить упрощения, а когда необходима тщательная организация. Ключевой урок заключается в том, что хотя «грязный» код экономит время на этапе создания, в долгосрочной перспективе важно уметь отличать прототип от системы, требующей серьезного подхода. Опыт показал, что гораздо эффективнее разрабатывать функции последовательно и тестировать каждую из них, а «полировать» только то, что действительно останется в проекте.
Исследовательский аспект: обучение через намеренную ошибку
Метод намеренного написания «неправильного» кода имеет под собой определенное научное обоснование. В исследовании 2022 года было замечено, что учащиеся, которые сначала осознанно формировали ошибочные определения, а затем исправляли их, показывали лучшие результаты в тестах по сравнению с теми, кто просто копировал верные формулировки. Хотя попытка воспроизведения этого исследования в 2024 году не подтвердила аналогичный эффект, и ни одно из этих изысканий не было сфокусировано непосредственно на программировании, сам подход остается крайне эффективным инструментом в арсенале разработчика. Экспериментируя с поведением инструментов без защитных механизмов, вы получаете возможность «нащупать» границы их работы.

Для программиста, изучающего промежуточные концепции JavaScript, это особенно актуально. Например, работа с деструктуризацией может быть капризной: при попытке выполнить const { name } = null; интерпретатор мгновенно выбрасывает ошибку TypeError: Cannot destructure property ‘name’ of ‘null’ as it is null. Это пример «дружелюбной» ошибки, которую невозможно проигнорировать. Однако гораздо опаснее скрытые проблемы, такие как [10, 1, 2, 25].sort();, результат которого будет [ 1, 10, 2, 25 ]. Здесь нет ни предупреждений, ни исключений — JavaScript по умолчанию воспринимает значения как строки, поэтому «10» встает перед «2». Именно такие ситуации приучают разработчика к необходимости использования функции сравнения (a, b) => a — b. Столкновение с подобными «тихими» багами в учебных целях — лучший способ навсегда запомнить, почему нужно следовать определенным стандартам.
Прототипирование и «трассировочный код»
В контексте обсуждения чистоты кода важно различать типы создаваемых артефактов. В книге «Программист-прагматик» (The Pragmatic Programmer) авторы проводят четкую грань между прототипами, которые представляют собой разовый, «одноразовый» код, и так называемым «трассировочным кодом» (tracer code). В то время как прототип предназначен для проверки гипотезы и выбрасывается после достижения понимания, трассировочный код остается в конечном проекте и становится его фундаментом. Ошибка многих начинающих — попытка писать сразу «продакшн-код», даже для прототипа. Если ваша задача — проверить концепцию в рамках небольшого личного проекта на выходных, отказ от строгих инженерных принципов может сократить время реализации с месяца до двух недель или меньше.
Ловушки «вайб-кодинга» с ИИ
С развитием LLM-инструментов привычка писать плохой код достигла своего пика, но здесь кроется скрытая угроза. Работая с ИИ, легко впасть в иллюзию продуктивности: вы даете минималистичные промпты, не задавая правил качества, и получаете рабочий, но низкокачественный результат. Поначалу делегирование исправления огрехов самим нейросетям кажется идеальным решением, но этот план не является безотказным.
На практике слепая генерация кода приводит к созданию тысяч строк, где логика взаимодействия компонентов и потоки данных становятся непрозрачными. В итоге, когда возникает баг, который ИИ не может исправить стандартным запросом, разработчик оказывается один на один с «грязным» кодом. В такие моменты становится очевидно: если вам придется поддерживать и читать этот код в будущем, гораздо выгоднее потратить время на написание качественного решения сразу. Написание плохого кода оправдано лишь тогда, когда вы точно знаете, что этот фрагмент будет переписан или удален. Золотое правило «если работает — не трогай» для автора статьи остается лишь мемом: плохой код не делает вас лучшим программистом, он делает вас лишь быстрее на короткой дистанции, при условии, что вы понимаете, когда эта скорость превращается в технический долг.