После создания локальной рабочей станции для работы с искусственным интеллектом на базе устаревшей видеокарты GTX 1080 я протестировал задачи вывода больших языковых моделей на самых разных устройствах. Мощные видеокарты с большой видеопамятью и устройства с NPU подходят лучше всего для подобных задач, однако сетевое хранилище NAS изначально казалось слишком слабым для запуска локальных LLM. Тем не менее, правильная переработка сценариев использования и настройка автоматизации позволили мне интегрировать NAS в повседневную работу с искусственным интеллектом.

Особенности архитектуры и производительность линейки Gemma 4
Принято считать, что модели с количеством параметров менее 9 миллиардов обладают крайне ограниченными возможностями рассуждения. Однако линейка Gemma 4 представляет собой исключение из этого правила благодаря уникальной архитектуре, несмотря на небольшой объем. На практике модель Gemma-4-E2B имеет 5,1 миллиарда параметров в общей сложности, а версия Gemma-4-E4B насчитывает 8 миллиардов. При этом эффективные параметры, задействованные непосредственно в вычислениях, составляют 2,3 миллиарда для E2B и 4,5 миллиарда для E4B. Остальные параметры хранятся в специализированных таблицах токеновых встраиваний на основе поуровневых эмбеддингов, что ускоряет простой поиск и трансформации без чрезмерного расхода оперативной и видеопамяти.
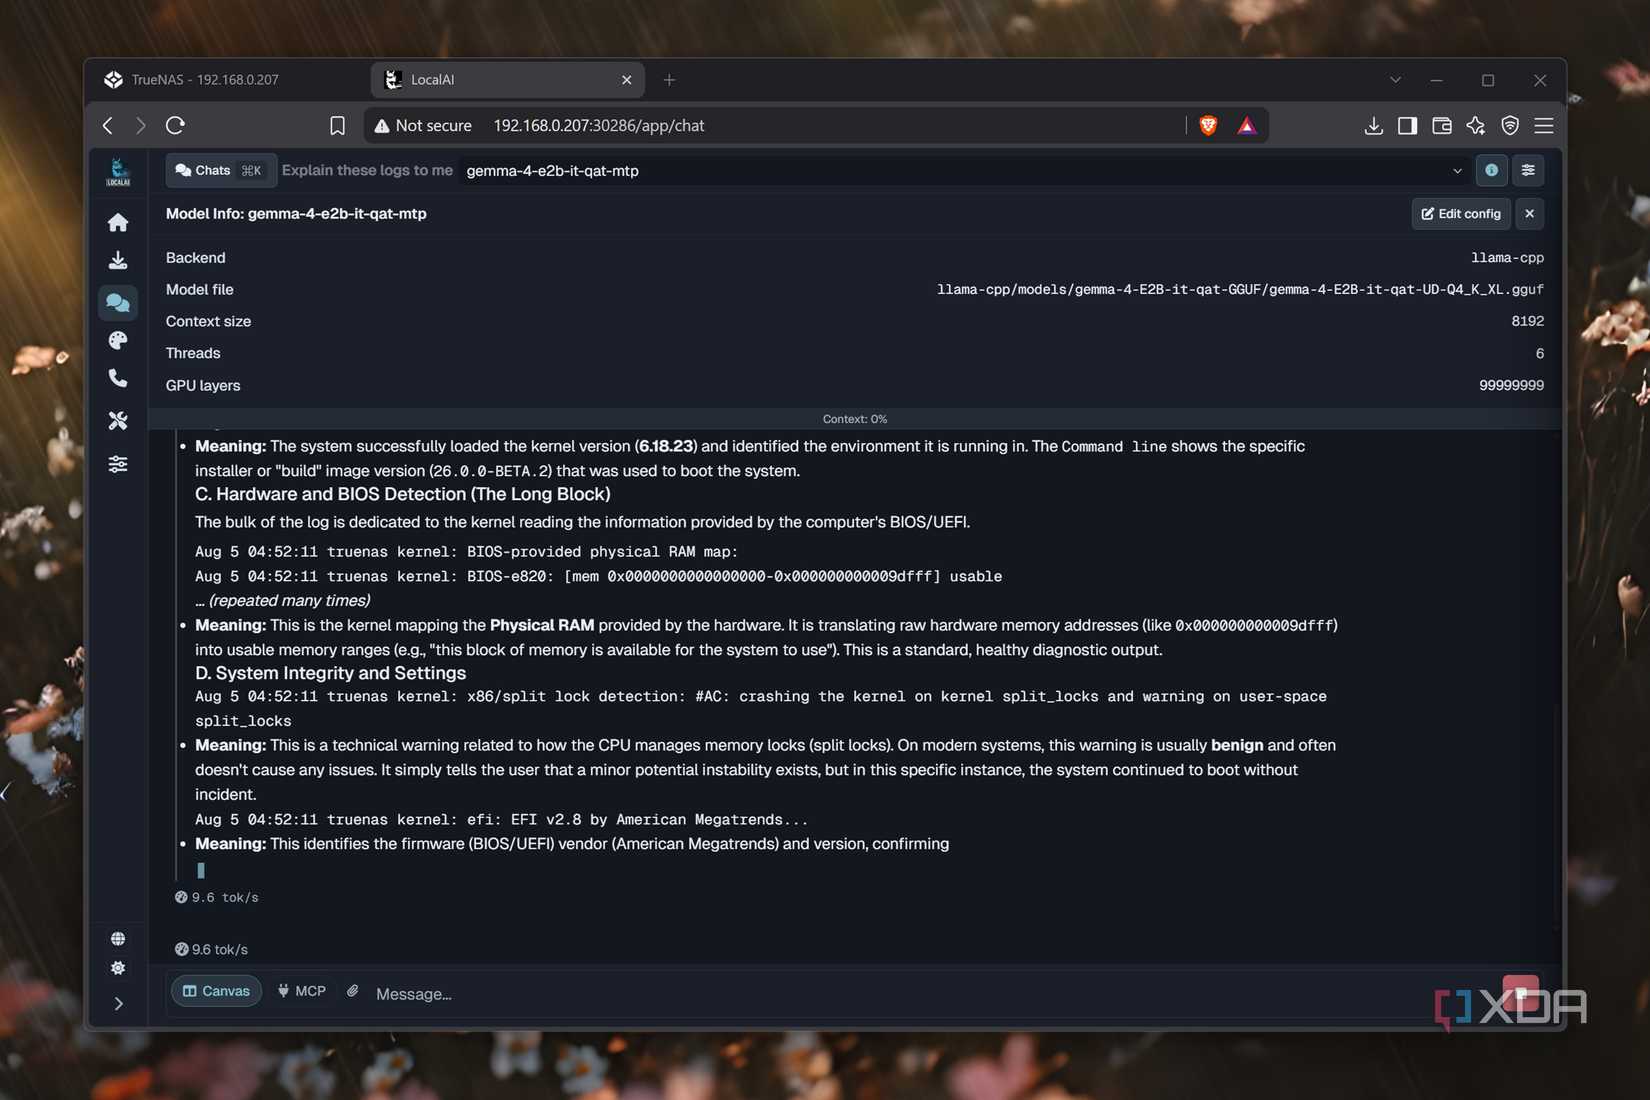
Обе модели поддерживают работу с изображениями, что делает их удобными для анализа визуального контента. В результате Raspberry Pi 5 обеспечивает скорость около 5,8–6,5 токенов в секунду на модели Gemma-4-E2B, тогда как сетевое хранилище с процессором i5-1235U достигает более 10,5 токенов в секунду при базовых вычислениях. Версия Gemma-4-E4B на том же NAS работает медленнее — со скоростью 4–5 токенов в секунду, чего недостаточно для интерактивных запросов, требующих немедленного ответа.
Фоновые рабочие процессы и оптимизация задач на сервере
Низкая скорость генерации на NAS заставила меня пересмотреть сценарии использования языковых моделей. Для мгновенных ответов в кодинге и интерактивных приложениях задействован экземпляр Qwen3.6-35B-A3B на видеокарте RTX 3080 Ti с разгрузкой смеси экспертов. В то же время легкие версии Gemma 4 на сетевом хранилище были перенаправлены на вспомогательные задачи в приложениях повышения продуктивности, которые могут работать в фоновом режиме.
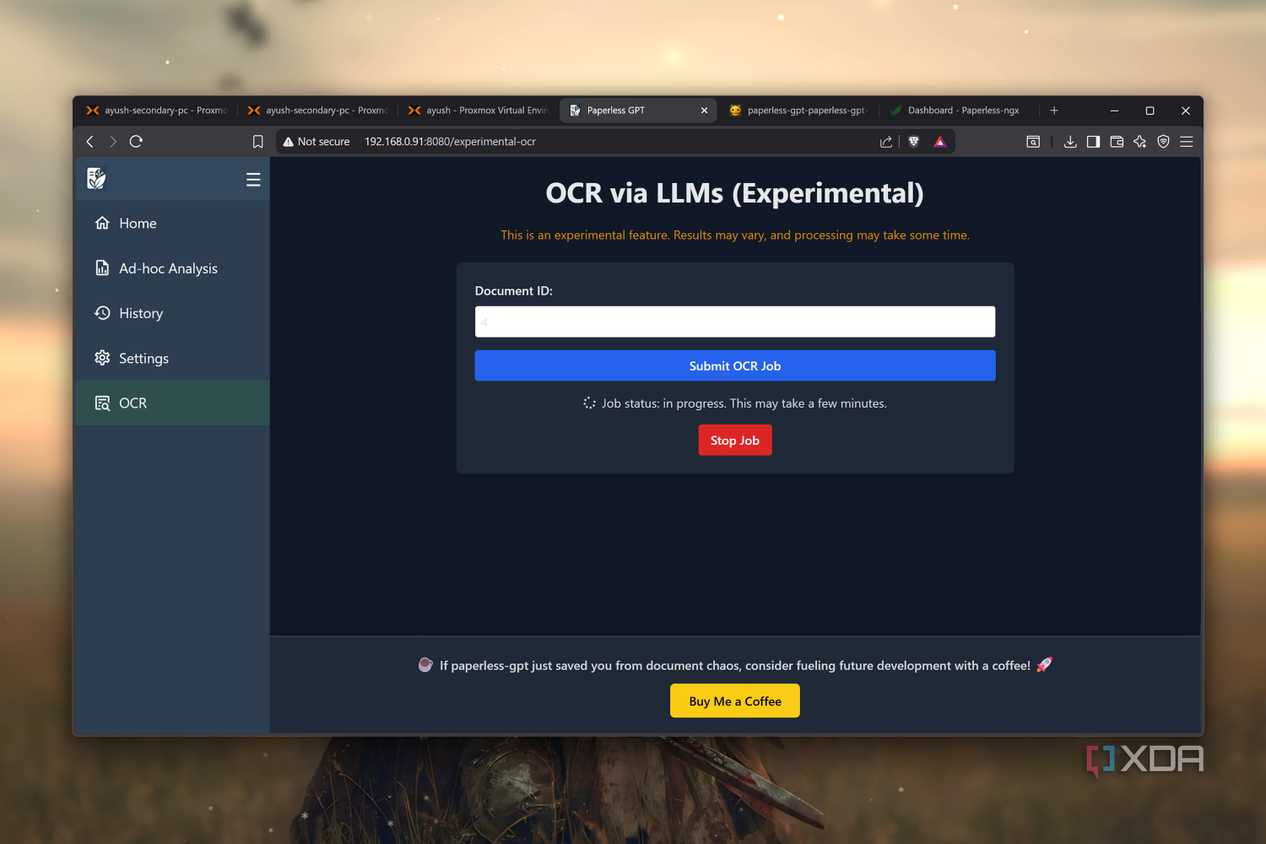
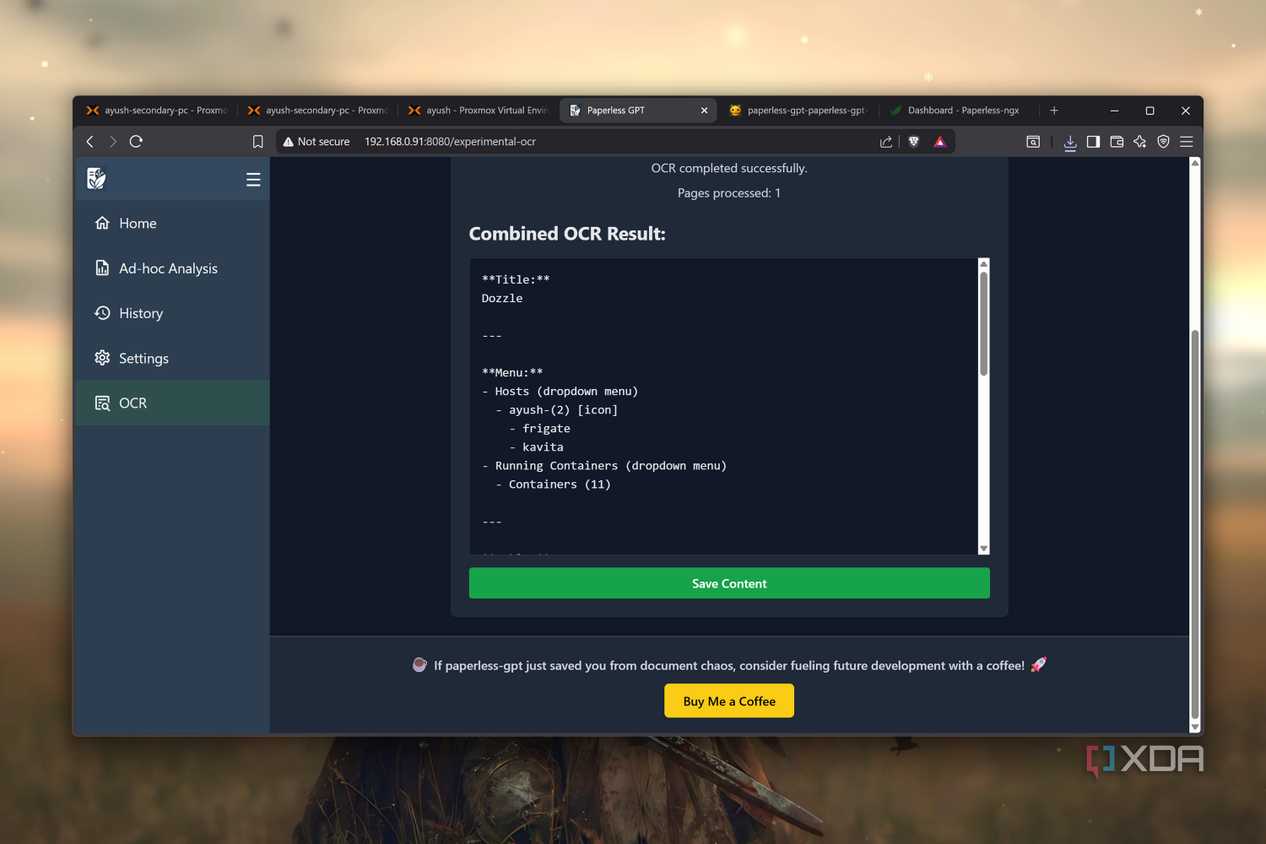
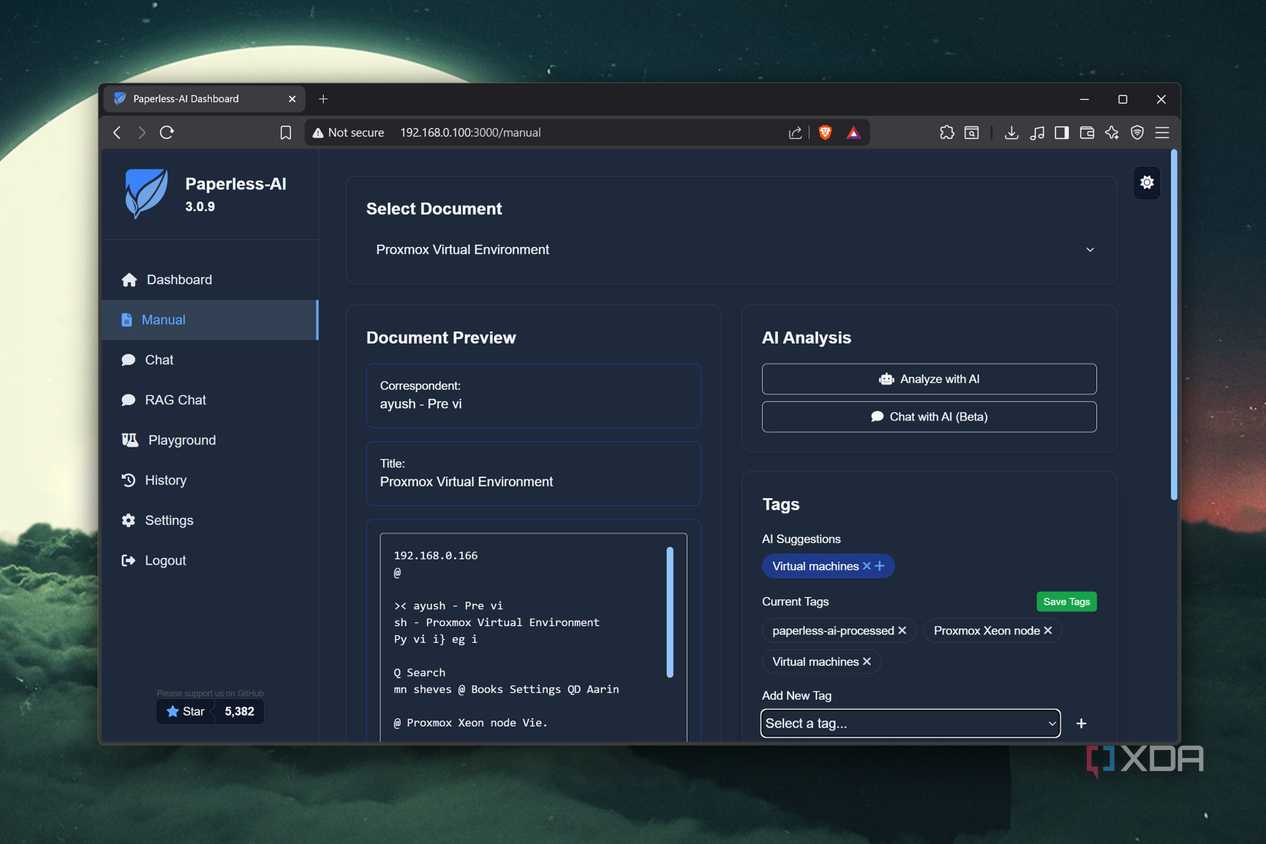
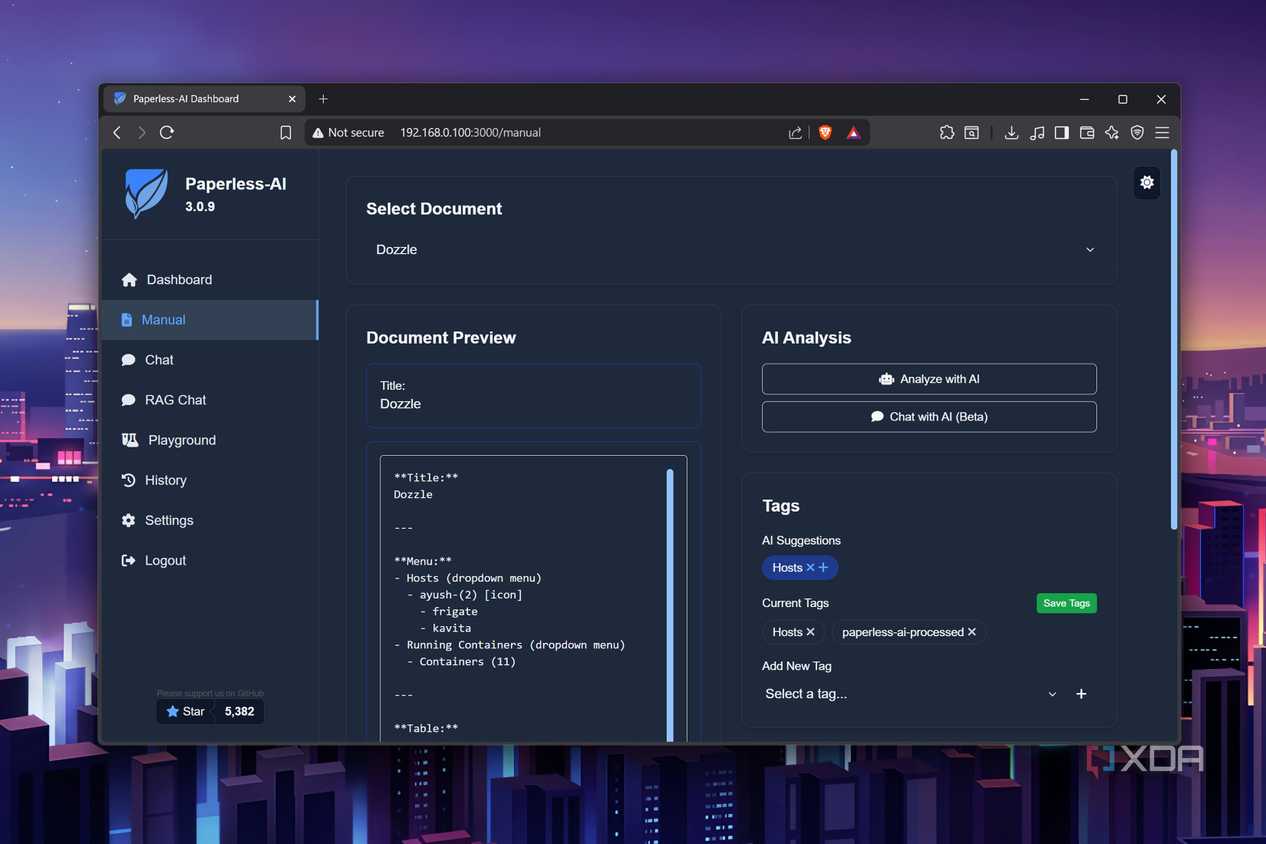
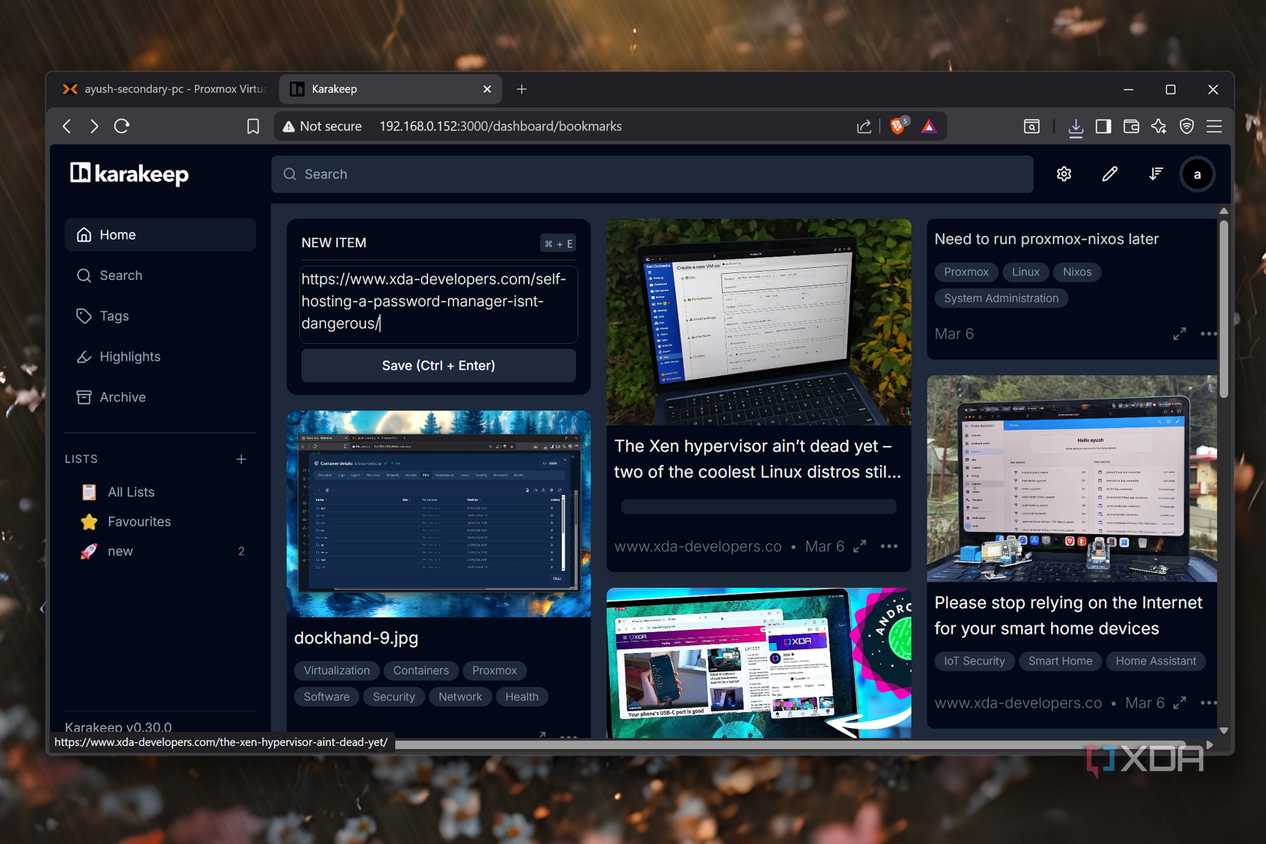
Ярким примером служит конвейер Paperless-ngx совместно со вспомогательными сервисами Paperless-GPT и Paperless AI, которые выполняют ресурсоемкие задачи оптического распознавания символов и автоматического тегирования документов. Поскольку в систему архивируются квитанции, счета, финансовые отчеты и академические записи, требующиеся лишь спустя месяцы, скорость обработки около 10 токенов в секунду не создает неудобств. Аналогичным образом веб-страницы, PDF-файлы и видеоролики с YouTube автоматически суммируются и маркируются в приложении Karakeep, а идеи в контейнере Blinko успевают получить теги к моменту их детального изучения.
Размещение моделей эмбеддингов на сетевом хранилище
Помимо запуска языковых моделей Gemma 4, мое сетевое хранилище выполняет еще одну важную роль в домашней лаборатории, размещая модели эмбеддингов. На сервере развернуты nomic-embed-text-v1.5 и nomic-embed-vision-v1.5, которые дополняют крупные модели со смесью экспертов на базе видеокарты RTX 3080 Ti. Эти компоненты преобразуют текстовые документы и изображения в векторные представления.
Приложения с поддержкой генерации с дополненной выборкой используют созданные числовые векторы для поиска исследовательских заметок, наиболее близких по смыслу к конкретным запросам. Полученные данные передаются в основные модели, что помогает существенно снизить вероятность появления галлюцинаций в ответах искусственного интеллекта.
Проводя собственные эксперименты, я протестировал самые разные устройства: от игровых систем до миниатюрных одноплатных компьютеров и устаревших мобильных телефонов. Ранее я также проводил эксперименты с агентами на базе Raspberry Pi прошлым летом, сталкиваясь с галлюцинациями у моделей размером от 0.5B до 4B, однако новые архитектурные решения кардинально изменили ситуацию.
Дополнительные параметры в моделях линейки Gemma хранятся в специальных таблицах токеновых встраиваний (Per-Layer Embeddings), которые существенно помогают при быстром поиске и простых трансформациях данных.
Что касается конкретных показателей производительности на различном железе, моя Raspberry Pi 5 стабильно выдает 5,8–6,5 токенов в секунду на модели Gemma-4-E2B. В свою очередь, NAS на процессоре i5-1235U справляется с простыми задачами вывода на этой же модели со скоростью более 10,5 токенов в секунду, тогда как более тяжелая Gemma-4-E4B на этом же хранилище демонстрирует скорость в пределах 4–5 токенов в секунду.
Поскольку такая скорость оказалась слишком низкой для интерактивных запросов, когда пользователь отправляет промпт во фронтенд и рассчитывает на мгновенный отклик, я полностью пересмотрел подход к нагрузкам. Вместо ожидания результатов в реальном времени я оставляю задачи вывода запущенными на всю ночь.
Для моментальных задач и написания кода у меня задействована связка с моделью Qwen3.6-35B-A3B, работающей через распределение смеси экспертов (MoE offloading) на видеокарте RTX 3080 Ti.
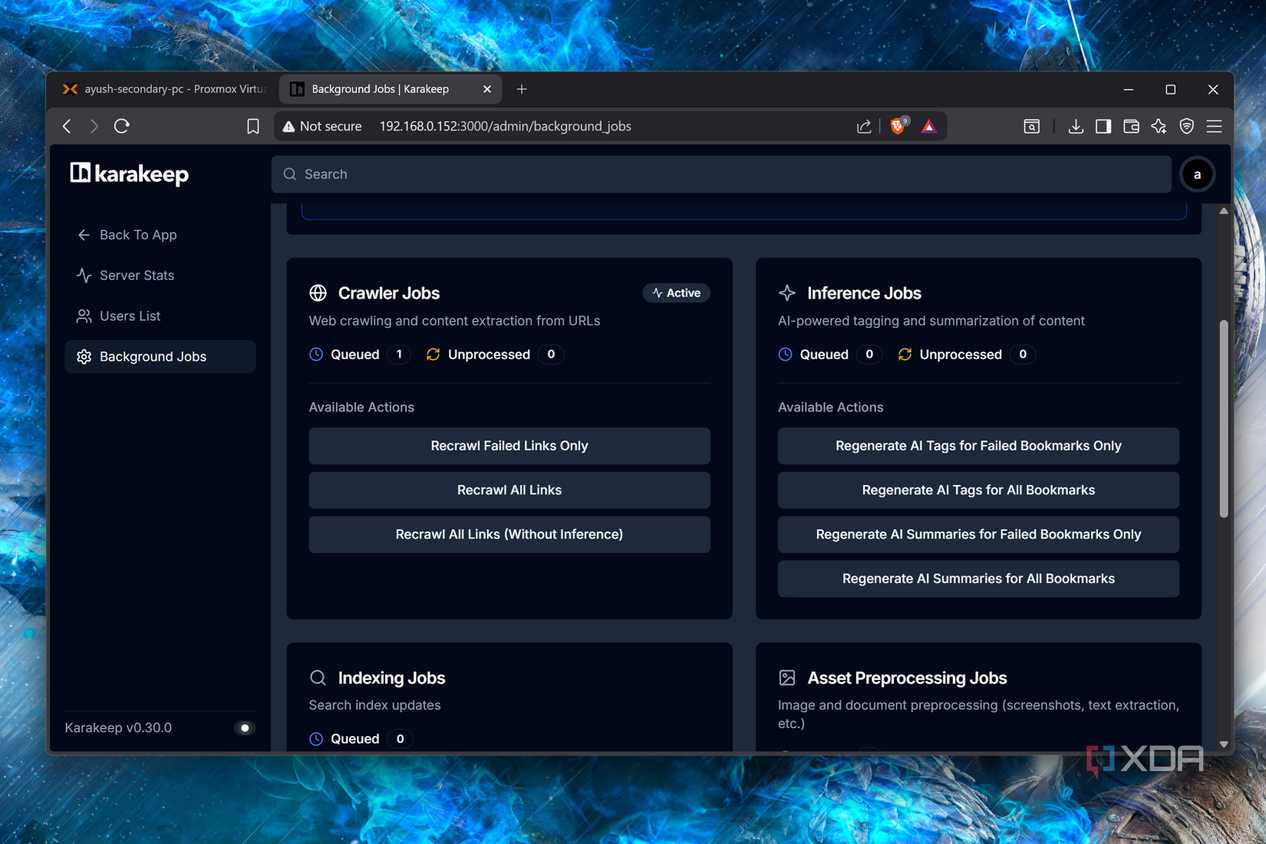
В архив Paperless-ngx я обычно загружаю счета, академические записи, финансовые отчеты и инвойсы, которые могут понадобиться спустя месяцы. Аналогичным образом контейнер Karakeep используется для сохранения веб-страниц, документов формата PDF и видеороликов с YouTube, которые обрабатываются в фоновом режиме, пока я занимаюсь другими делами. Свои случайные идеи я точно так же закидываю в контейнер Blinko, и к моменту, когда появляется свободное время для их анализа, ультралегкая модель успевает автоматически проставить к ним все необходимые теги.
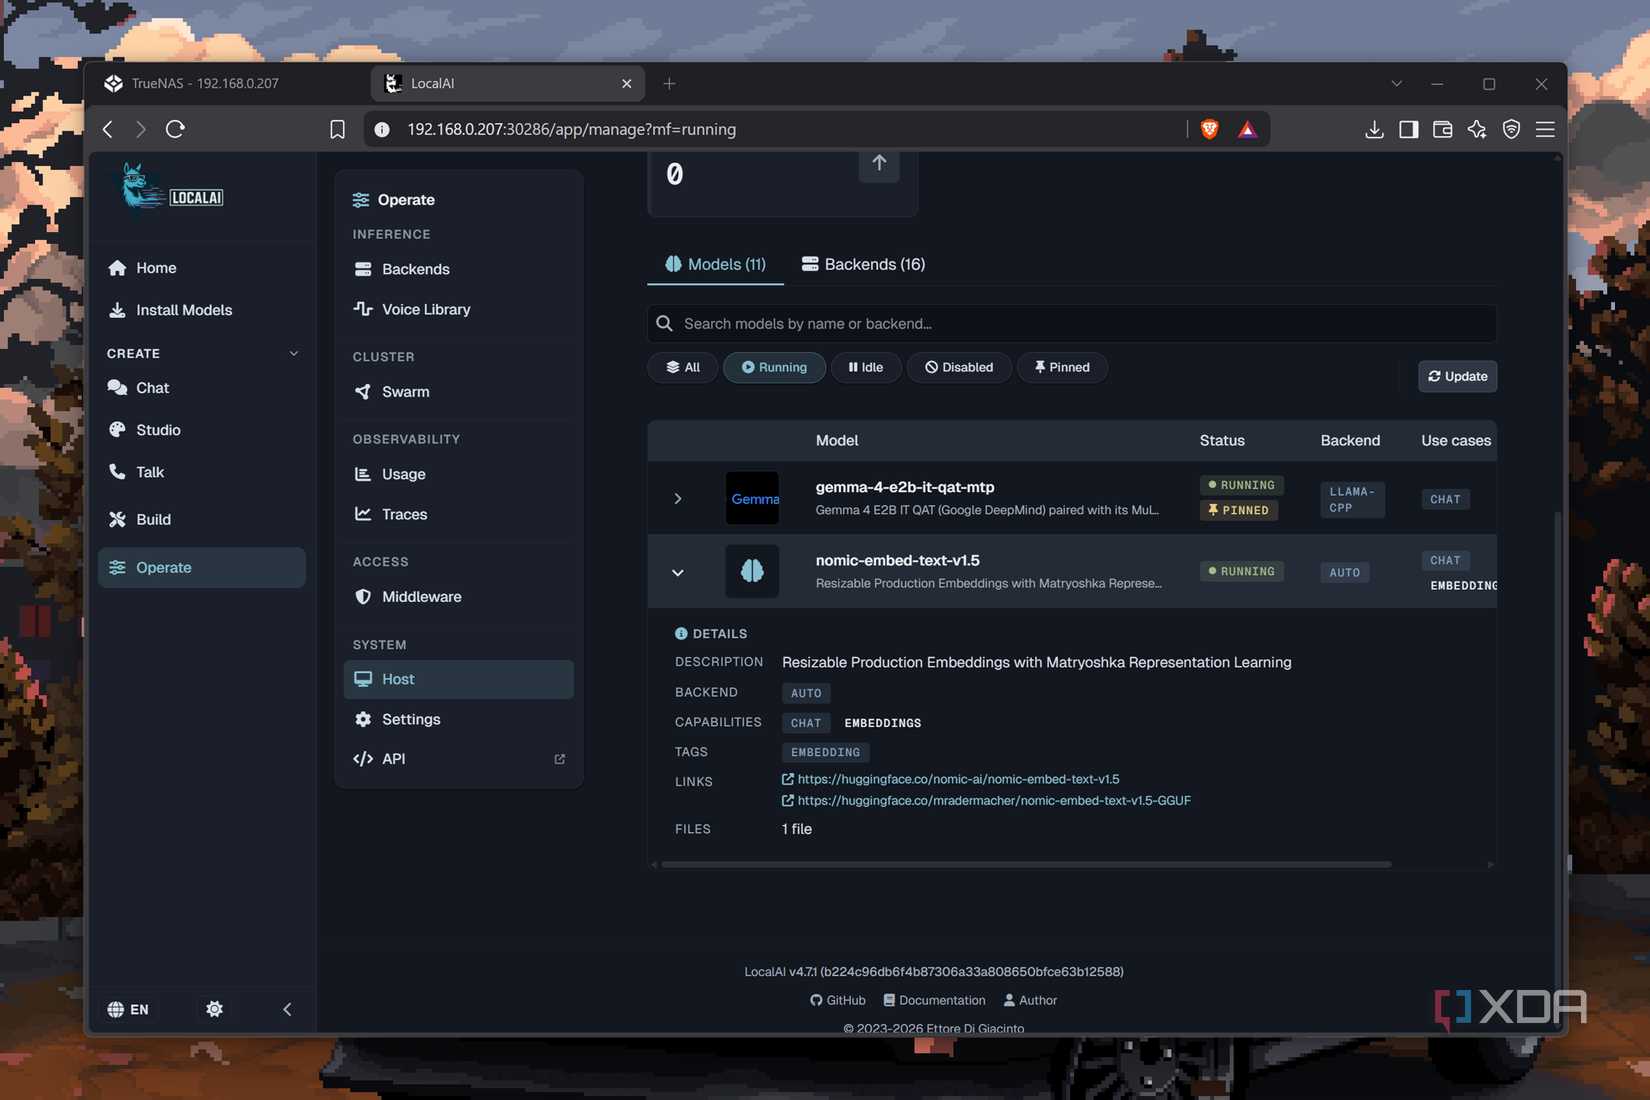
Модели эмбеддингов, такие как nomic-embed-text-v1.5 и nomic-embed-vision-v1.5, преобразуют обычные текстовые документы и изображения в точные векторные отображения. Например, мой контейнер Open Notebook задействует числовые векторы от nomic-embed-text-v1.5 для поиска заметок с исследованиями, максимально близких к текущим пользовательским запросам, перед тем как передать их в основные MoE-модели.