Директор по инжинирингу Canonical Жан-Батист Лальман анонсировал проект Myna — новую систему распознавания речи, которую планируется внедрить в Ubuntu Desktop. Инструмент предназначен для реализации голосового ввода текста и управления интерфейсом с помощью команд на естественном языке. В настоящее время исходный код проекта, распространяемого под лицензией GPLv3, содержит лишь прототипы архитектуры и планы интеграции с операционной системой.
Планы по внедрению и принцип работы
Разработчики поставили цель сделать приложение пригодным для полноценного использования к релизу Ubuntu 26.10. Механика работы Myna предполагает активацию через горячие клавиши: после запуска пользователь начинает диктовку, а распознанный текст автоматически подставляется в активное окно приложения посредством симуляции клавиатурного ввода. В процессе работы в системной панели будет отображаться индикатор активности микрофона. Хотя базовым окружением для тестирования выбран GNOME с поддержкой Wayland, архитектура системы закладывается как универсальная, что позволит адаптировать её под любые рабочие столы.
Конфиденциальность и локальная обработка
Ключевой особенностью Myna станет акцент на приватности — система использует исключительно локальные ИИ-модели, не требуя подключения к интернету. Основные требования к приложению включают:
- Активация микрофона строго по инициативе пользователя (через горячую клавишу).
- Обработка аудиоданных в оперативной памяти с её очисткой после завершения сессии.
- Полный запрет на отправку звуковых записей или распознанного текста во внешние облачные сервисы.
Техническая реализация
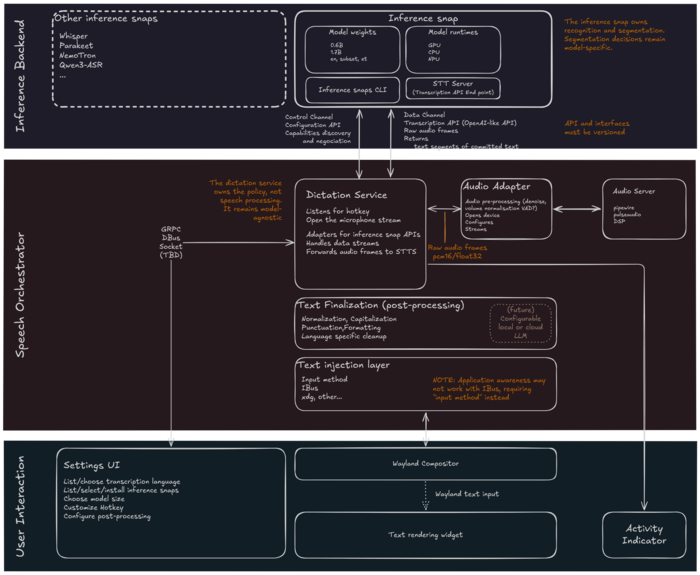
Myna строится по модульному принципу, где каждый компонент (распознавание, интерфейс, управление вводом) отвечает за свою задачу. Среда выполнения нейросетевых моделей будет поставляться в виде snap-пакета. На текущем этапе рассматриваются такие модели, как Whisper, Parakeet, NemoTron и Qwen3-ASR.
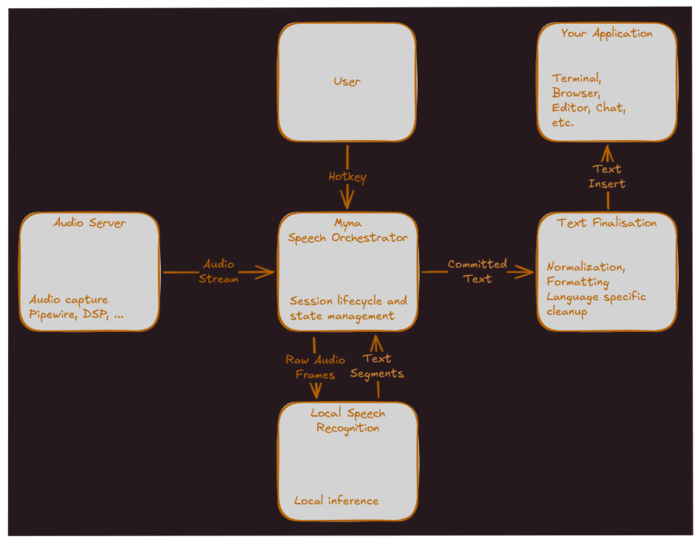
Процесс обработки данных выглядит следующим образом:
- Звуковой сервис: взаимодействует с микрофоном напрямую либо через PulseAudio/PipeWire, выполняя шумоподавление и нормализацию громкости.
- Сервис диктовки: координирует потоки данных, передавая звук в модель через API и получая готовый текст.
- Постобработка: модуль очищает полученный текст, приводит его к нужному формату и расставляет знаки препинания.
- Интеграция: готовый результат вставляется в систему с помощью протокола ввода Wayland (input-method) или iBUS.
В долгосрочной перспективе, после стабилизации функции диктовки, Canonical планирует расширить возможности Myna. В будущем система может превратиться в полноценного голосового ассистента, способного исполнять команды управления рабочим столом и выполнять синхронный перевод диктуемой речи.