

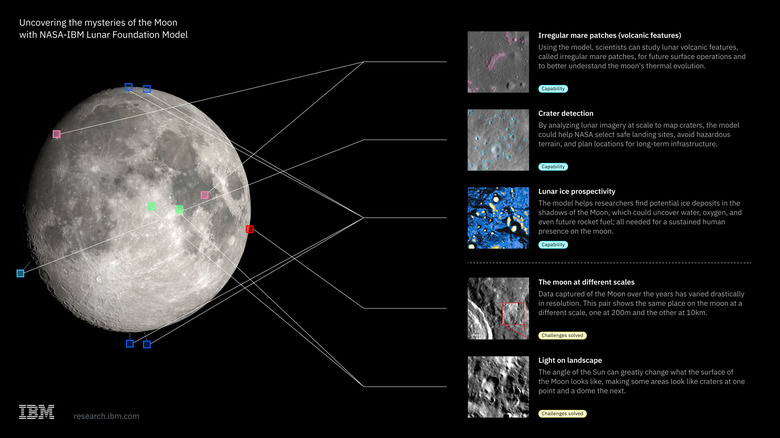
Космическое агентство NASA и корпорация IBM представили совместную разработку — NASA-IBM Lunar Foundation Model. Это открытая система на базе искусственного интеллекта, предназначенная для анализа лунной поверхности, которая уже доступна для загрузки на платформе Hugging Face. Как отметил доктор Хуан Бернабе-Морено, директор IBM Research Europe, создание этой модели стало важным шагом в поддержке будущих миссий программы Artemis.
Возможности ИИ в изучении лунного ландшафта
Первичные тесты показали высокую эффективность нейросети в задачах картографирования и анализа данных. Одной из ключевых функций модели стал поиск зон, где потенциально могут находиться запасы водяного льда. В ходе сравнительных испытаний разработчики сопоставили точность своей системы с показателями модели SwinV2-B — распространенного решения от Microsoft, используемого для обработки изображений высокого разрешения. Новая разработка NASA и IBM продемонстрировала снижение количества ошибок на 23%.
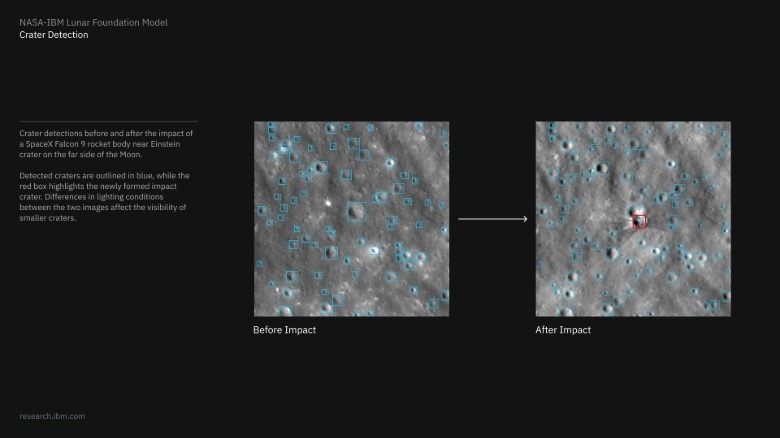
Кроме того, ИИ-модель показала выдающиеся результаты в идентификации и классификации кратеров. В этом сценарии точность системы оказалась на 19% выше, чем у SwinV2-B, при этом для обучения нейросети потребовалось вдвое меньше данных. Практическая проверка возможностей ИИ состоялась 5 августа, когда ракета SpaceX Falcon 9 столкнулась с Луной. Модель успешно распознала место падения, верно классифицировав его как новый кратер, несмотря на частичное наложение на уже существующее геологическое образование.
Технические сложности при обучении модели
Процесс создания нейросети столкнулся с рядом уникальных препятствий. В отличие от снимков Земли, где атмосфера рассеивает солнечный свет, смягчая тени, лунные тени выглядят абсолютно черными и имеют «острые» края. Из-за отсутствия информации в пикселях теней кратеры могут выглядеть совершенно по-разному при различных углах освещения в разное время суток.
Традиционные методы обучения, при которых модель должна реконструировать изображение по оставшимся фрагментам, оказались неэффективны для лунных снимков. По словам Хуана Бернабе-Морено, ранние попытки применения стандартных подходов обернулись неудачей, так как кратеры часто выглядят идентично при съемке с орбиты. Команда исследователей нашла решение, разделив поверхность Луны на «дольки», подобно апельсину, и жестко разграничив области для тренировки и тестирования алгоритма. Это обеспечило необходимую точность обработки данных.
Открытый набор данных для будущих исследований
Важной частью проекта стал запуск первого в своем роде открытого набора данных, предназначенного для обучения других моделей. В него вошли десятки тысяч снимков и результаты инструментальных измерений, полученных в ходе миссий NASA Lunar Reconnaissance Orbiter (LRO) и GRAIL, а также данные японского аппарата SELENE.
Организация массива данных потребовала создания сложной координатной сетки, где каждый пиксель изображения привязан к другим типам информации. Это позволило сформировать библиотеку из более чем двух миллионов «ко-регистрированных» точек данных. Специалисты уверены, что создание такого упорядоченного датасета является существенным научным вкладом, поскольку именно структурированные данные служат фундаментом для развития всей индустрии ИИ-моделей в долгосрочной перспективе.
Контекст миссий и исторические вехи
Разработка модели стала ответом на новые вызовы, стоящие перед космическим агентством в рамках подготовки к будущим этапам программы Artemis. Стоит напомнить, что этой весной мировое сообщество стало свидетелем важного исторического момента: миссия NASA Artemis II осуществила первый с 1972 года пилотируемый облет Луны. 6 апреля астронавты Рид Вайзман, Кристина Кох, Виктор Гловер и Джереми Хансен совершили полет, удалившись от Земли на большее расстояние, чем когда-либо до этого в истории человечества. Накопленный опыт и готовность к дальнейшим исследованиям спутника Земли стали стимулом для создания инструментов, способных автоматизировать анализ огромных массивов геологических данных.
Особенности работы с лунными тенями
Доктор Хуан Бернабе-Морено подчеркивает, что обучение модели на данных спутниковой съемки Луны кардинально отличается от работы с земными объектами. При наблюдении за нашей планетой исследователи имеют дело с «чистыми» изображениями: атмосфера рассеивает солнечный свет, заполняя тени мягким светом и сглаживая переходы. На Луне, в условиях вакуума, ситуация иная: тени выглядят абсолютно черными и имеют «ножевые», предельно резкие края. Это означает, что в затененных пикселях информация практически отсутствует. Поскольку положение Солнца на лунном небе меняется, один и тот же кратер в разное время суток может выглядеть кардинально иначе, что создает серьезные трудности для компьютерного зрения.
Инновационный подход к обучению
Столкнувшись с необходимостью обучения нейросети, исследователи изначально попытались применить стандартный подход: удаление части изображения с последующей задачей модели реконструировать недостающие 90% по оставшимся 10%. Однако для Луны этот метод оказался «полным провалом», так как кратеры, снятые с орбиты, часто визуально очень похожи друг на друга, и модель не могла корректно восстановить структуру. Команда IBM нашла выход в нестандартной геометрии: поверхность Луны была разделена на сегменты, напоминающие дольки апельсина. Полное разделение «тренировочных» и «тестовых» секторов позволило обеспечить высокую согласованность данных, что стало ключом к успеху всей архитектуры.
Ценность структурированного датасета
Особую гордость разработчиков вызывает тот факт, что выпущенный набор данных является первым в своем роде открытым ресурсом подобного масштаба. До этого момента научное сообщество испытывало дефицит «правильно организованных» данных. В рамках работы была проделана колоссальная техническая задача — ко-регистрация изображений, когда каждый пиксель визуальных данных был синхронизирован с другими типами измерений, что делает датасет пригодным для комплексного анализа. Как отмечает Бернабе-Морено, хотя алгоритмы ИИ со временем будут совершенствоваться и замещаться более мощными системами, именно этот тщательно упорядоченный массив данных, содержащий более двух миллионов точек, станет долгосрочным научным фундаментом для всей индустрии искусственного интеллекта в области освоения космоса.








