Оптимизация расходов токенов при работе ИИ-агентов
Одной из главных проблем при использовании агентных систем является перерасход токенов. Выполнение простых задач, таких как генерация шаблонов тестовых файлов или беглый просмотр папок с PDF-документами, зачастую не требует вычислительных мощностей передовых моделей. Хотя при подписочной модели оплаты это менее критично, при расчетах через API стоимость токенов быстро растет, несмотря на то, что с такими задачами успешно справляются более дешевые или даже локальные модели.
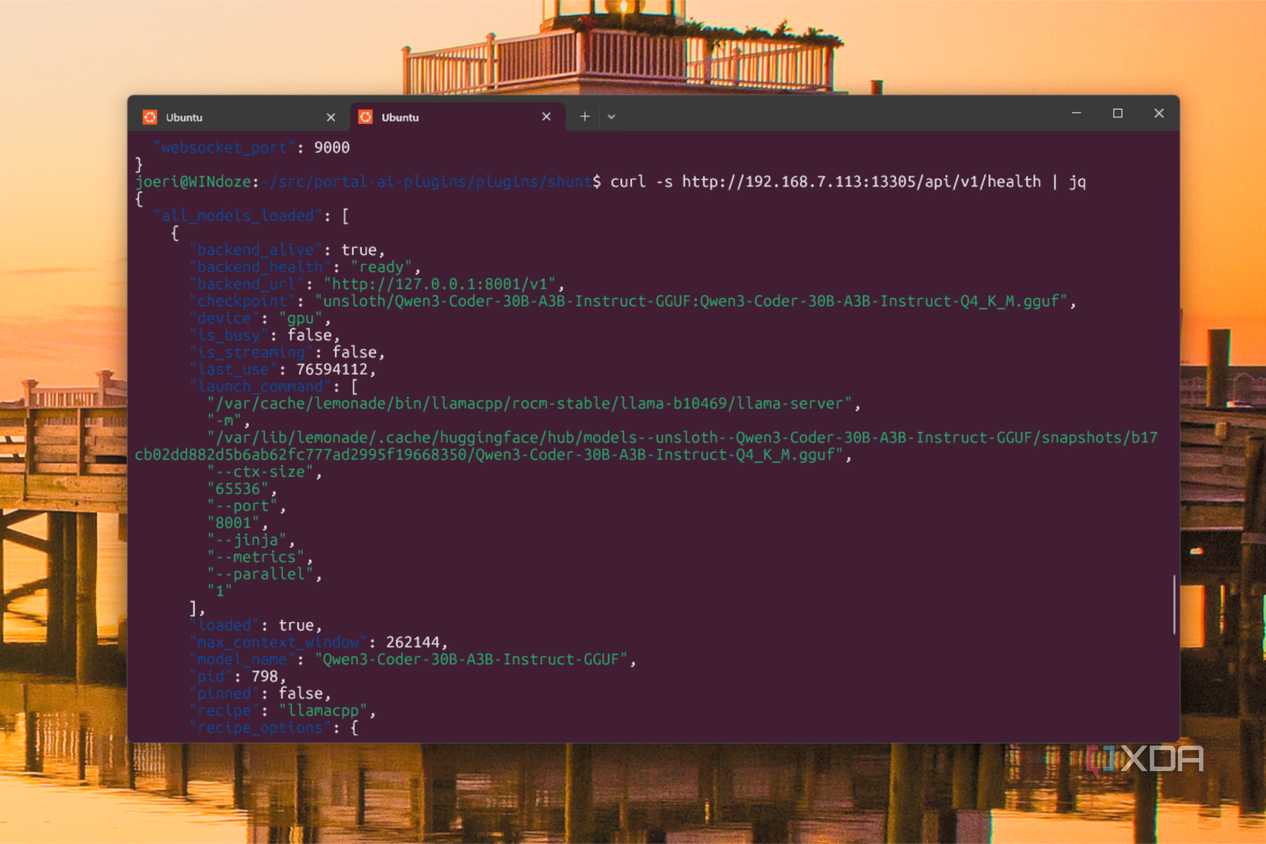
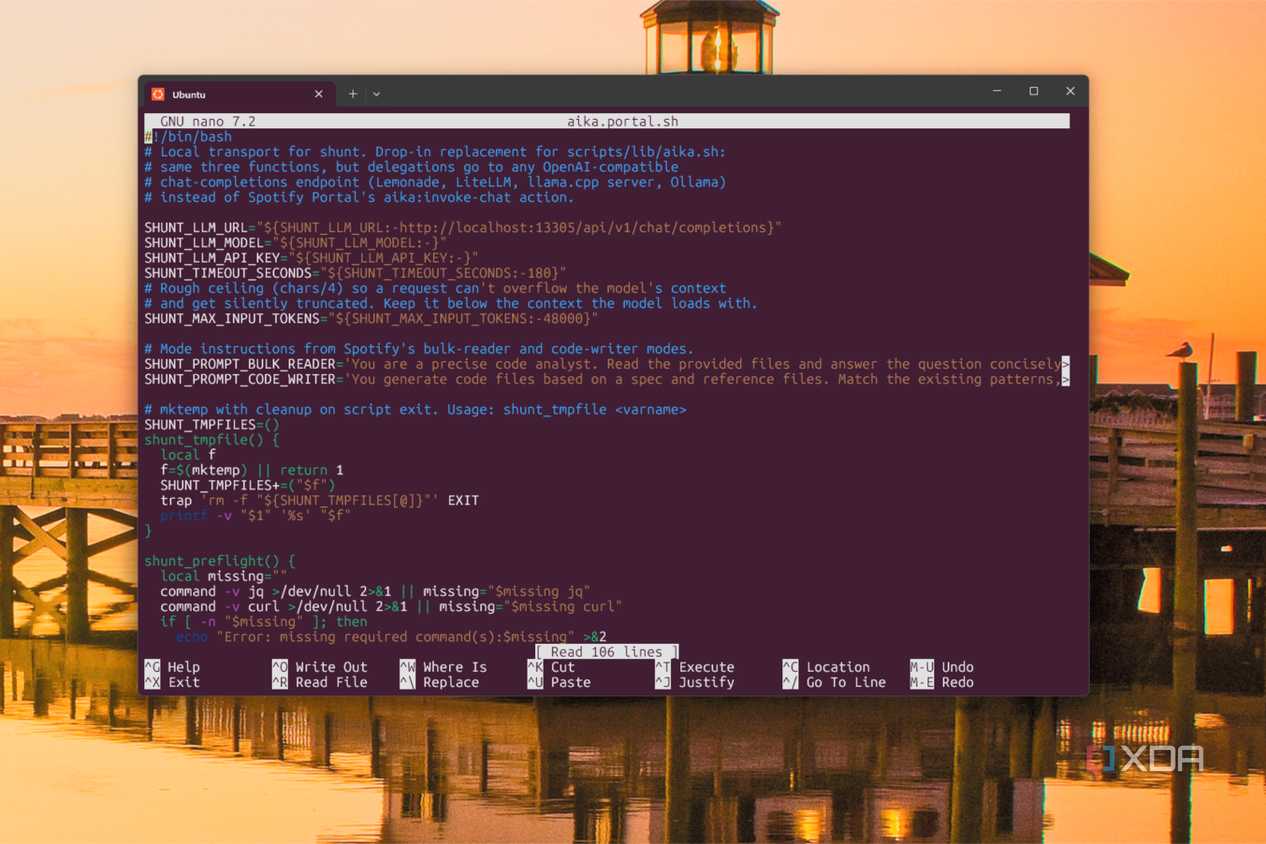
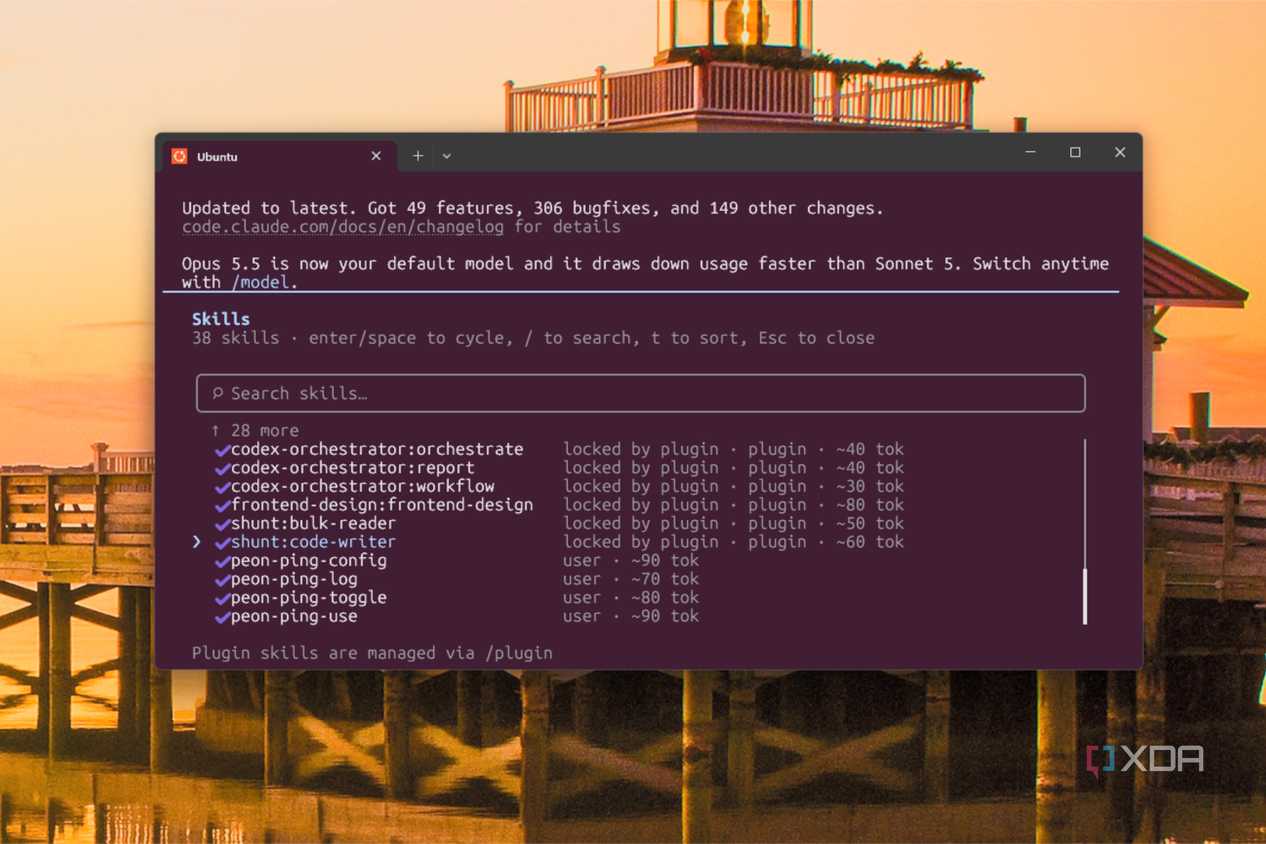
Инженеры Spotify решили эту проблему, внедрив в Portal (внутреннюю платформу разработки компании, ставшую коммерческим продуктом) два новых режима AiKA. Суть плагина shunt проста: большинство действий ИИ-агента при написании кода сводится не к мышлению, а к чтению. Если Claude Code пытается прочитать файл объемом более 350 строк, специальный хук перехватывает запрос и направляет его навыку bulk-reader, который передает файл бюджетной модели-исполнителю и возвращает краткую выжимку. Второй навык, code-writer, аналогично обрабатывает шаблонный код, записывая результат сразу на диск, чтобы Claude не тратил ресурсы на его генерацию.
Показатели Spotify впечатляют: при работе с Java-монорепозиторием из 162 000 строк экономия на чтении крупных файлов составляет от 82% до 94% (в среднем 90%) при использовании Gemini 2.5 Flash в качестве модели-исполнителя. Поскольку плагин имеет открытый исходный код, его можно адаптировать, заменив зависимость от платформы Portal. В авторской реализации вместо нее использовались запросы к Lemonade Server (с моделью Qwen3-Coder-30B-A3B) или к Claude Haiku через headless-сессию Claude Code.
Технические трудности интеграции
В процессе адаптации возникли три проблемы, требующие внимания:
- Совместимость с Claude Code: Хуки shunt не работают с текущей версией Claude Code, так как формат хуков больше не поддерживает команду «allow». Пришлось настроить их на возврат пустого значения, чтобы избежать ошибок.
- Проблемы локального бэкенда: При работе Qwen3-Coder на бэкенде ROCm модель «выдумывала» несуществующие функции и некорректно копировала строки. Переход на бэкенд Vulkan решил проблему с точностью копирования.
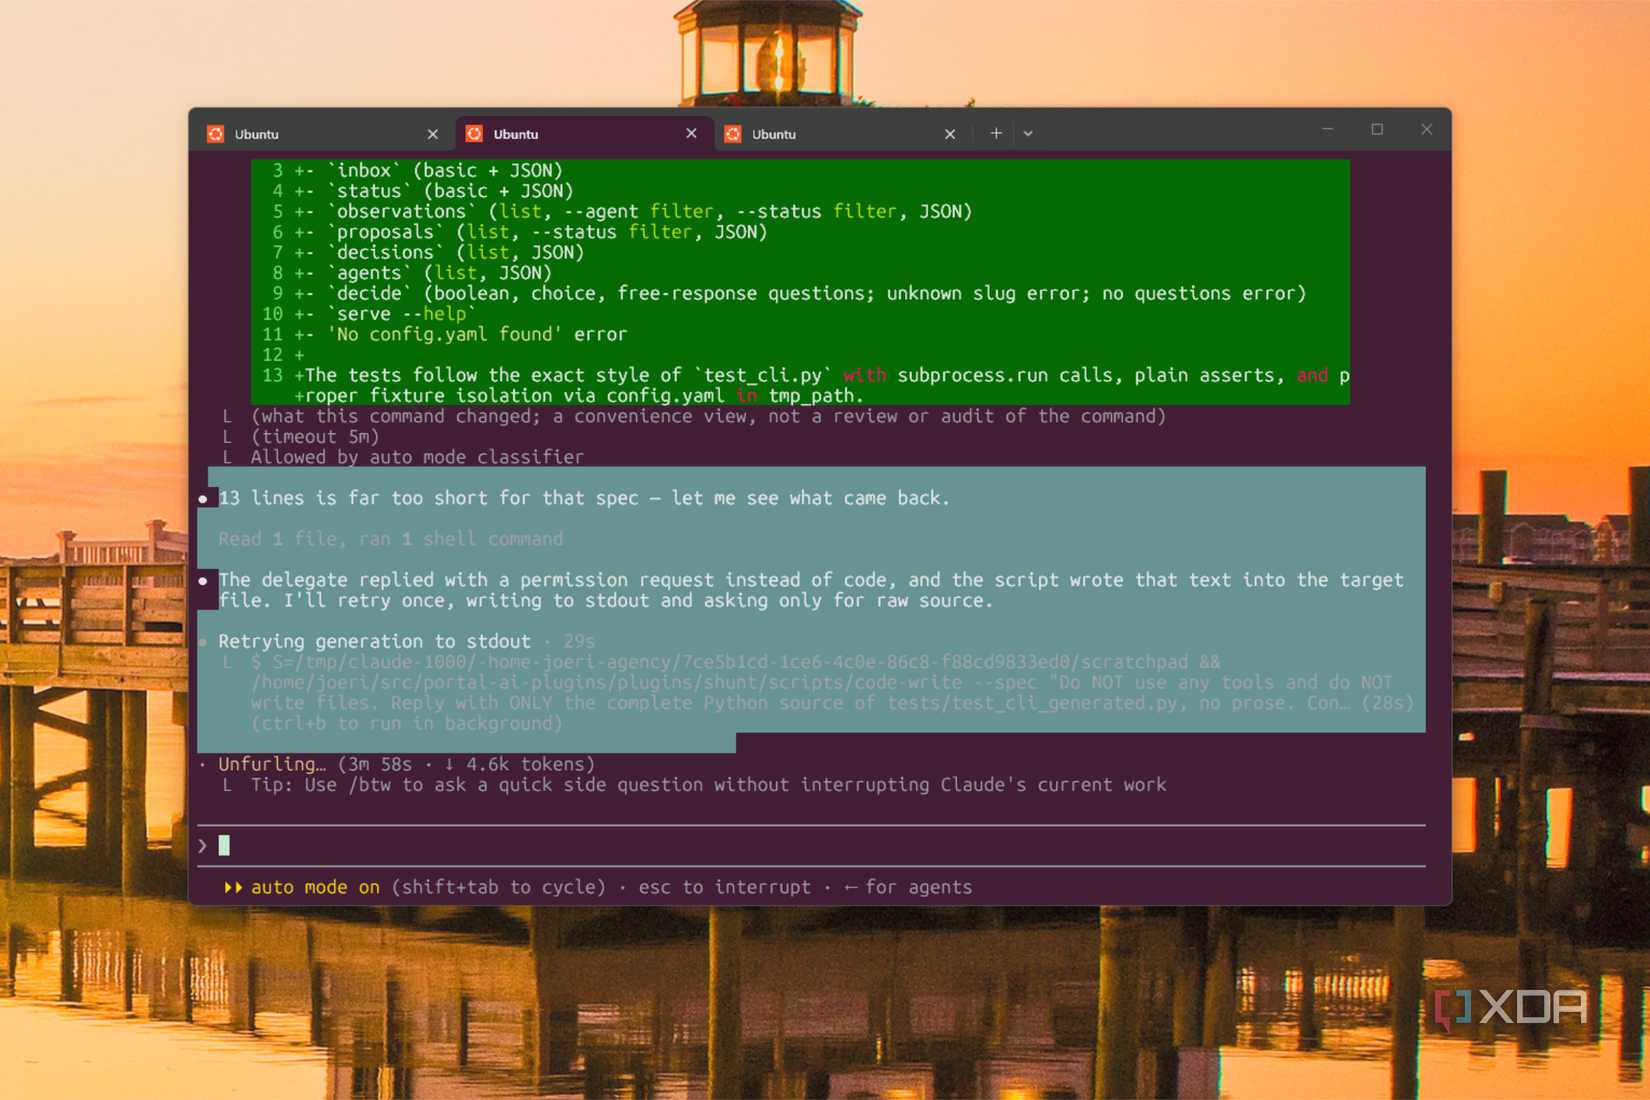
- Настройка агента: В headless-режиме Claude Haiku пытался самостоятельно выполнить задачу, сталкиваясь с запросом на разрешение доступа. Проблема решилась запуском с флагом —tools «» для отключения штатных инструментов.
Результаты тестирования в реальных условиях
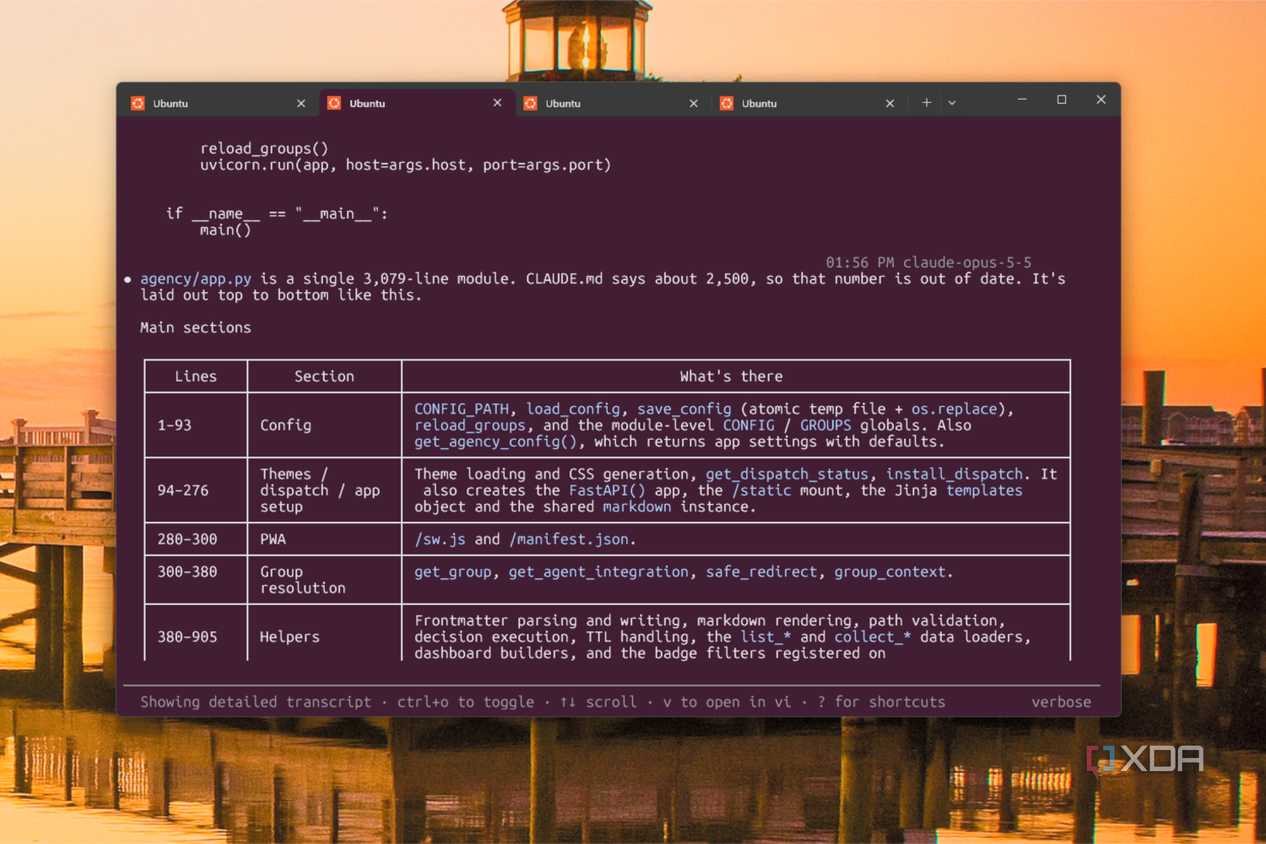
Для тестов использовался Agency — дашборд для управления командой ИИ-агентов. При работе Claude Code с моделью Opus 5.5 замеры проводились по показателю Messages через команду /context (исключая 37 500 токенов фиксированных накладных расходов). В качестве целевого объекта был выбран файл agency/app.py объемом 3 079 строк.
При первом запросе (перечисление HTTP-маршрутов) Opus справился через вызовы grep, не открывая файл напрямую, потратив 17 300 токенов. Для более сложной задачи, требующей анализа структуры файла и зависимостей, расход составил 36 700 токенов без shunt и 35 500 с активным shunt. Разница оказалась незначительной, так как Opus применил grep для картирования файла, а затем извлек нужные фрагменты через sed.
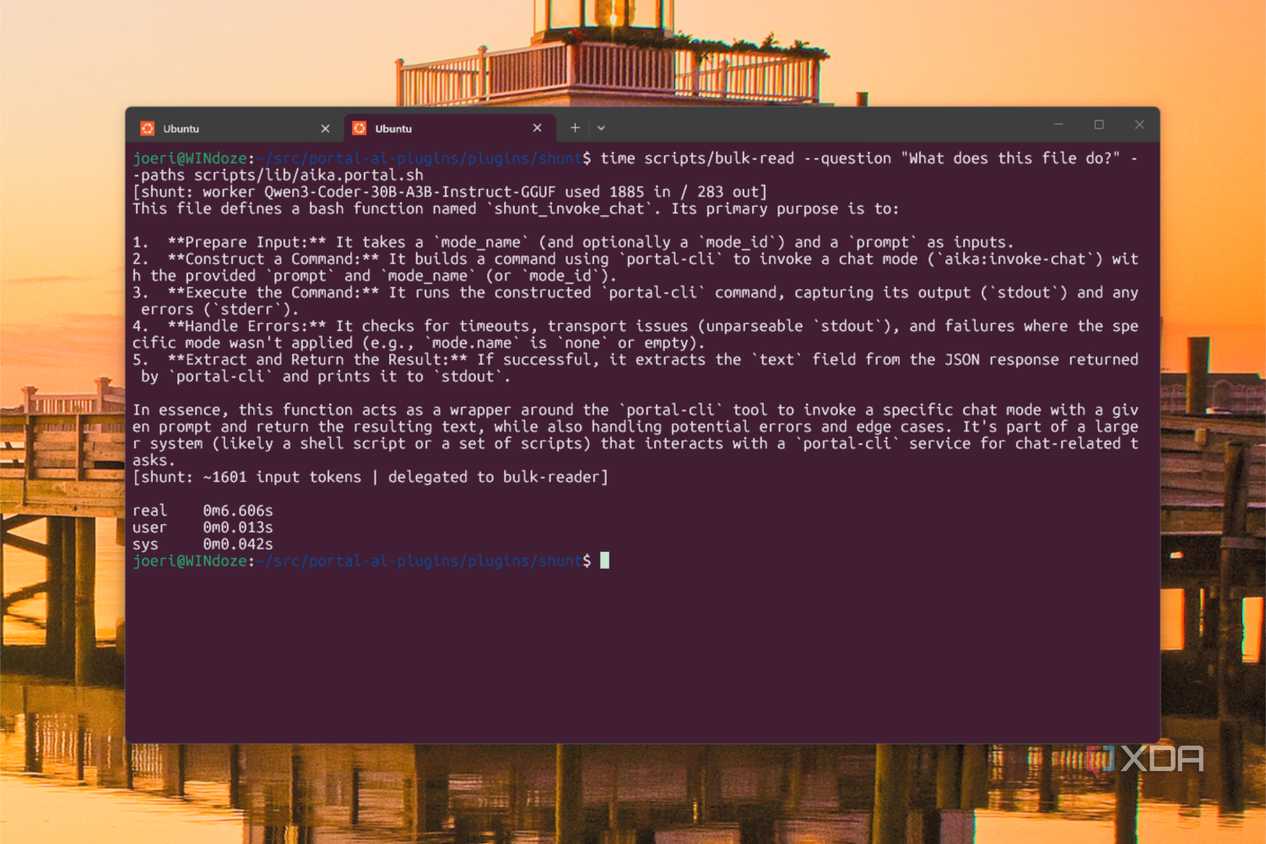
Выяснилось, что плагин shunt перехватывает только конкретные команды (Read, cat, head, tail, less, more), а Opus 5.5 самостоятельно оптимизирует чтение, не прибегая к ним, из-за чего навык bulk-reader оставался невостребованным. Кроме того, была обнаружена уязвимость хука: при цепочке команд, где сначала идет маленький файл, а затем крупный (439 строк), проверка срабатывала только на первом файле. Итоговая эффективность 90%, заявленная Spotify, напрямую зависит от методов чтения конкретной модели, и современные версии Claude уже умеют оптимизировать эти процессы самостоятельно.
Делегирование задач: когда процесс обходится дороже результата
Делегирование написания кода оказалось затратнее, чем его самостоятельное создание. Opus успешно составлял подробные спецификации, однако привлеченные исполнители все равно допускали ошибки. Поскольку чтение не дало значимых преимуществ, основным тестом стало написание кода.
Я попросил Claude Code создать тесты для команд CLI, которые не были охвачены существующим файлом тестов проекта, следуя заданному стилю и используя навык делегирования, если он доступен. Opus самостоятельно активировал навык code-writer из библиотеки shunt, что первые десять минут казалось успехом.
Оба сеанса с делегированием потребовали больше токенов, чем при работе Opus в одиночку: на 23% больше при использовании Qwen3-Coder и на 34% больше при работе с Haiku. Кроме того, процесс занял в семь-десять раз больше времени. Хотя в обоих случаях количество тестов увеличилось, это произошло благодаря планированию со стороны Opus, который мог бы написать их самостоятельно за долю этого времени.
Наиболее разочаровывает то, что Opus блестяще справился со своей частью работы. Перед делегированием модель определила, что CLI ищет конфигурацию в текущей рабочей директории, что для тестовых данных необходимы актуальные даты, чтобы они не удалялись правилами очистки, и что одна из команд получает ответы через стандартный ввод. Затем модель передала локальному исполнителю спецификацию объемом 635 слов с детальным описанием всех этих условий.
Ошибки исполнителей и неизбежность перепроверки
Qwen3-Coder проигнорировал ключевые детали. Например, один из тестов запускал CLI из папки проекта вместо временной, хотя спецификация прямо предупреждала об этой ловушке; в итоге 19 из 21 теста завершились неудачей. Opus пришлось прочитать все 339 строк черновика и переписать файл с нуля, что означало, что он в конечном итоге сгенерировал всё самостоятельно.
Haiku справился значительно лучше: 19 из 23 тестов прошли успешно сразу. Однако модель жестко закодировала фиксированную дату в тестовых данных, попав в ту самую ловушку с правилом очистки, на которую указывала спецификация. Opus пришлось прочитать почти 400 строк черновика и исправлять код, вместо того чтобы писать его с чистого листа. Это и есть цена, которую shunt не может исключить: Opus не отправит код, который не проверил, а проверка черновика означает его чтение.
Проблема задержек и производительности
Отдельным фактором стало ожидание. На Vulkan модель Qwen3-Coder выдавала около 12 токенов в секунду, поэтому обработка файла тестов на несколько тысяч токенов занимала четыре минуты и более. Первый сеанс делегирования завершился по тайм-ауту на третьей минуте, когда модель все еще находилась в процессе записи, и Opus пришлось перезапускать задачу с увеличенным временем ожидания.
Haiku также не работает мгновенно, так как каждое делегирование запускает полноценный сеанс Claude Code в фоновом режиме. На простом тесте с чтением файлов это заняло 15,8 секунд по сравнению с 3,2 секундами у локальной модели, хотя Haiku точно указал все номера строк, в отличие от Qwen3-Coder, который ошибся в двух из трех.
Spotify в своем материале предупреждает о задержках, и в данной задаче по написанию кода один процесс, занимавший минуту, превратился в десятиминутный. Идея Spotify здравая, но мой Claude и так выполнял «дешевую» часть работы.
Я не считаю, что расчеты Spotify неверны. Их бенчмарки были получены на базе крупного монорепозитория Java и настройки, где Claude, очевидно, считывал большие файлы целиком, при этом в публикации не уточняется, какая именно модель Claude измерялась. Если ваши сеансы работают именно так, хуки shunt будут срабатывать постоянно, и экономия станет реальной. Однако Opus 5.5 уже умеет читать данные выборочно, а при делегировании записи он проверяет работу, что обходится дороже, чем написание кода с нуля. Чтобы понять, к какой категории относитесь вы, введите /context после выполнения большой задачи и обратите внимание на строку Messages, а затем проверьте, действительно ли Claude вызывал Read для ваших больших файлов. Если нет, то самый дешевый плагин для экономии токенов — тот, который вы не установили.
Важно уточнить контекст реализации: оригинальное решение Spotify требует доступа к их коммерческой платформе Portal, а взаимодействие с внешней средой ограничено необходимостью переговоров с отделом продаж. Автор эксперимента подчеркивает, что единственным препятствием для внедрения open-source версии плагина является зависимость от Portal, которая в коде жестко прописана в единственном файле. Его замена на вызовы к сторонним API или локальным серверам позволяет воссоздать логику Spotify без привязки к проприетарной среде.
Особенности работы с моделями-исполнителями
При использовании локальных LLM критически важным оказалось тестирование способности модели к базовому копированию входных данных. В ходе эксперимента выяснилось, что при идентичном запросе (копирование пяти строк файла) модель Qwen3-Coder на бэкенде ROCm выдавала «мусор» или обрывала выполнение на символе кода, тогда как тот же бэкенд на Vulkan справлялся с задачей символ в символ. Это подтверждает, что при выборе локальной модели-исполнителя необходимо проводить стресс-тест на базовое воспроизведение текста, прежде чем перекладывать на нее функции агента.
Уточнение по архитектуре Claude Code
Важным нюансом является то, что headless-режим Claude Code функционирует как полноценный агент, а не просто текстовое поле. Это создает проблему при автоматизации: модель пытается самостоятельно «додумать» решение и активирует встроенные инструменты. В частности, Haiku при выполнении задачи написания теста пытался самостоятельно отправить запрос на разрешение доступа (permission prompt), на который не мог ответить, и в итоге сохранял текст своего же запроса как финальный код. Использование флага —tools «» для принудительного отключения инструментов в фоновых процессах стало необходимым условием для корректной работы плагина.
Критический взгляд на экономию
Сравнительный анализ показал, что эффективность использования shunt напрямую коррелирует с паттернами поведения выбранной модели. Если Claude Opus 5.5 эффективно справляется с навигацией по коду, используя grep и точечное извлечение данных через sed, он попросту не обращается к функциям чтения, которые перехватывает плагин. В итоге bulk-reader оказывается в контексте, но остается «спящим», что делает установку плагина избыточной. Кроме того, сохраняется проблема «зазора» в защите: хуки плагина проверяют только первый файл в цепочке вызовов, что позволяет операциям над несколькими файлами разной длины обходить фильтры оптимизации.