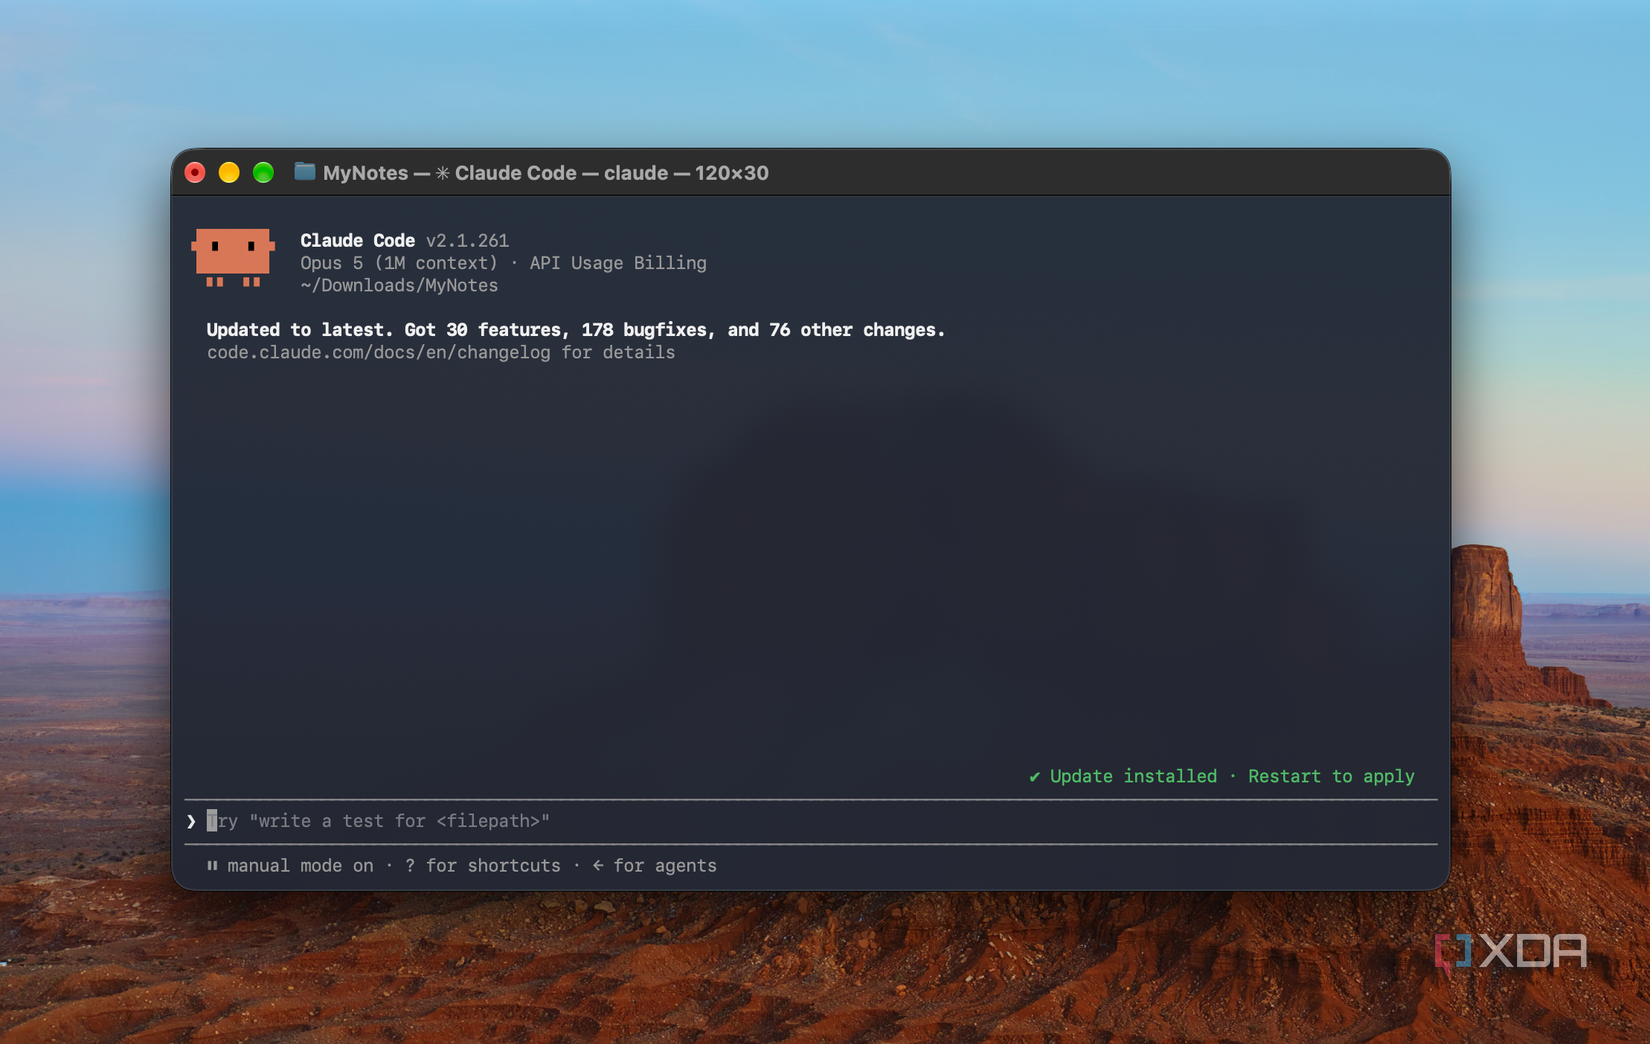
Claude Code представляет собой инструмент, способный самостоятельно анализировать кодовую базу, вносить изменения в несколько файлов и проводить тестирование результатов. Одной из функций системы является «автоматическая память» (auto memory), предназначенная для сохранения деталей предыдущих сессий, таких как предпочтения разработчика, исправления или контекст проекта, с целью их переноса в новые задачи. Однако практика показывает, что эта функция нередко становится помехой, создавая избыточные и часто неверные предпосылки для работы ИИ.

Почему автоматическая память Claude Code может мешать разработке
Основная проблема заключается в том, что система сама определяет, какая информация является полезной. Claude Code записывает детали в файл MEMORY.md, расположенный в каталоге репозитория, и обращается к нему при старте каждой новой беседы. В результате временные инструкции, данные во время отладки конкретного бага, могут превратиться в постоянные ограничения, которые больше не актуальны для текущих задач.
Кроме того, ИИ может ошибочно интерпретировать дискуссии как утвержденные архитектурные решения. В процессе поиска оптимального метода реализации проекта разработчик часто рассматривает множество идей, которые в конечном итоге не находят отражения в коде. Автоматическая память сохраняет эти концепции без контекста сомнений, из-за чего в последующих сессиях Claude может воспринимать отвергнутые варианты как обязательные элементы архитектуры. Это вынуждает пользователя тратить дополнительные усилия и ресурсы на повторные правки и перепромптинг, что делает работу менее эффективной.
Преимущества использования CLAUDE.md вместо автоматической памяти
Для управления контекстом проекта гораздо эффективнее использовать файл CLAUDE.md. В отличие от автоматической памяти, этот файл позволяет разработчику вручную фиксировать важные данные: используемый менеджер пакетов, команды для тестирования или ключевые архитектурные правила. Система также поддерживает файл AGENTS.md, который облегчает перенос инструкций между различными агентами кодирования.
Ручное обновление CLAUDE.md дает несколько преимуществ:
- Актуальность данных. Пользователь сам решает, когда правило становится постоянным, и обновляет информацию по мере развития проекта.
- Контроль над объемом. Рекомендуется поддерживать объем файла менее 200 строк, чтобы ИИ точнее следовал инструкциям, не отвлекаясь на лишние детали.
- Прозрачность. Разработчик всегда видит, какой именно контекст передается Claude до начала внесения изменений в код.
Почему чистый старт сессии упрощает отладку
Автоматическая память предполагает, что каждая последующая сессия является прямым продолжением предыдущей, однако на практике это не всегда соответствует действительности. Накопление «багажа» из старых задач затрудняет отладку: если Claude принимает странное решение, пользователю приходится анализировать не только текущий промпт и репозиторий, но и скрытое влияние накопленной истории, что значительно усложняет поиск причины ошибки.
Ситуация осложняется при работе с несколькими рабочими деревьями (worktrees) или при переключении между различными агентами кодирования. Claude Code хранит данные локально и распространяет их на все деревья одного репозитория, что приводит к непредсказуемому поведению: две сессии, работающие с одним и тем же кодом, могут основываться на разных предпосылках. Отключение автоматической памяти позволяет каждый раз начинать работу с чистого листа, что делает поведение ИИ более предсказуемым и управляемым.
Оптимизация работы с Claude Code
Отказ от автоматической памяти — лишь один из способов настройки среды. Для повышения продуктивности полезно использовать функционал хуков (hooks), которые гарантируют, что ИИ остается сфокусированным на поставленной цели и следует заданным правилам на протяжении всей задачи. Настройка этих параметров позволяет добиться большей точности и эффективности при работе с кодовой базой.
Как работает автоматическая память в Claude Code
Функциональность Auto Memory в Claude Code работает независимо от инструкций, которые вы прописываете вручную в CLAUDE.md. Система настроена на постоянный мониторинг рабочего процесса: она отслеживает исправления, рабочие предпочтения, принятые решения и ссылки, которые, по ее «мнению», могут пригодиться в будущем. Эти сведения сохраняются в специальную директорию памяти, связанную с репозиторием. При запуске любой новой сессии Claude загружает начальную часть индекса MEMORY.md, а по мере выполнения задачи может обращаться к более подробным заметкам из этого хранилища.
Основная сложность заключается в том, что Claude не всегда способен корректно отфильтровать значимую информацию от проходной. Даже временное указание, данное для устранения одного конкретного бага, может быть зафиксировано как долгосрочное предпочтение. В результате в следующих сессиях вы можете столкнуться с тем, что ИИ продолжает пытаться обходить ограничение, которое давно утратило актуальность. Это создает замкнутый цикл: вам приходится тратить время на повторную перенастройку Claude Code и принудительное переписывание промптов, чтобы заставить его игнорировать старые «напоминания». Такое поведение не только раздражает, но и увеличивает расход токенов, что при длительной работе над проектом становится заметной финансовой проблемой.
Преимущества ручного управления контекстом
Подход, основанный на использовании статических файлов вроде CLAUDE.md, более надежен, так как вы точно видите, какую информацию получает ИИ перед тем, как приступить к манипуляциям с кодом. Поддержка AGENTS.md также упрощает перенос унифицированных инструкций между различными инструментами кодирования.
Важно помнить, что CLAUDE.md — это место для ключевых правил, которые должны соблюдаться последовательно. Существует риск превратить этот файл в свалку лишних данных, что снижает эффективность работы ИИ. Эксперты рекомендуют придерживаться объема менее 200 строк на файл; соблюдение этого правила помогает системе лучше фокусироваться на приоритетных задачах и точнее следовать заданным алгоритмам.
Проблемы с рабочими деревьями и переносимостью
Автоматическая память создает лишний «багаж» для новых задач, предполагая преемственность сессий, которая далеко не всегда нужна. Когда Claude совершает ошибку, отладка становится многослойной: вам нужно проверить свой текущий промпт, состояние репозитория и явные инструкции, но при включенной автопамяти вам также приходится анализировать скрытое влияние предыдущих дискуссий.
Ситуация значительно усложняется, если вы используете несколько рабочих деревьев (worktrees) или часто переключаетесь между различными агентами кодирования. Claude Code сохраняет память локально и делает ее общей для всех worktrees в рамках одного репозитория. Это ведет к потере прозрачности: информация, записанная в память, не является частью самого репозитория, она не переносится на другие машины и не видна при работе с другими инструментами. В итоге две разные сессии, запущенные над одним и тем же кодом, могут приводить к принципиально разным результатам только потому, что одна из них «помнит» историю, а другая нет.
Отказ от использования автоматической памяти в пользу четких, контролируемых инструкций позволяет сделать поведение ИИ предсказуемым. Помимо этого, для максимизации отдачи от Claude Code следует уделить внимание изучению менее очевидных настроек системы и внедрению хуков, которые обеспечивают жесткое следование заданным целям на всех этапах разработки.