Трансформация «вайб-кодинга»: опыт внедрения правил разработки ядра Linux
Популярность «вайб-кодинга» легко объяснить: наблюдение за тем, как идеи превращаются в работающее приложение в процессе диалога с нейросетью, сродни магии. Именно так я создал CW Inspector — локальное Linux-приложение для анализа и декодирования записей азбуки Морзе в формате WAV из онлайн-источников WebSDR. Поначалу программа работала блестяще, но позже возникли сложности: сгенерированный код, каким бы отполированным он ни казался, требует глубокого понимания и верификации со стороны разработчика.
В этом контексте полезными оказались руководства по использованию ИИ-инструментов, принятые для ядра Linux. Они не запрещают применение нейросетей, но признают, что поддержка такого кода становится крайне сложной по мере накопления сгенерированных фрагментов. Применив пять правил прозрачности из этих рекомендаций к своему проекту, я обнаружил, что приложение, которое казалось идеально работающим, на самом деле уверенно декодировало аудио с ошибками, не выдавая при этом никаких уведомлений.
Указывайте ИИ-инструмент
Первое правило — фиксировать, какой именно инструмент создал большую часть проекта или его значимые фрагменты. Это полезнее, чем имитация написания кода «с нуля». Руководство ядра не требует перечислять все инструменты автодополнения, проверки грамматики или форматирования, оно касается только существенных частей: функций, исходных файлов, исправлений или документации. При неясности границ прозрачность предпочтительнее.
Для CW Inspector я зафиксировал следующее:
- Первичную реализацию на основе моих спецификаций выполнил OpenAI Codex.
- Среду тестирования обеспечили Linux Mint 22.3 и Python 3.12.3.
- За интерфейс отвечал Flask, за обработку аудио — NumPy и SciPy.
- Визуализацию графиков реализовал Plotly, а для тестирования использовались Pytest, Mypy и Bandit.
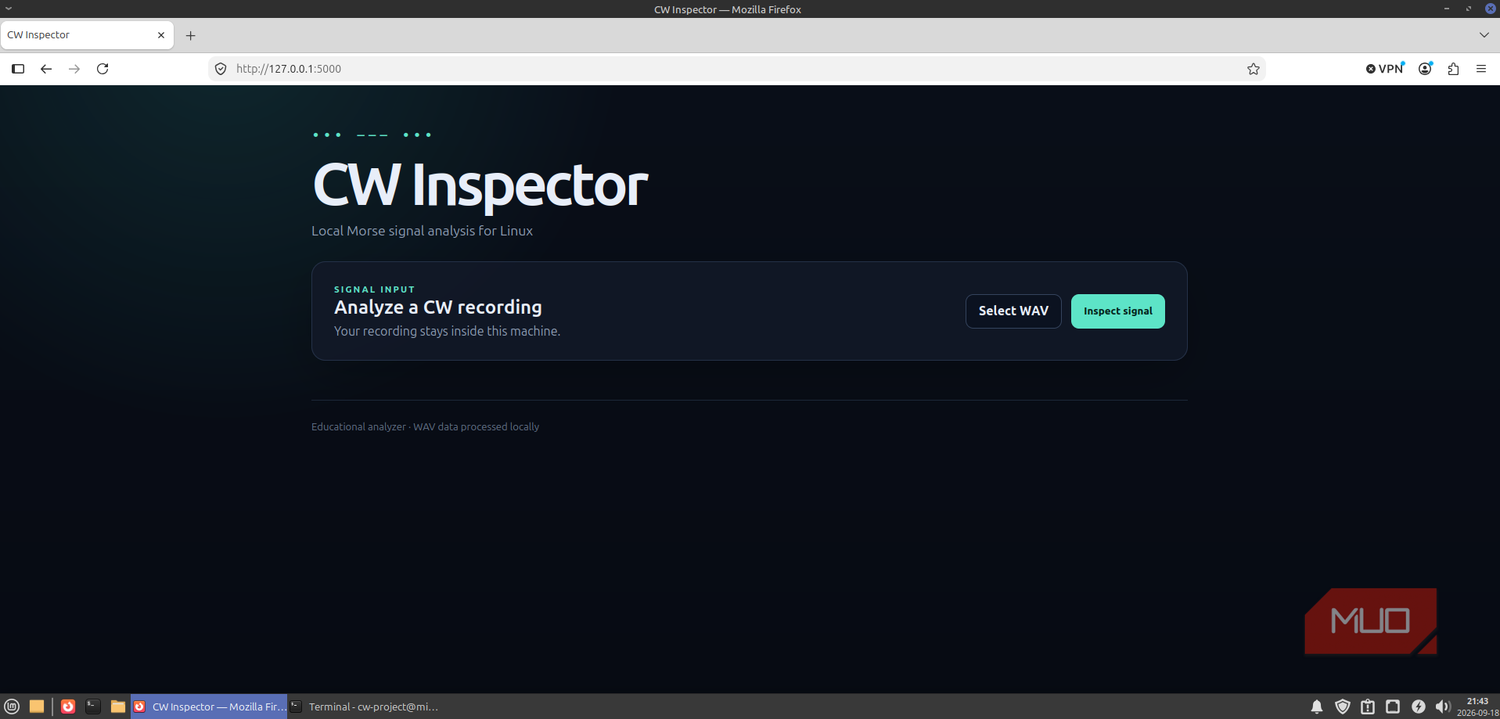
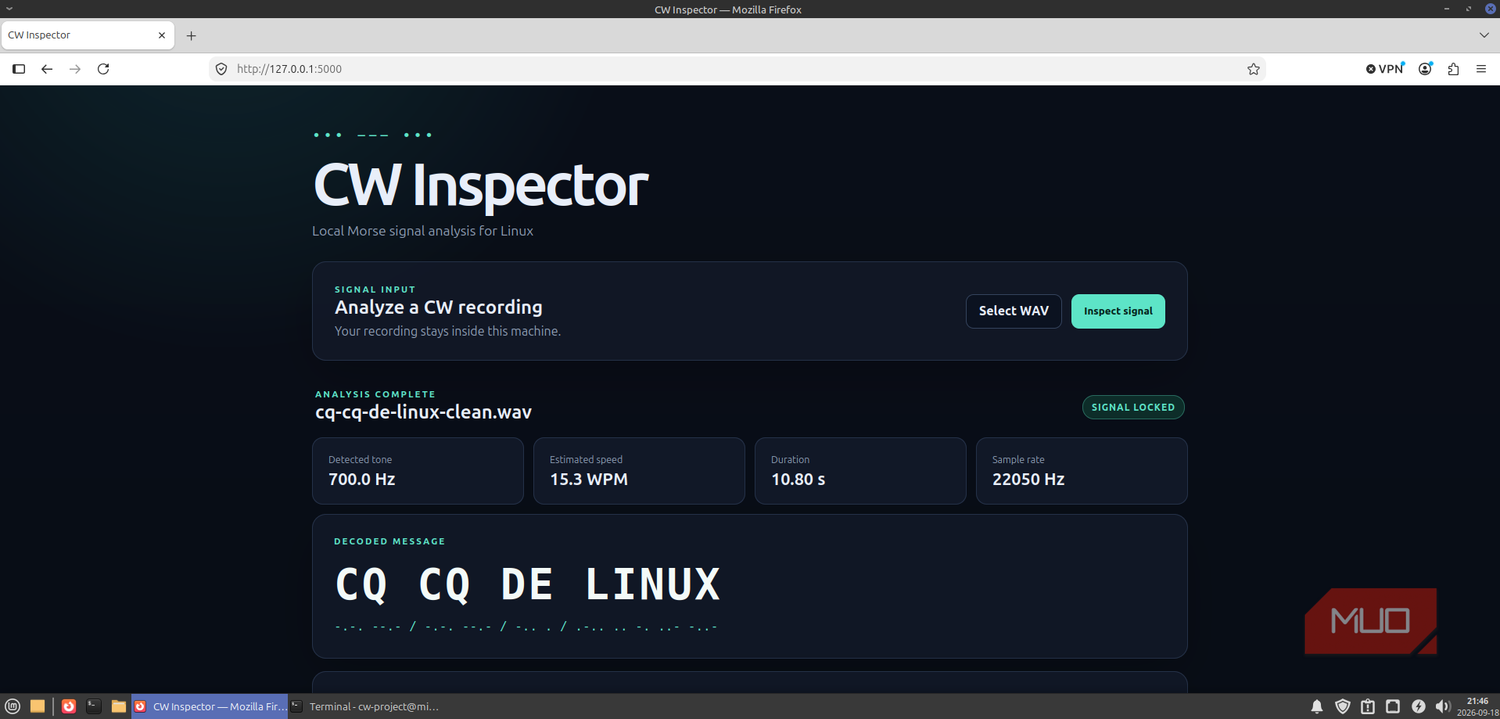
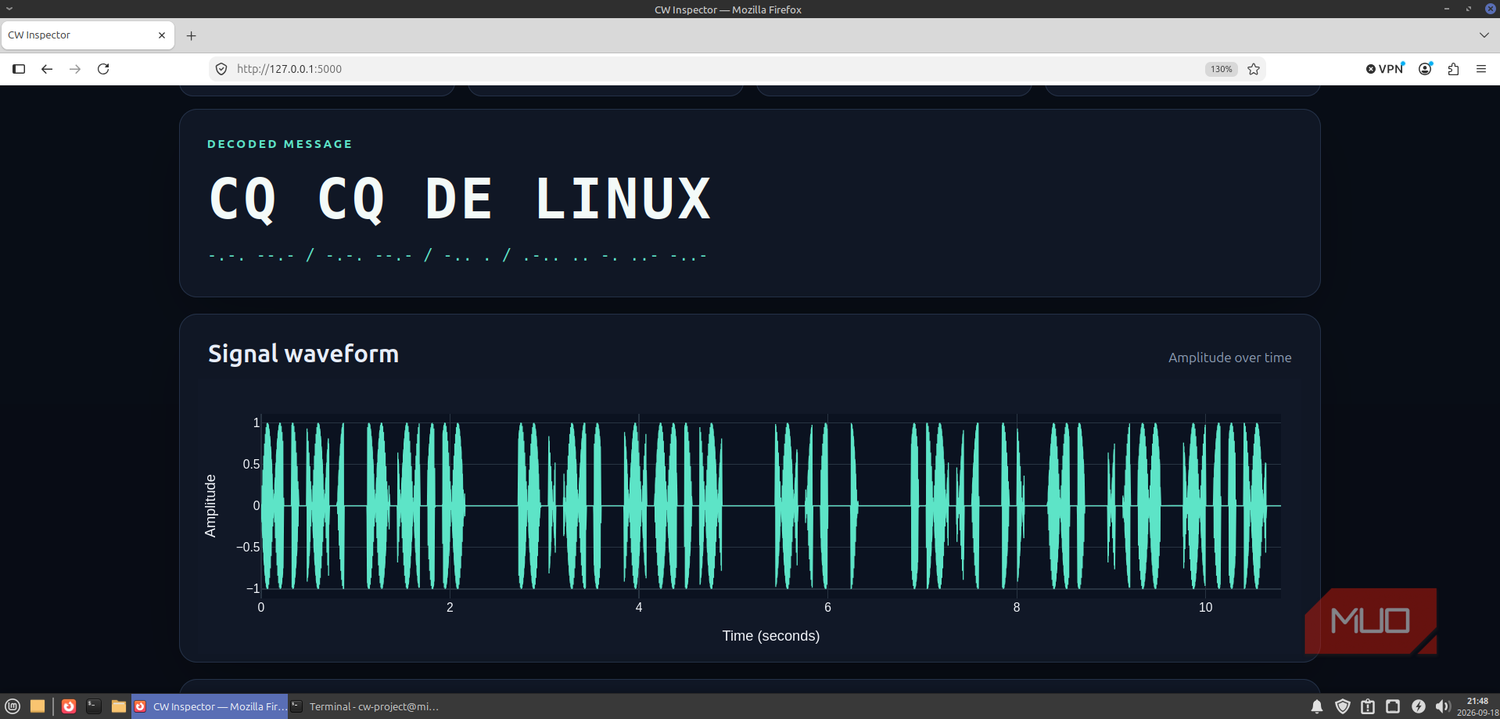
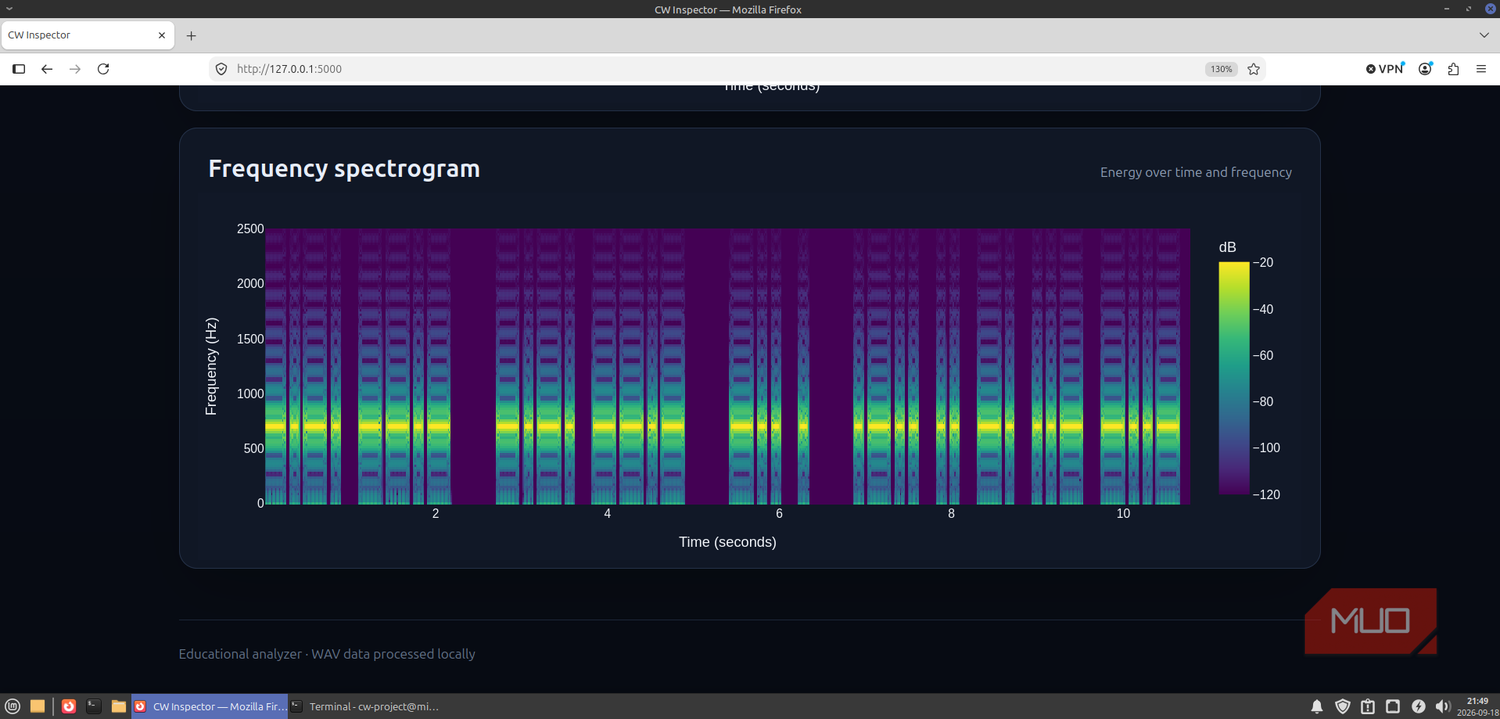
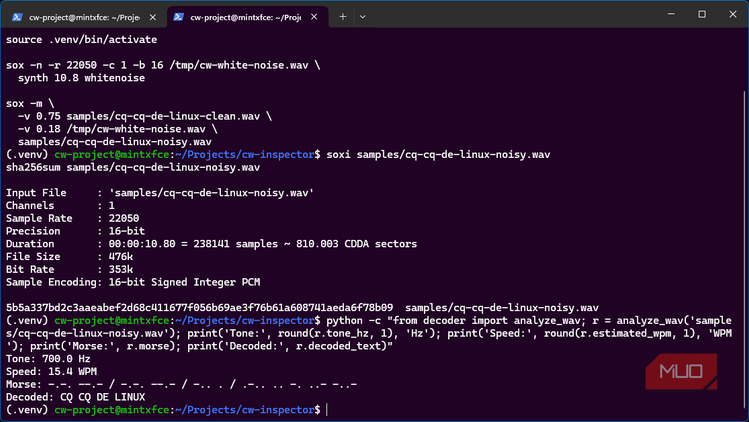
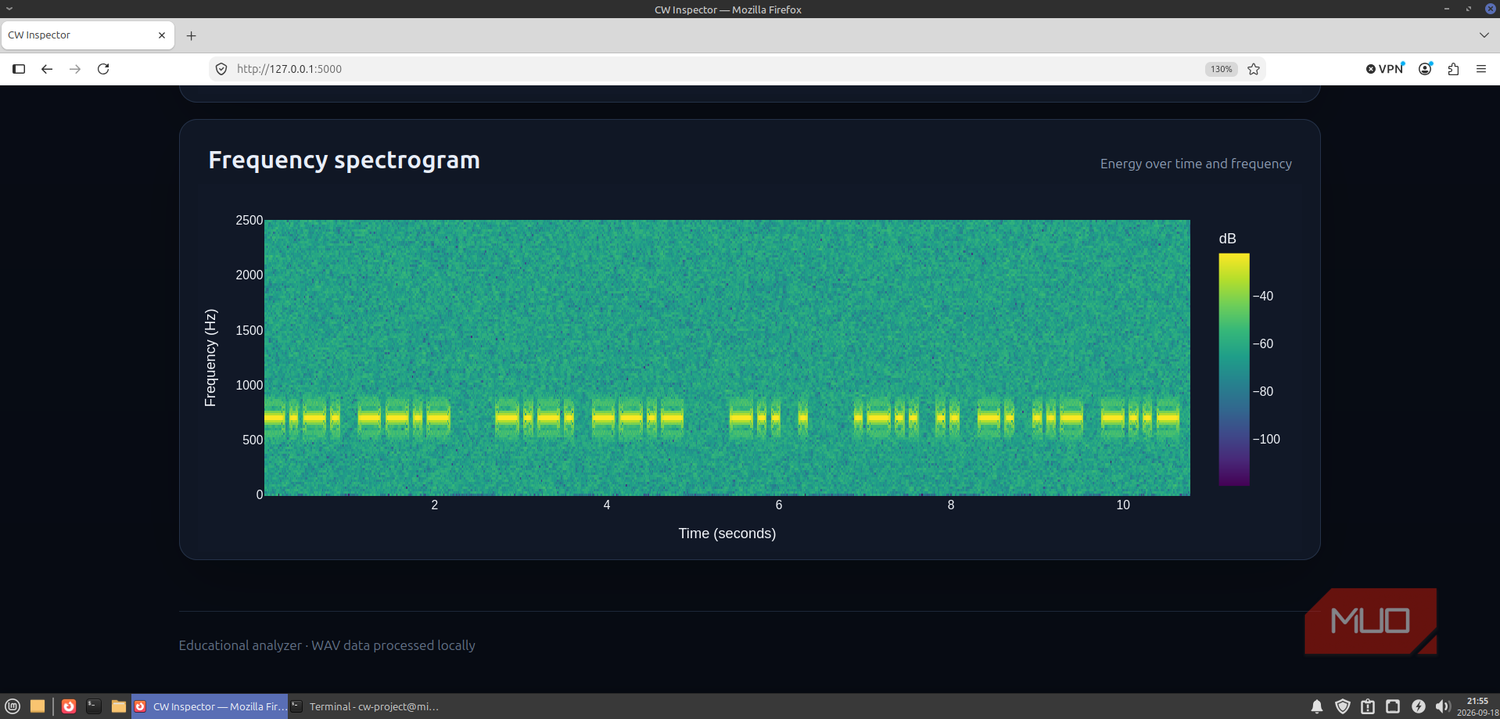
До того как погрузиться в историю разработки, я протестировал готовое приложение. Оно обнаружило сигнал частотой 700 Гц в моем самостоятельно созданном WAV-файле, корректно оценило скорость в 15.3 WPM и декодировало «CQ CQ DE LINUX». Также программа построила качественную форму волны и спектрограмму, подобную тем, что использует Shazam, и успешно обработала файл с широкополосным белым шумом. Указание OpenAI Codex в качестве автора первичной реализации не обесценило эти результаты, но позволило определить участки кода, требующие более тщательной проверки по сравнению с кодом, написанным мной лично.
Сохраняйте входные данные
Второе правило требует сохранять промпты и требования, которые привели к результату. ИИ-код имеет смысл только в контексте, который был задан модели, будь то исходные материалы или технические требования. Перед тем как Codex сгенерировал код CW Inspector, я создал и зафиксировал файл PRODECT_SPEC.md. Он содержал требования:
- Локальный интерфейс Flask для монофонических файлов PCM WAV.
- Анализ формы волны, спектрограммы, тона и скорости.
- Транскрипция Морзе параллельно с декодированными сообщениями.
- Разделение логики обработки сигналов и веб-интерфейса.
- Отсутствие облачных сервисов или команд оболочки, формируемых из загруженных имен файлов.
- Автоматизированное тестирование и честные ограничения для слабых, затухающих или перекрывающихся сигналов.
Для проверки я записал образец через переводчик Coddy’s Morse. Это был 10.8-секундный монофонический 16-битный PCM-файл (22 050 Гц) с сигналом 700 Гц на скорости около 15 WPM, содержащий «CQ CQ CQ DE LINUX». Codex получил метаданные записи и ожидаемое сообщение, но не сам файл. Это позволило провести независимый приемочный тест, а не позволить модели оптимизироваться под конкретный образец, который она позже должна была декодировать. Без таких ограничений воспроизведение успеха или диагностика сбоев превращаются в гадание.
Сохраняйте историю промптов
Третье правило гласит, что готовый файл не может объяснить, что именно требовалось оптимизировать. Рекомендации ядра советуют включать фактические промпты при генерации значимого кода, даже если это всего пара запросов. Для длинных сессий разработчикам предлагается резюмировать задачи и характер помощи инструмента. Моя сессия работы с ИИ была задокументирована в AI_ASSISTANCE.md, где указано, что Codex должен был:
- Изучить полную спецификацию перед написанием кода.
- Создать только запрошенный локальный анализатор WAV.
- Хранить обработку сигналов отдельно от Flask.
- Избегать внешних API и выполнения команд через имена файлов.
- Не заявлять о поддержке функционала, выходящего за рамки проекта.
Документирование намерений и спецификаций
Если бы я ограничился сохранением запроса вроде «создай мне декодер азбуки Морзе», это скрыло бы детали, которые сформировали архитектуру и определили границы безопасности. Описание целей в промптах дало мне конкретную базу для сравнения с итоговой реализацией. Хотя промпты — это не рецепт, который гарантирует идентичный код при использовании разных ИИ, их ценность заключается в разъяснении исходного замысла.

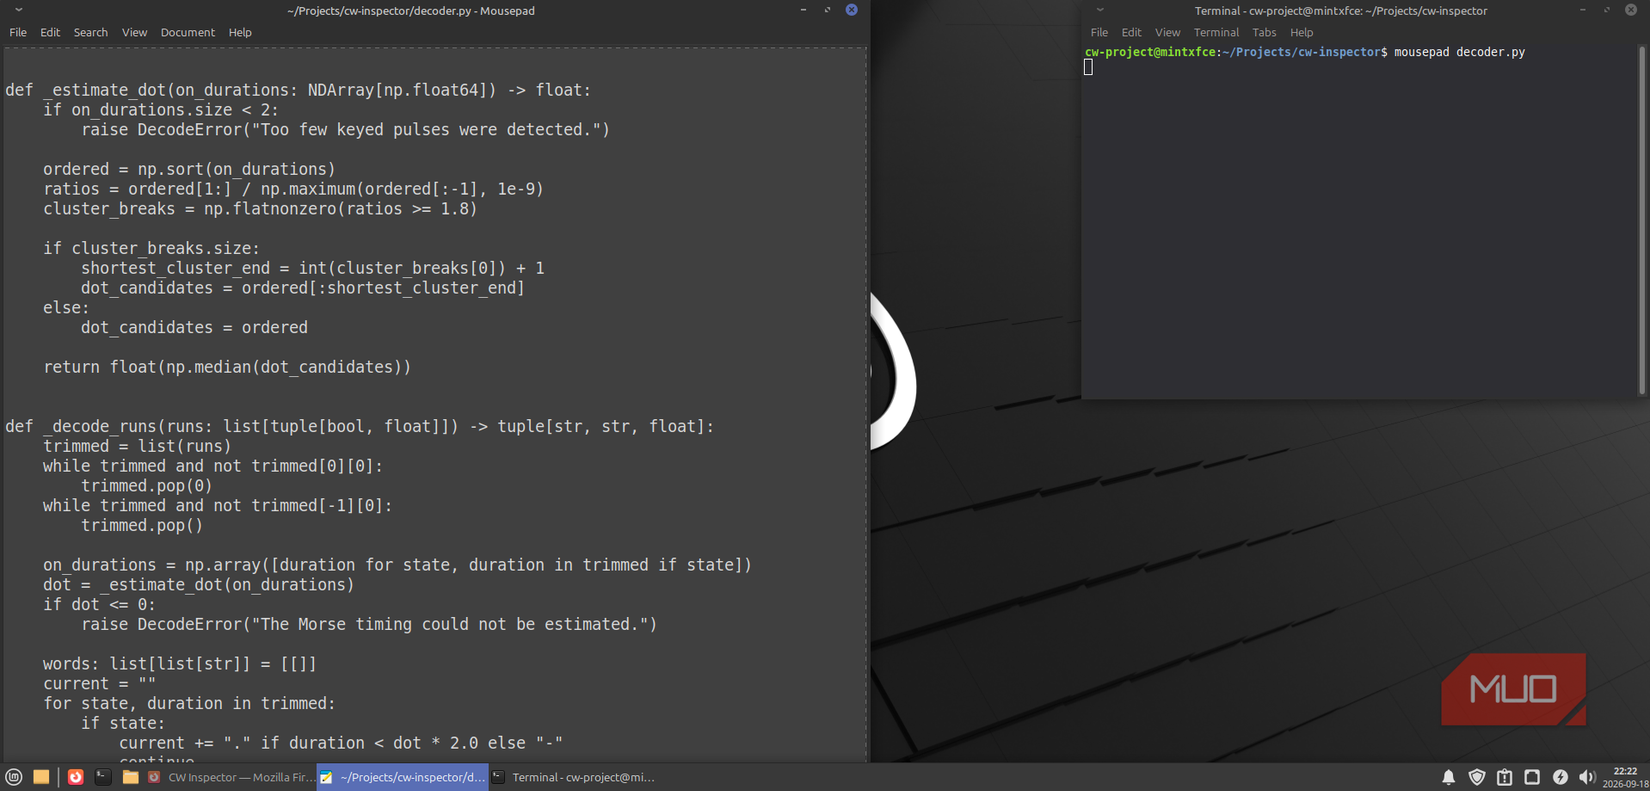
Например, когда позже приложение некорректно считало передачу с избытком тире, история промптов не решила проблему сама по себе, но сделала ясным желаемое поведение программы. При изучении исправленной функции estimate_dot я смог соотнести её операции в NumPy с конкретной задачей — отделением коротких импульсов (точек) от более длинных (тире). Предварительное написание спецификаций сделало работу с промптами значительно медленнее, но заметно упростило проверку незнакомых результатов.
Фиксация изменений, внесенных ИИ
Атрибуция полезна лишь тогда, когда она указывает на конкретные файлы и принятые решения. Моим четвертым правилом стало определение того, какие именно части проекта были созданы при участии ИИ, а какие — моей собственной работой. Фраза «помогал ИИ» не дает проверяющему понимания: предложил ли алгоритм несколько строк или сгенерировал всё приложение целиком.
Мой отчет о помощи включал следующие файлы и компоненты:
- app.py и decoder.py;
- HTML-шаблон и таблицу стилей;
- автоматизированные тесты;
- конфигурацию зависимостей и инструментов;
- README и документацию проекта.
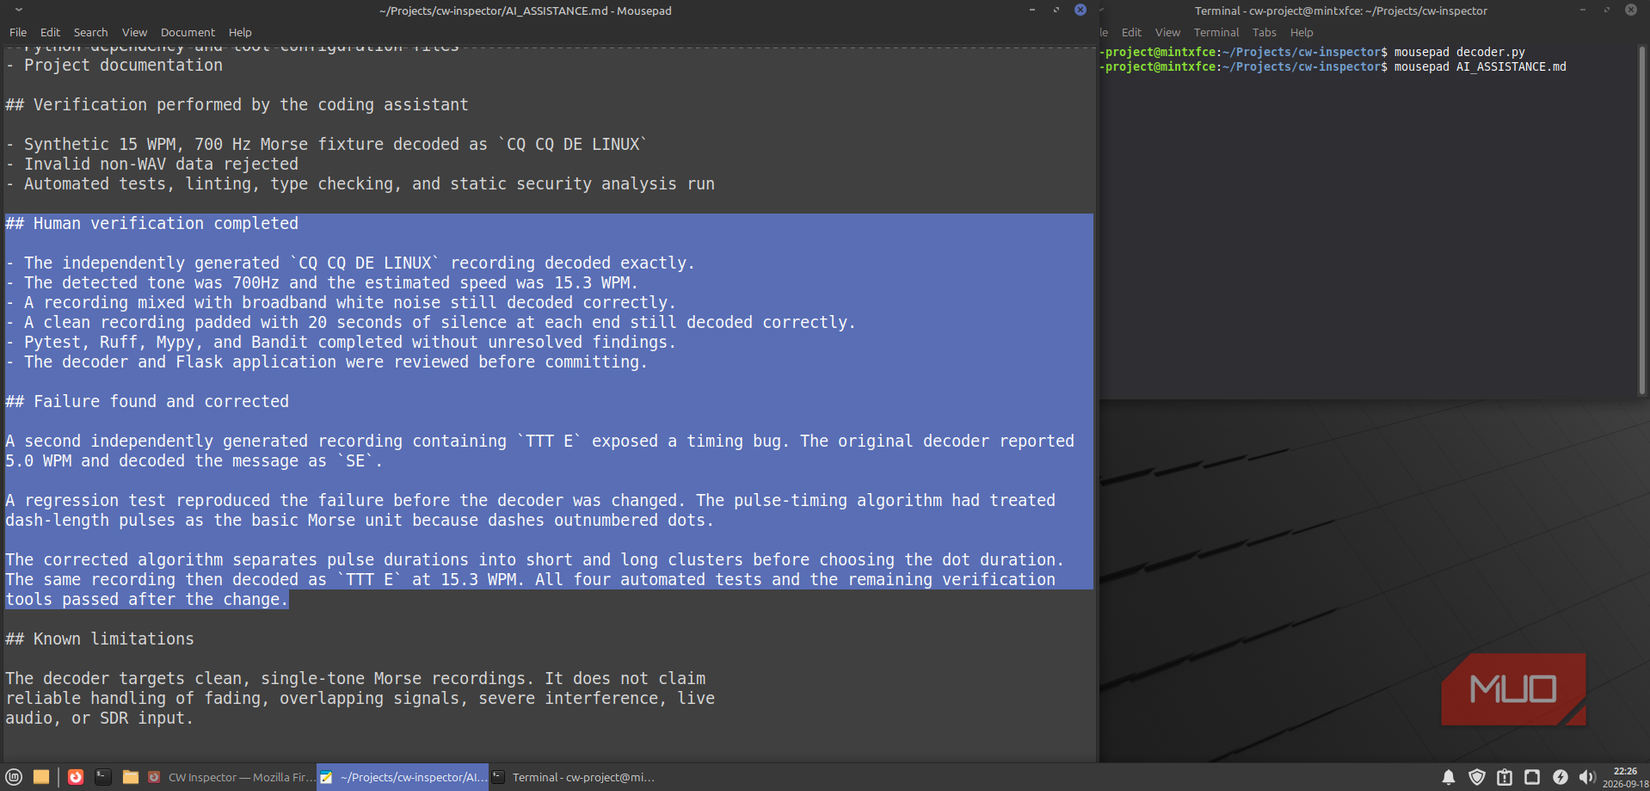
Я также разделил человеческий вклад и работу, сгенерированную нейросетью. В данном случае я предоставил спецификацию и независимые аудиофайлы, а Codex — первоначальное приложение и тесты. Затем я запустил всё внутри тестовой мини-ВМ, создал дополнительные записи, проверил вывод и подтвердил финальное исправление. Модель ни разу не сообщила о своей уязвимости в определении таймингов, но мой тест, насыщенный тире, выявил эту проблему.
Рекомендации для ядра Linux относительно ИИ проводят полезную черту, если вы не планируете вносить вклад в само ядро: ИИ-агент не может подписать изменения от чужого имени. Для личного приложения урок проще: не позволяйте кодирующему агенту стать последней инстанцией в том, что сохраняется или публикуется. Я лично проверил сгенерированные файлы, сам сделал финальный Git-коммит и добавил пометку Assisted-by: LLM. Я пропустил формальную сертификацию ядра Signed-off-by, так как она была неуместна для моего частного проекта. Теперь история CW Inspector хранит данные о том, кто сгенерировал код, что я лично верифицировал и где заканчивалась ответственность.
Проверка кода на практике
Самым опасным результатом оказался не сбой, а уверенный неверный ответ. Пятое правило — самое важное для «вайб-кодинга», так как оно требует документирования процесса тестирования. Вместо того чтобы доверять одному успешному прогону, я постепенно усложнял условия:
- стандартный сигнал «CQ CQ CQ DE LINUX» декодировался успешно;
- широкополосный белый шум не вызвал ошибок;
- двадцать секунд тишины до и после передачи также не создали проблем;
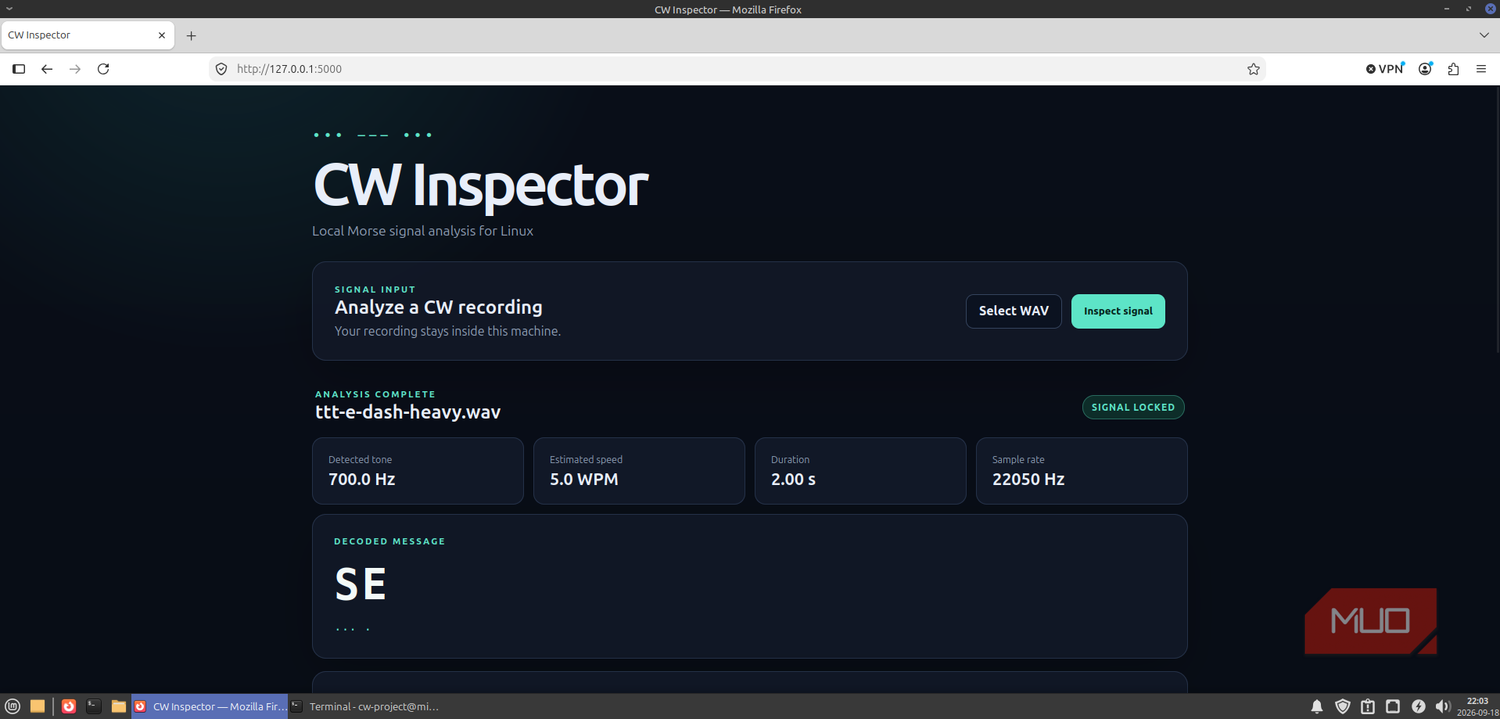
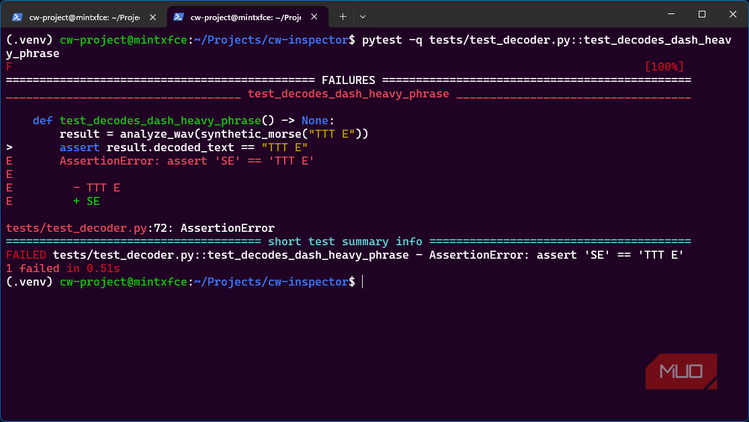
- запись с избытком тире, содержащая «TTT E», наконец вскрыла серьезный изъян в таймингах.
Правильная азбука Морзе для этого примера — «- — — / .», но CW Inspector вывел «… .», декодировал как «SE» и оценил скорость в 5.0 WPM вместо примерно 15 WPM. Программа не выдала ошибок и не упала; она была полностью уверена в неверном декодировании. При ИИ-кодинге работа без ошибок не доказывает правильность результата. Правдоподобный, но неверный вывод подается с полной уверенностью, что опаснее очевидного сбоя. Именно поэтому правила ядра Linux так полезны.
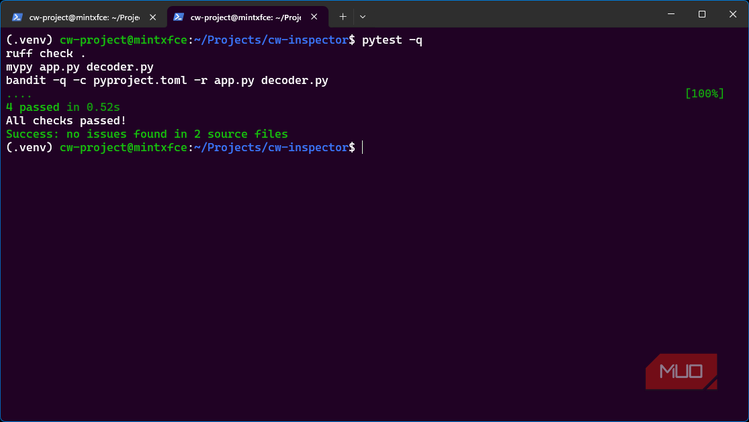
Следуя процедуре исправления ошибок ядра, я подтвердил проблему и превратил её в повторяемый тест Pytest. Тест официально доказал, что декодер возвращает «SE» вместо «TTT E». Только после этого я внес правки. Здесь критически важным оказался мой опыт в любительском радио. Зная, как легко спутать «T» с «E», я создал сообщение с обилием тире, где правильный результат легко проверить. Первоначальный алгоритм принимал самые короткие 55% импульсов за точки, но в этой группе доминировали тире. Исправленная функция теперь ищет большое соотношение между кластерами коротких и длинных импульсов перед тем, как фиксировать длительность точки. После правок все образцы «TTT E» декодировались верно, тесты Pytest прошли, а Mypy не нашел ошибок типизации.
Этот процесс лишает проект части той мгновенной радости, за которую ценят «вайб-кодинг». Применять правила уровня ядра к каждому одноразовому личному приложению было бы избыточно, но самые полезные элементы — одна спецификация, отчет о помощи, несколько небольших тестов и честные коммиты — определённо стоят того, чтобы их сохранить.
Принципы разработки ядра Linux и использование ИИ
Официальные рекомендации по разработке ядра Linux отнюдь не призывают разработчиков полностью отказываться от «vibe coding» — практики написания программного кода, основанной на интуиции или генерации через нейросети без глубокого погружения в технические детали. Использование подобных методов в процессе работы не запрещено.
Суть требований заключается в ином: разработчиков просят не перекладывать бремя понимания и разбора созданного кода на плечи другого человека. Важно осознавать, что под этим «другим человеком» подразумевается не только коллега, но и сам автор кода в будущем, когда ему потребуется вернуться к написанному ранее проекту.