Практическое объединение вычислительных мощностей DGX Station
В нашей лаборатории одновременно оказались две системы GB300 DGX Station: ASUS ExpertCenter Pro ET900N G3 и HP ZGX Fury AI Station. Разместив эти башни рядом, мы решили соединить их, чтобы оценить, какой прирост производительности даст добавление второй системы для выполнения скоординированных задач искусственного интеллекта на рабочих местах. Концепция масштабирования настольных комплексов не нова: NVIDIA продвигала её еще для платформы GB10, а ключевой особенностью DGX Spark была возможность начать работу с одного узла и добавлять новые по мере роста нагрузки.
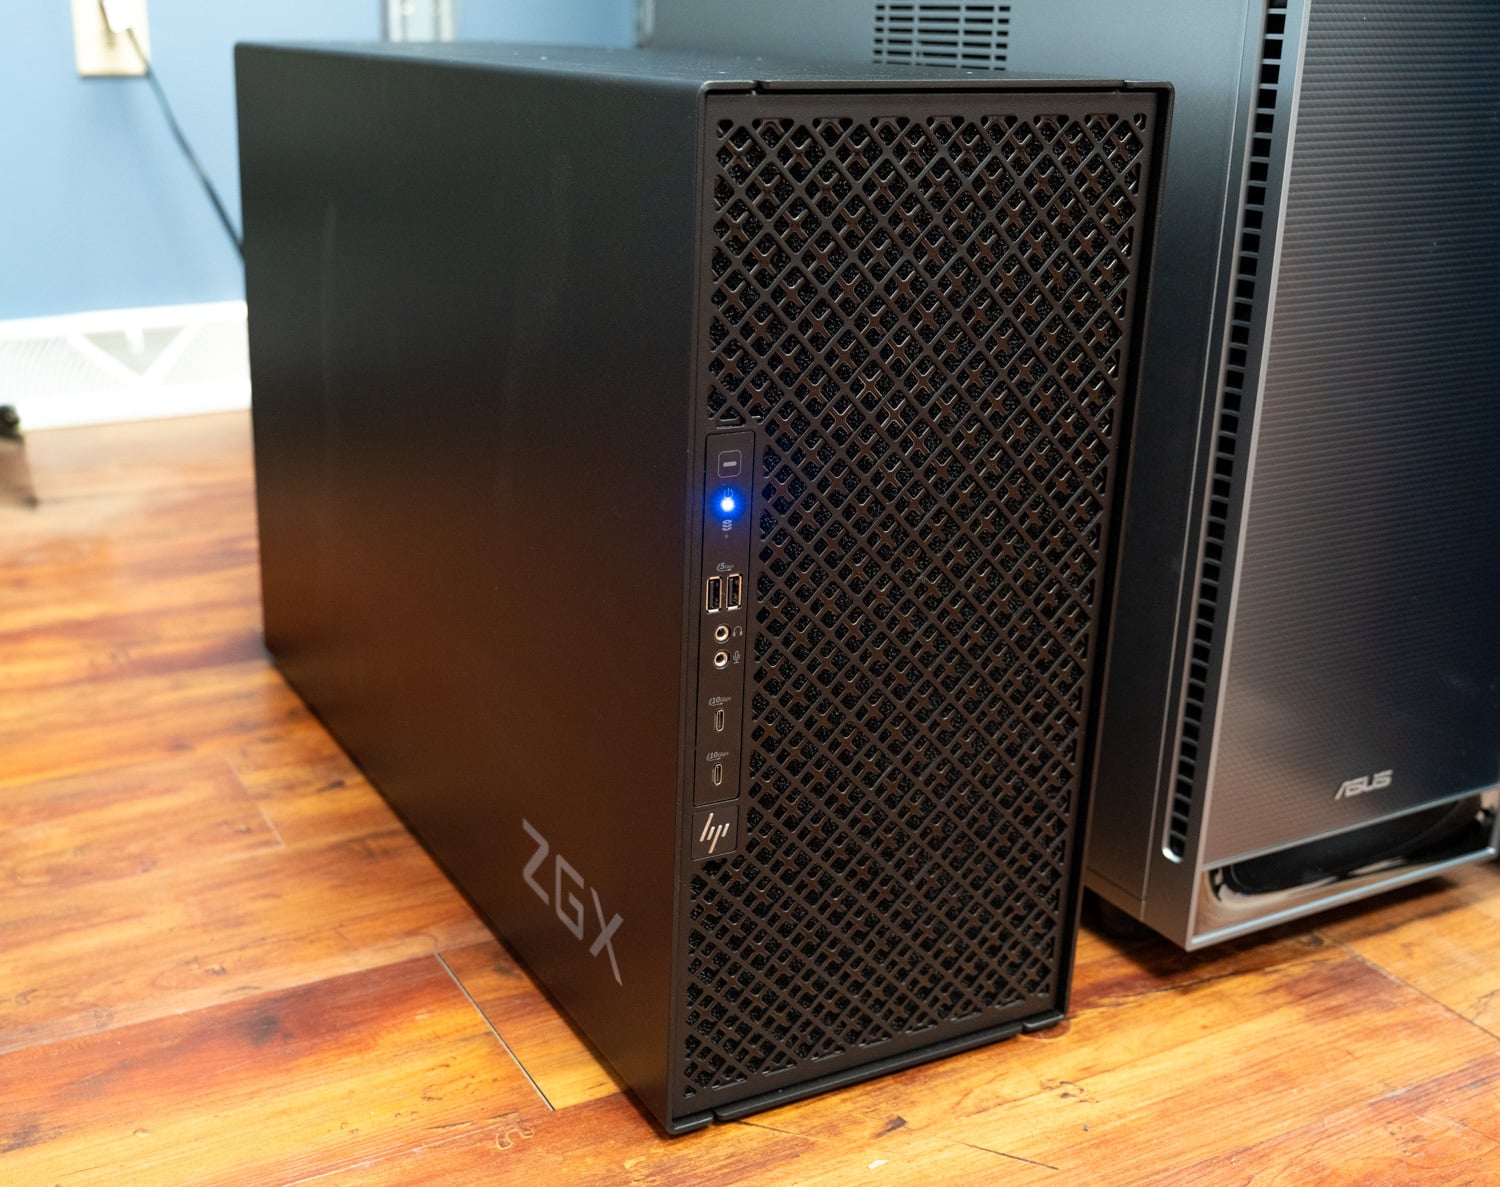
Несмотря на высокую изначальную производительность GB300, работа с крупными моделями или обслуживание большого количества пользователей способны создать пиковую нагрузку даже на самые мощные настольные станции. Как мы отмечали в обзоре MSI, если рабочие задачи оправдывают приобретение одной станции, логично ожидать, что со временем потребуется и несколько таких систем. Стоимость остается определяющим фактором для расширения, но понимание того, как две станции работают в связке, дает пользователю представление о выгоде последующего масштабирования.
Сетевые возможности DGX Station
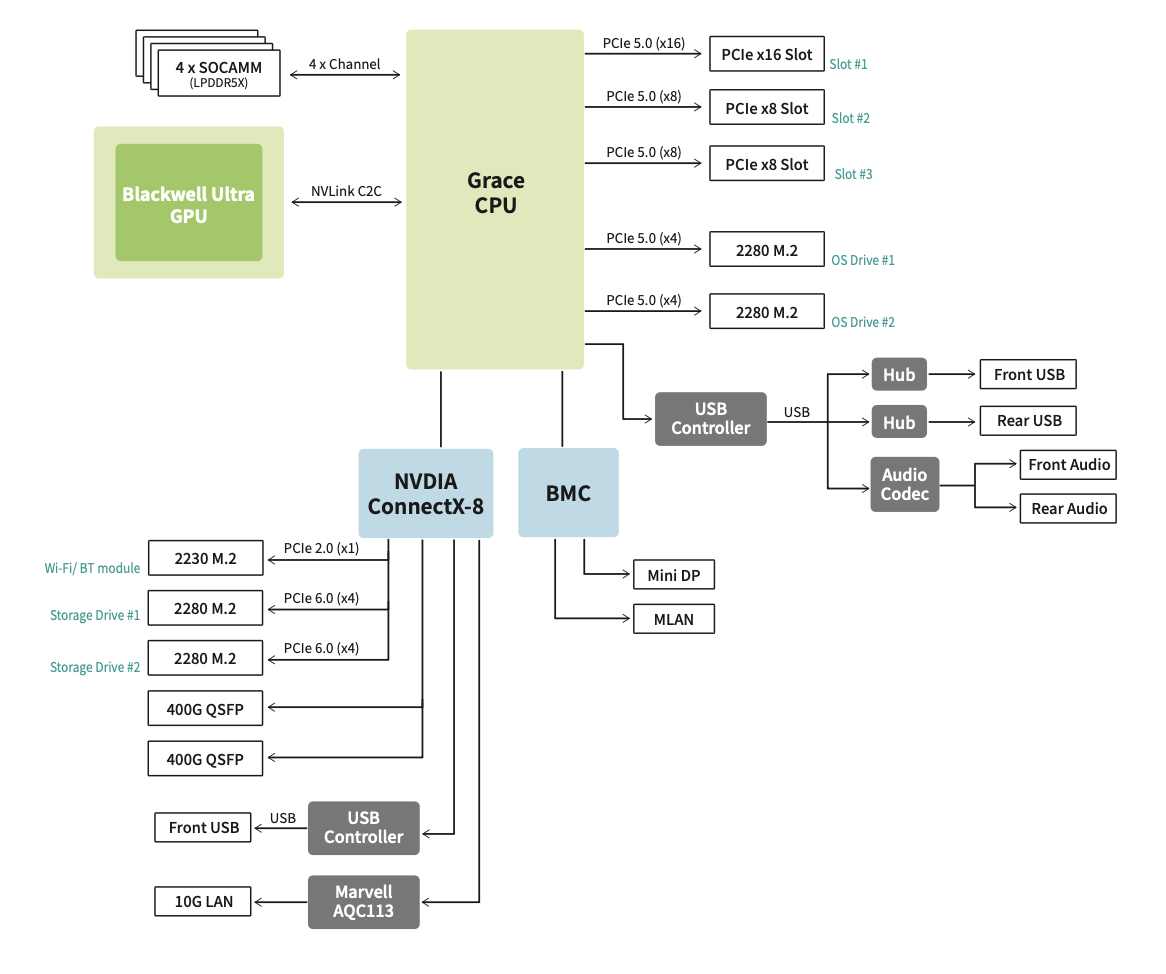
Прежде чем переходить к кластеризации, стоит напомнить о сетевом оснащении, которое мы рассматривали в обзоре MSI. Карта ConnectX-8 SuperNIC выполняет не только функции связи: её встроенный PCIe-коммутатор управляет частью внутренней подсистемы ввода-вывода станции, обеспечивая соединение с процессором Grace и двумя слотами накопителей PCIe Gen 6 x4. Для внешних соединений система предлагает два порта QSFP112, каждый с пропускной способностью 400 Гбит/с, что дает суммарно 800 Гбит/с для связи станций друг с другом или подключения к более крупной сети.
Для сравнения: контроллер ConnectX-7 в составе DGX Spark был ограничен пропускной способностью PCIe в системе GB10. Он располагался за двумя раздельными линиями PCIe 5.0 x4, что ограничивало полезную суммарную пропускную способность сети примерно до 200 Гбит/с. При этом два физических порта отображались в Linux как четыре логических интерфейса. Для получения полной полосы пропускания требовалось сопоставлять эти интерфейсы с соответствующими ячейками, настраивать их и обеспечивать использование обоих путей PCIe для трафика RDMA.
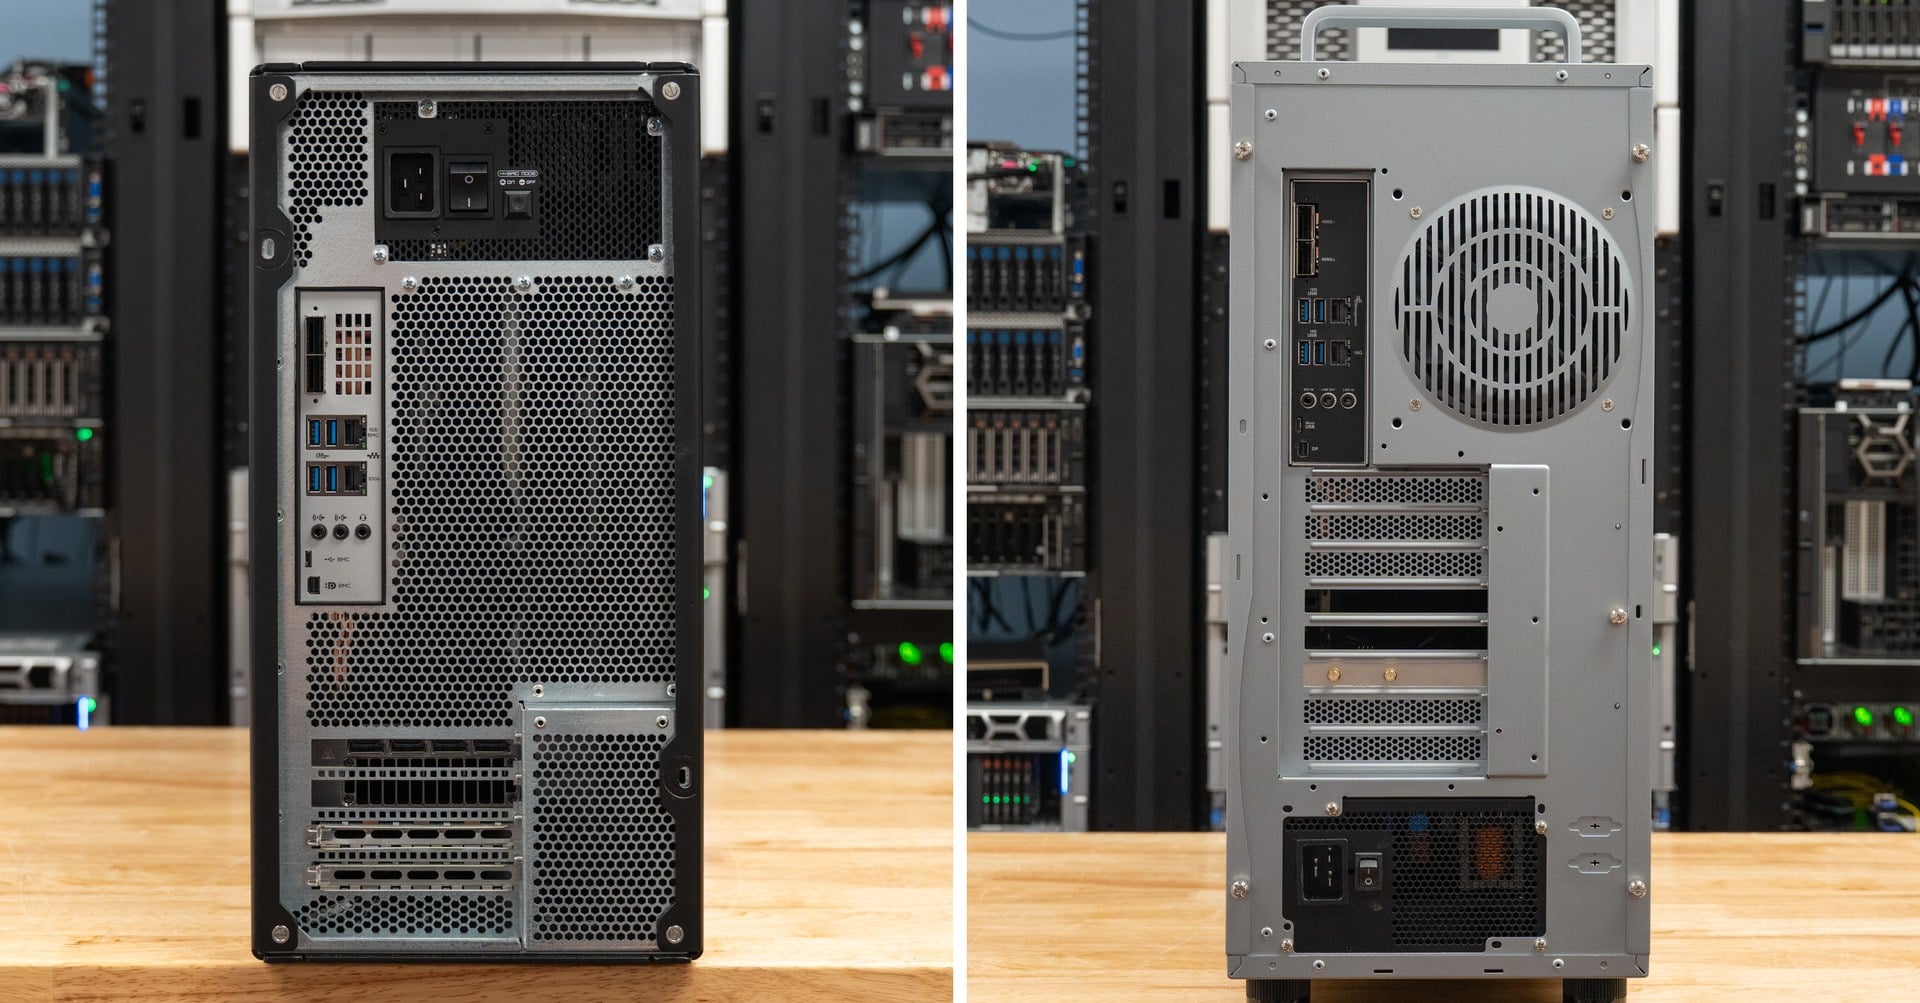
GB300 предлагает более простую архитектуру с двумя портами по 400 Гбит/с, каждый из которых работает как независимый сетевой рельс. Увеличение полезной пропускной способности в четыре раза по сравнению с DGX Spark повышает требования к охлаждению портов QSFP. В ходе тестов все системы справились с этой нагрузкой. Сам контроллер ConnectX-8 имеет жидкостное охлаждение; некоторые вендоры, такие как MSI, распространяют его на корпуса QSFP, в то время как другие, согласно нашему обзору ASUS, применяют радиаторы и выделенные вентиляторы. Такой подход эффективен, особенно для оптических модулей, которые нагреваются сильнее пассивных DAC-кабелей. Наша практика показала надежность обоих методов охлаждения.
Настройка кластера из двух станций
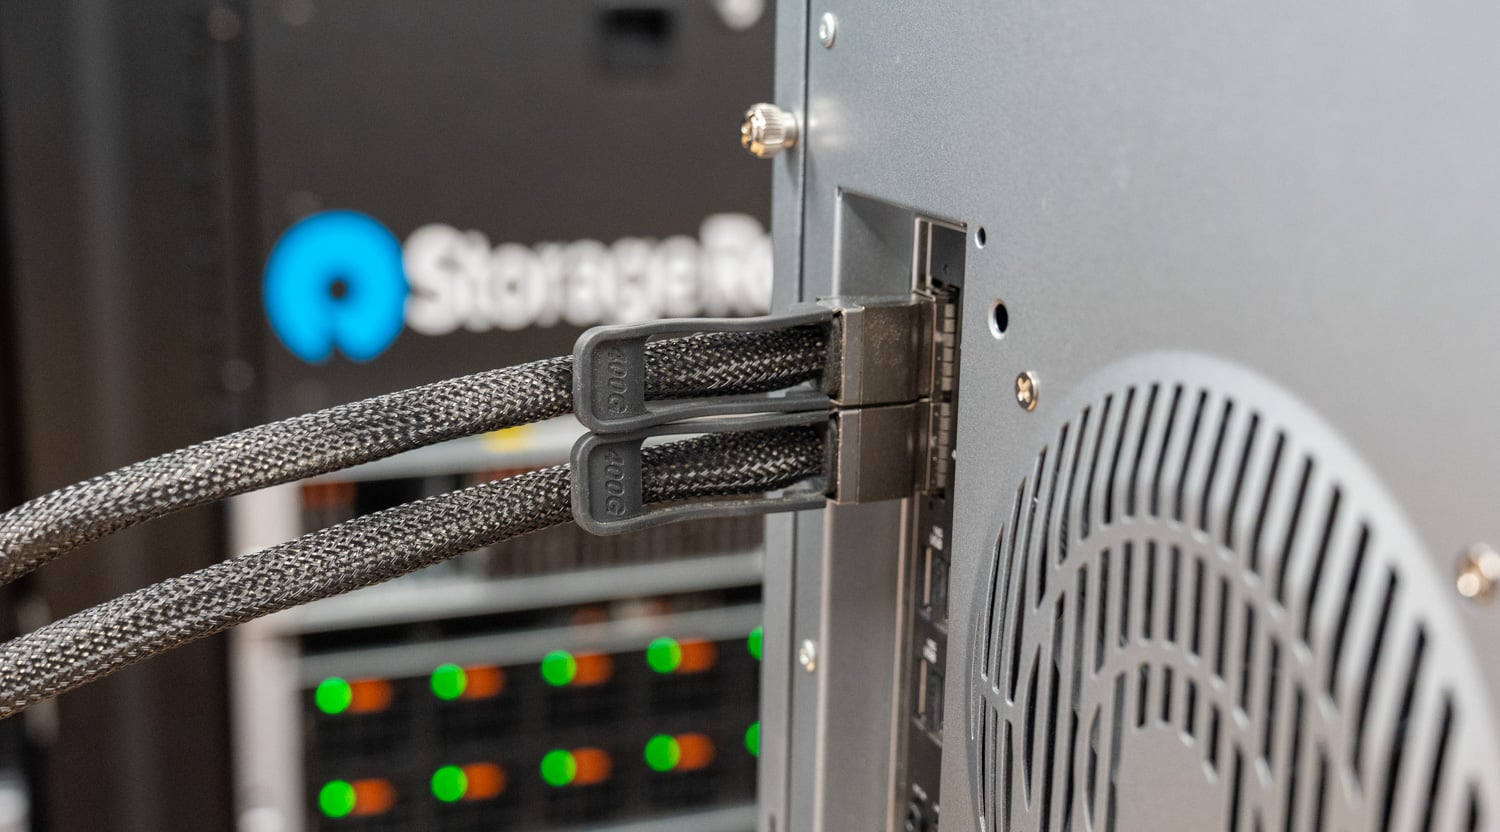
Процесс объединения двух станций оказался простым: мы соединили ASUS и HP напрямую двумя медными кабелями прямого подключения (DAC) 400G, используя соответствующие порты QSFP112, что обеспечило два независимых канала по 400 Гбит/с. NVIDIA предоставляет подробное руководство по кластеризации, которое оказалось достаточно понятным, чтобы доверить настройку Claude Code. Скрипт настроил сеть между станциями, провел тесты пропускной способности NCCL и предоставил отчет.
Методика представляет собой пошаговый сценарий, запускаемый с третьей машины, которая имеет доступ к обеим станциям по SSH. Порты соединяются как соответствующие рельсы (QSFP0 к QSFP0, QSFP1 к QSFP1), каждый из которых становится независимым двухточечным соединением RoCEv2. Скрипты активируют интерфейсы ConnectX-8 с MTU 9000 байт, присваивают каждому рельсу частную сеть /24 и применяют настройки времени выполнения RoCE и GPUDirect. Проверка подтверждает, что оба линка обучены на 400G, передача Jumbo-пакетов проходит по обоим каналам, а устройства RDMA (mlx5_0 и mlx5_1) активны. Тест ib_write_bw на каждом рельсе доказывает, что Fabric передает трафик RDMA. После этого NCCL направляется на оба рельса через переменную NCCL_IB_HCA=mlx5_0,mlx5_1, и задача запускается как обычный процесс на двух узлах.
Ниже представлены результаты тестов nccl-tests, отражающие коллективные операции при распределенном обучении или выводе на двух B300. Поскольку в каждой станции используется один GPU, каждая операция сводится к обмену данными между двумя графическими процессорами по паре каналов 400G. Столбец пропускной способности шины (bus bandwidth) напрямую соотносится с 100 ГБ/с (800 Гбит/с), которые обеспечивают два кабеля. Значения Peak представляют собой лучшие показатели среди всех размеров сообщений; столбец 16 GiB соответствует крупнейшему протестированному размеру сообщения, на котором пропускная способность стабилизируется.
Производительность передачи данных и методика тестирования кластера
Показатели операций broadcast, reduce и однонаправленной передачи (send/receive) достигли 98 ГБ/с, что составляет 98% от пропускной способности двух кабелей. В сценариях с одновременной передачей данных в обоих направлениях показатели оказались ниже: 92 ГБ/с для all-reduce и 80 ГБ/с для all-to-all. Результат двунаправленной передачи (send/receive) служит базовым ориентиром: при одновременной работе двух GPU на передачу скорость составила 84 ГБ/с в каждом направлении, что дает в сумме 167 ГБ/с по каналу связи.
Вторая таблица отражает данные ниже уровня NCCL — непосредственно для RDMA-пути при использовании ib_write_bw по одной линии (rail). В тестах GPUDirect с передачей 1 МБ данных из HBM одного B300 в HBM другого (при прямом чтении и записи NIC в память GPU) обе линии показали 392 Гбит/с, что соответствует 98% пропускной способности канала. Показатели для памяти хоста, служащие базовым стресс-тестом, при использовании одной очереди (queue pair) с обращением к памяти Grace, составили 228 Гбит/с при заявленных NVIDIA характеристиках для 400G-линии на уровне 220–230 Гбит/с. Задержка (latency) при 8-байтовой записи составила в среднем 1,46 мкс.
Подход к тестированию инференса
Из-за ограниченного времени работы с кластером основные усилия были сосредоточены на инференсе — наиболее востребованной сегодня рабочей нагрузке в сфере ИИ. В будущем планируется расширение тестирования на более крупные кластеры. В текущем материале акцент сделан на крупных моделях с сопоставлением одиночной станции и конфигурации из двух станций с использованием тензорного параллелизма (TP) и дезагрегации префилла/декодирования (PD).
Тензорный параллелизм разделяет весовые тензоры и вычислительные процессы модели между несколькими GPU. В конфигурации TP2 каждая система B300 содержит часть модели, и обе работают над каждым запросом. Это увеличивает объем доступной памяти с высокой пропускной способностью (HBM) для размещения весов, а также повышает вычислительные мощности. Однако данный метод требует обмена промежуточными результатами между GPU и синхронизации через NCCL в ходе инференса, что увеличивает накладные расходы на коммуникацию.
Дезагрегированный инференс распределяет стадии префилла (prefill) и декодирования (decode) запроса между отдельными исполнителями (workers). Префилл обрабатывает входной промпт и формирует KV-кэш — состояние внимания, которое модель повторно использует при генерации. Декодирование использует это состояние для поочередной генерации выходных токенов. Эти этапы имеют разные требования: префилл требователен к вычислениям, а декодирование — к пропускной способности памяти. В крупных системах такой подход позволяет оператору масштабировать исполнителей независимо в зависимости от нагрузки.
При одноузловой конфигурации, когда обе фазы разделяют одного исполнителя, vLLM может чередовать работу по префиллу для входящих промптов с декодированием уже активных запросов. Обработка промптов при этом может увеличивать время между генерацией выходных токенов. В конфигурации PD одна станция выполняет префилл и передает KV-кэш запроса на другую станцию для декодирования. Каждый исполнитель имеет доступ к собственной копии модели, включая данные в памяти Grace. В результате исполнитель декодирования больше не вынужден планировать обработку новых промптов одновременно с генерацией токенов, что повышает пропускную способность инференса.
Выбор метода и методология
Выбор подхода определялся требованиями модели к объему памяти. Для крупнейших чекпоинтов, где одной станции приходилось выгружать значительную часть весов в память Grace, тензорный параллелизм (TP) показал лучшую производительность, так как распределение весов между двумя GPU позволяло удерживать больший объем данных в HBM, снижая штраф за выгрузку. Для моделей, которые умещались в одну станцию (полностью в HBM или с ограниченной выгрузкой в Grace), применялась дезагрегация PD. Это коснулось, в частности, модели DeepSeek V4.1 Flash с таблицами поиска Engram в DRAM процессора Grace.
Для сохранения преемственности с предыдущими публикациями была использована методология с фиксированной длиной входных (ISL) и выходных (OSL) последовательностей. Сбалансированная нагрузка использует 512 входных и 512 выходных токенов, а нагрузка с преобладанием префилла — 8 192 входных и 1 024 выходных токена. Варьируется количество параллельных запросов при фиксированной длине последовательностей. Базовым показателем для одиночной станции служит ASUS ET900N G3 из предыдущего обзора (до 32 потоков), для двухстанционных конфигураций — до 256 потоков. Каждая точка на графике — результат единичного прохода.
Конфигурация и производительность DeepSeek V4.1 Flash
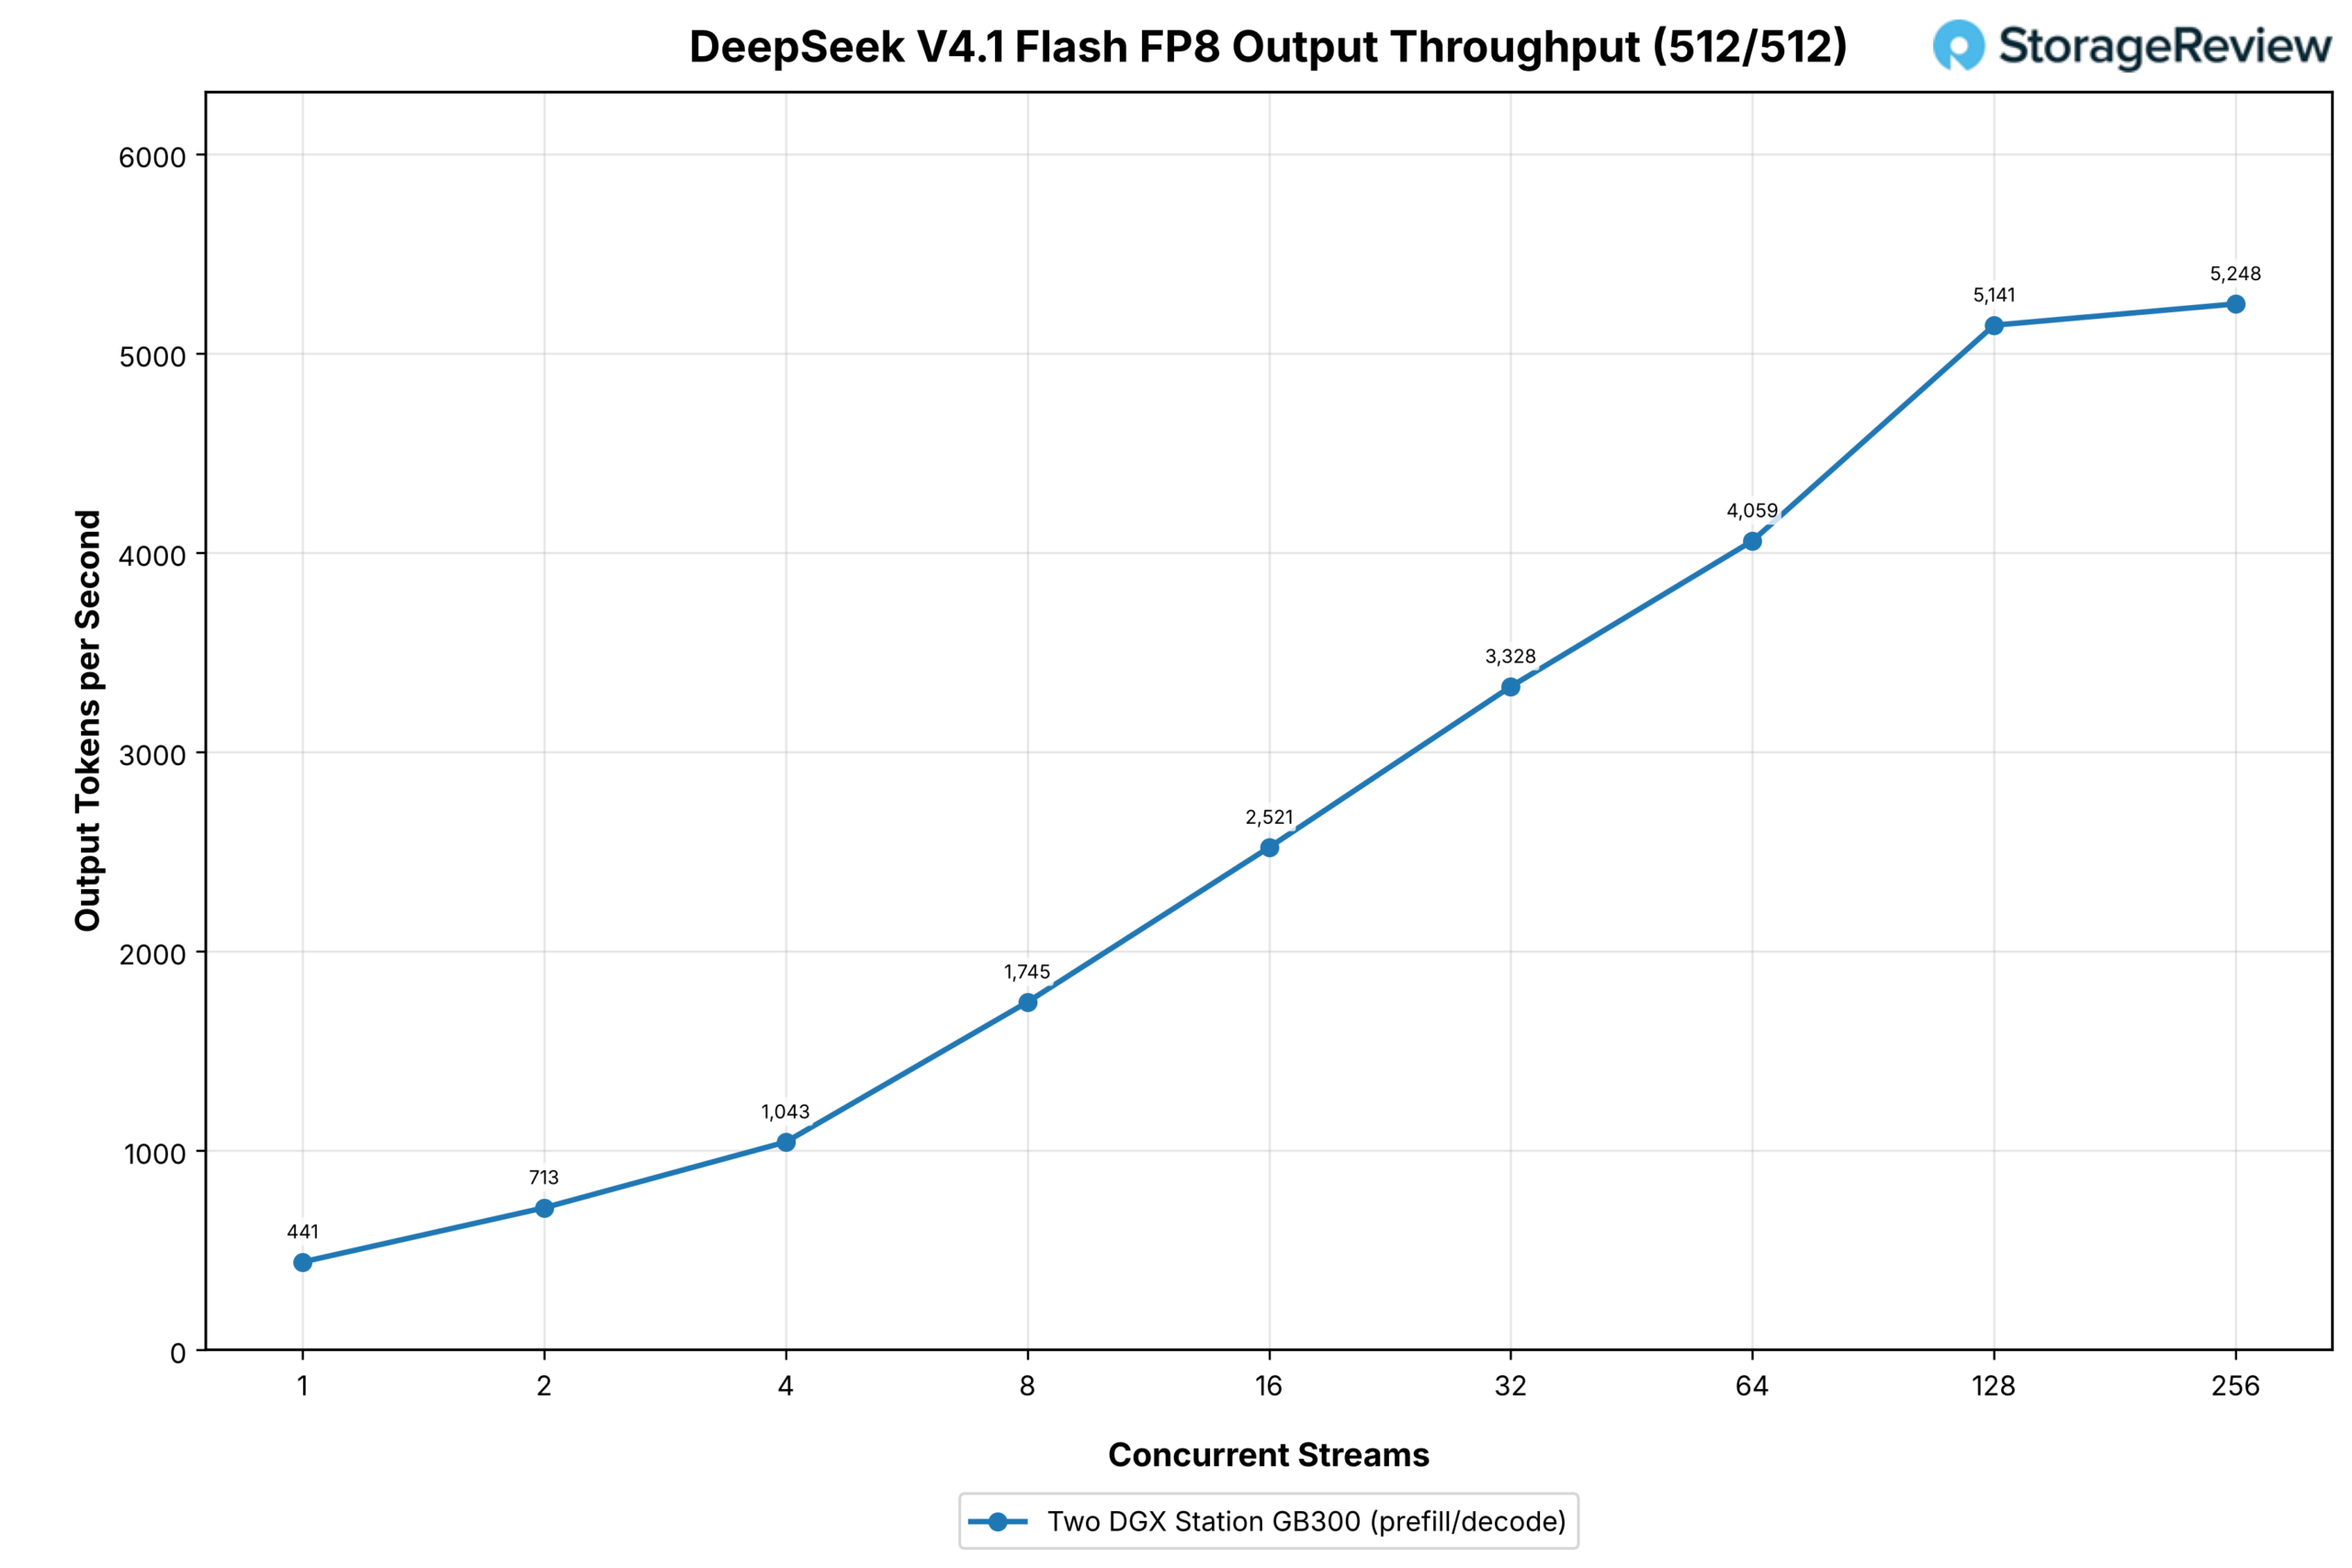
Модель DeepSeek V4.1 Flash работала в дезагрегированном режиме: одна станция отвечала за префилл, другая — за декодирование. Каждая станция удерживала полную копию модели: две таблицы FP8 Engram общим объемом 188,84 ГиБ, закрепленные в памяти Grace, и 131,97 ГБ экспертных весов, выгруженных в Grace. Это единственная конфигурация, где задействована память Grace на обеих машинах. Также это единственная модель без линии для одиночной станции, так как в обзоре ASUS тестировался более ранний чекпоинт V4 Flash, и они не являются напрямую сопоставимыми.
Производительность моделей в кластерных конфигурациях
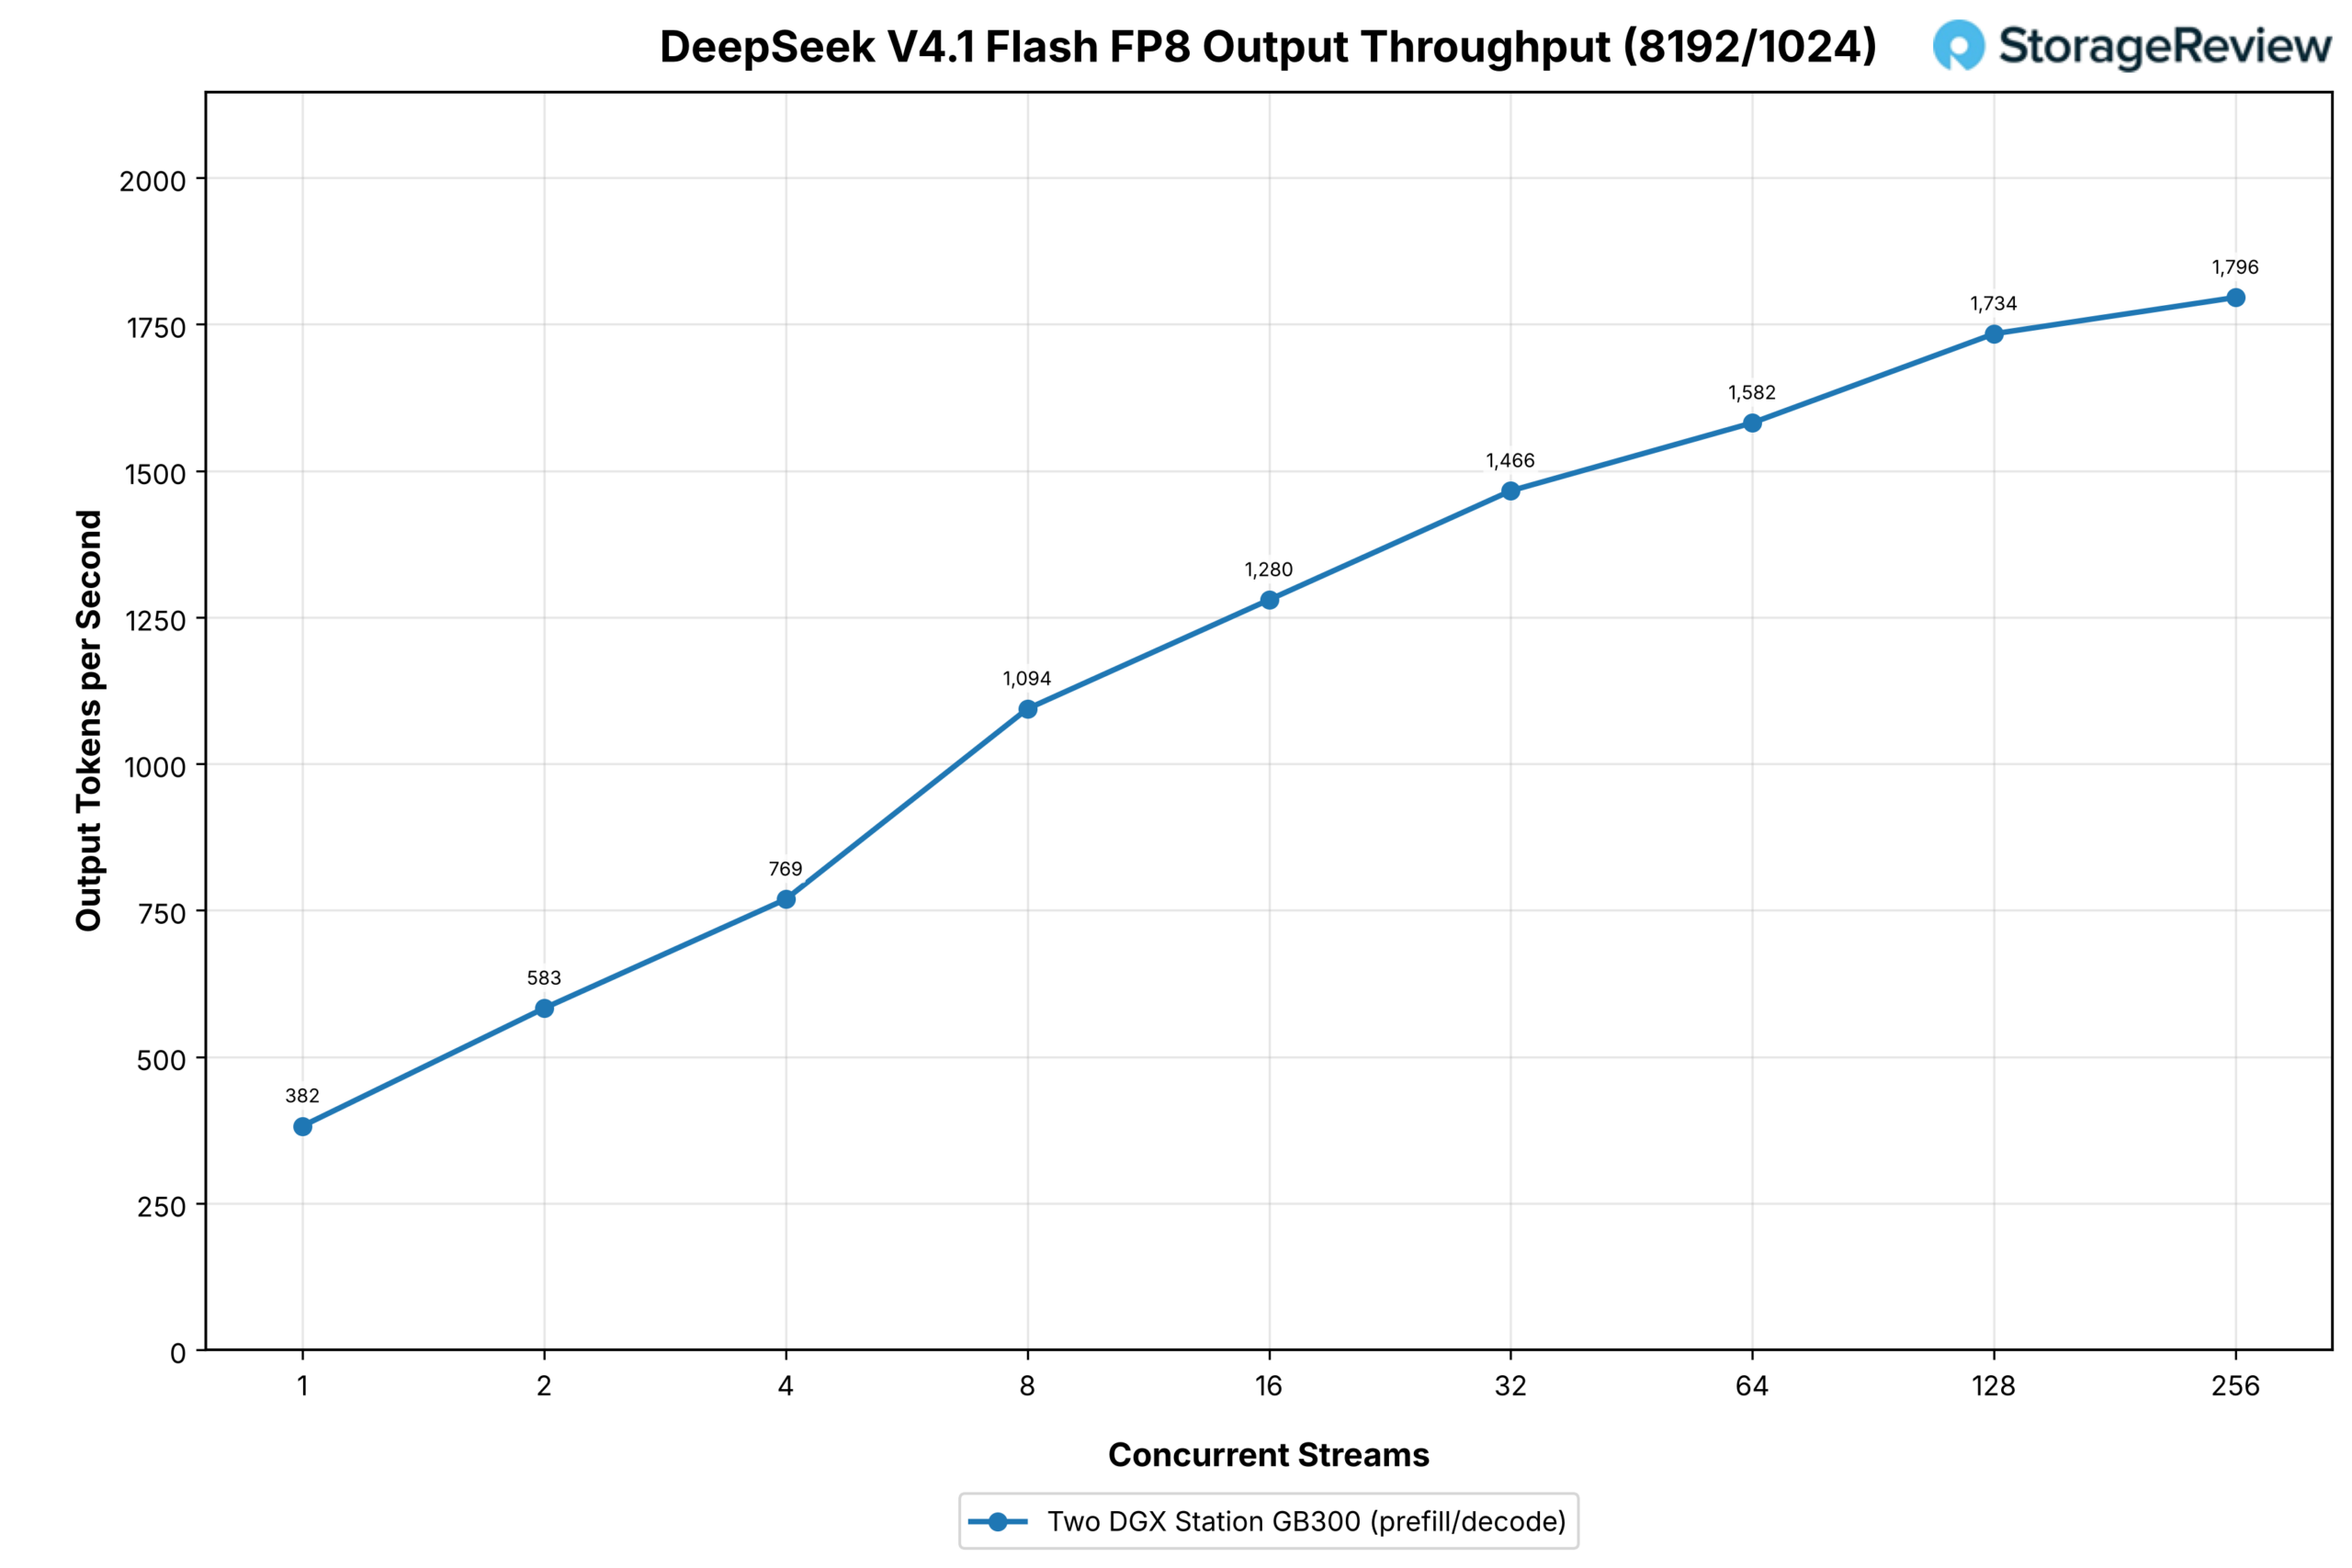
На двухсерверном кластере базовая модель FP8 демонстрировала пропускную способность от 441 выходного токена в секунду при одном потоке до 3328 при 32, 5141 при 128 и 5248 при 256. Это самый высокий показатель среди всех протестированных моделей, причем кривая выходила на плато только в самом конце диапазона. Для сравнения: в нашем обзоре одна станция ASUS обрабатывала V4 Flash со скоростью 1766 выходных токенов в секунду при 32 потоках. В профиле с интенсивным префиллом (prefill-heavy) кластер показал результат от 382 токенов в секунду при одном потоке до 1466 при 32 и 1796 при 256. Учитывая, что каждый запрос содержит 8192 входных токена, общая пропускная способность в пике достигла 16 163 токенов в секунду. Благодаря тому, что таблицы Engram и 131,97 ГБ весов экспертов размещены в памяти Grace на каждой станции, графики остаются плавными на всем протяжении тестирования.
GLM-5.3
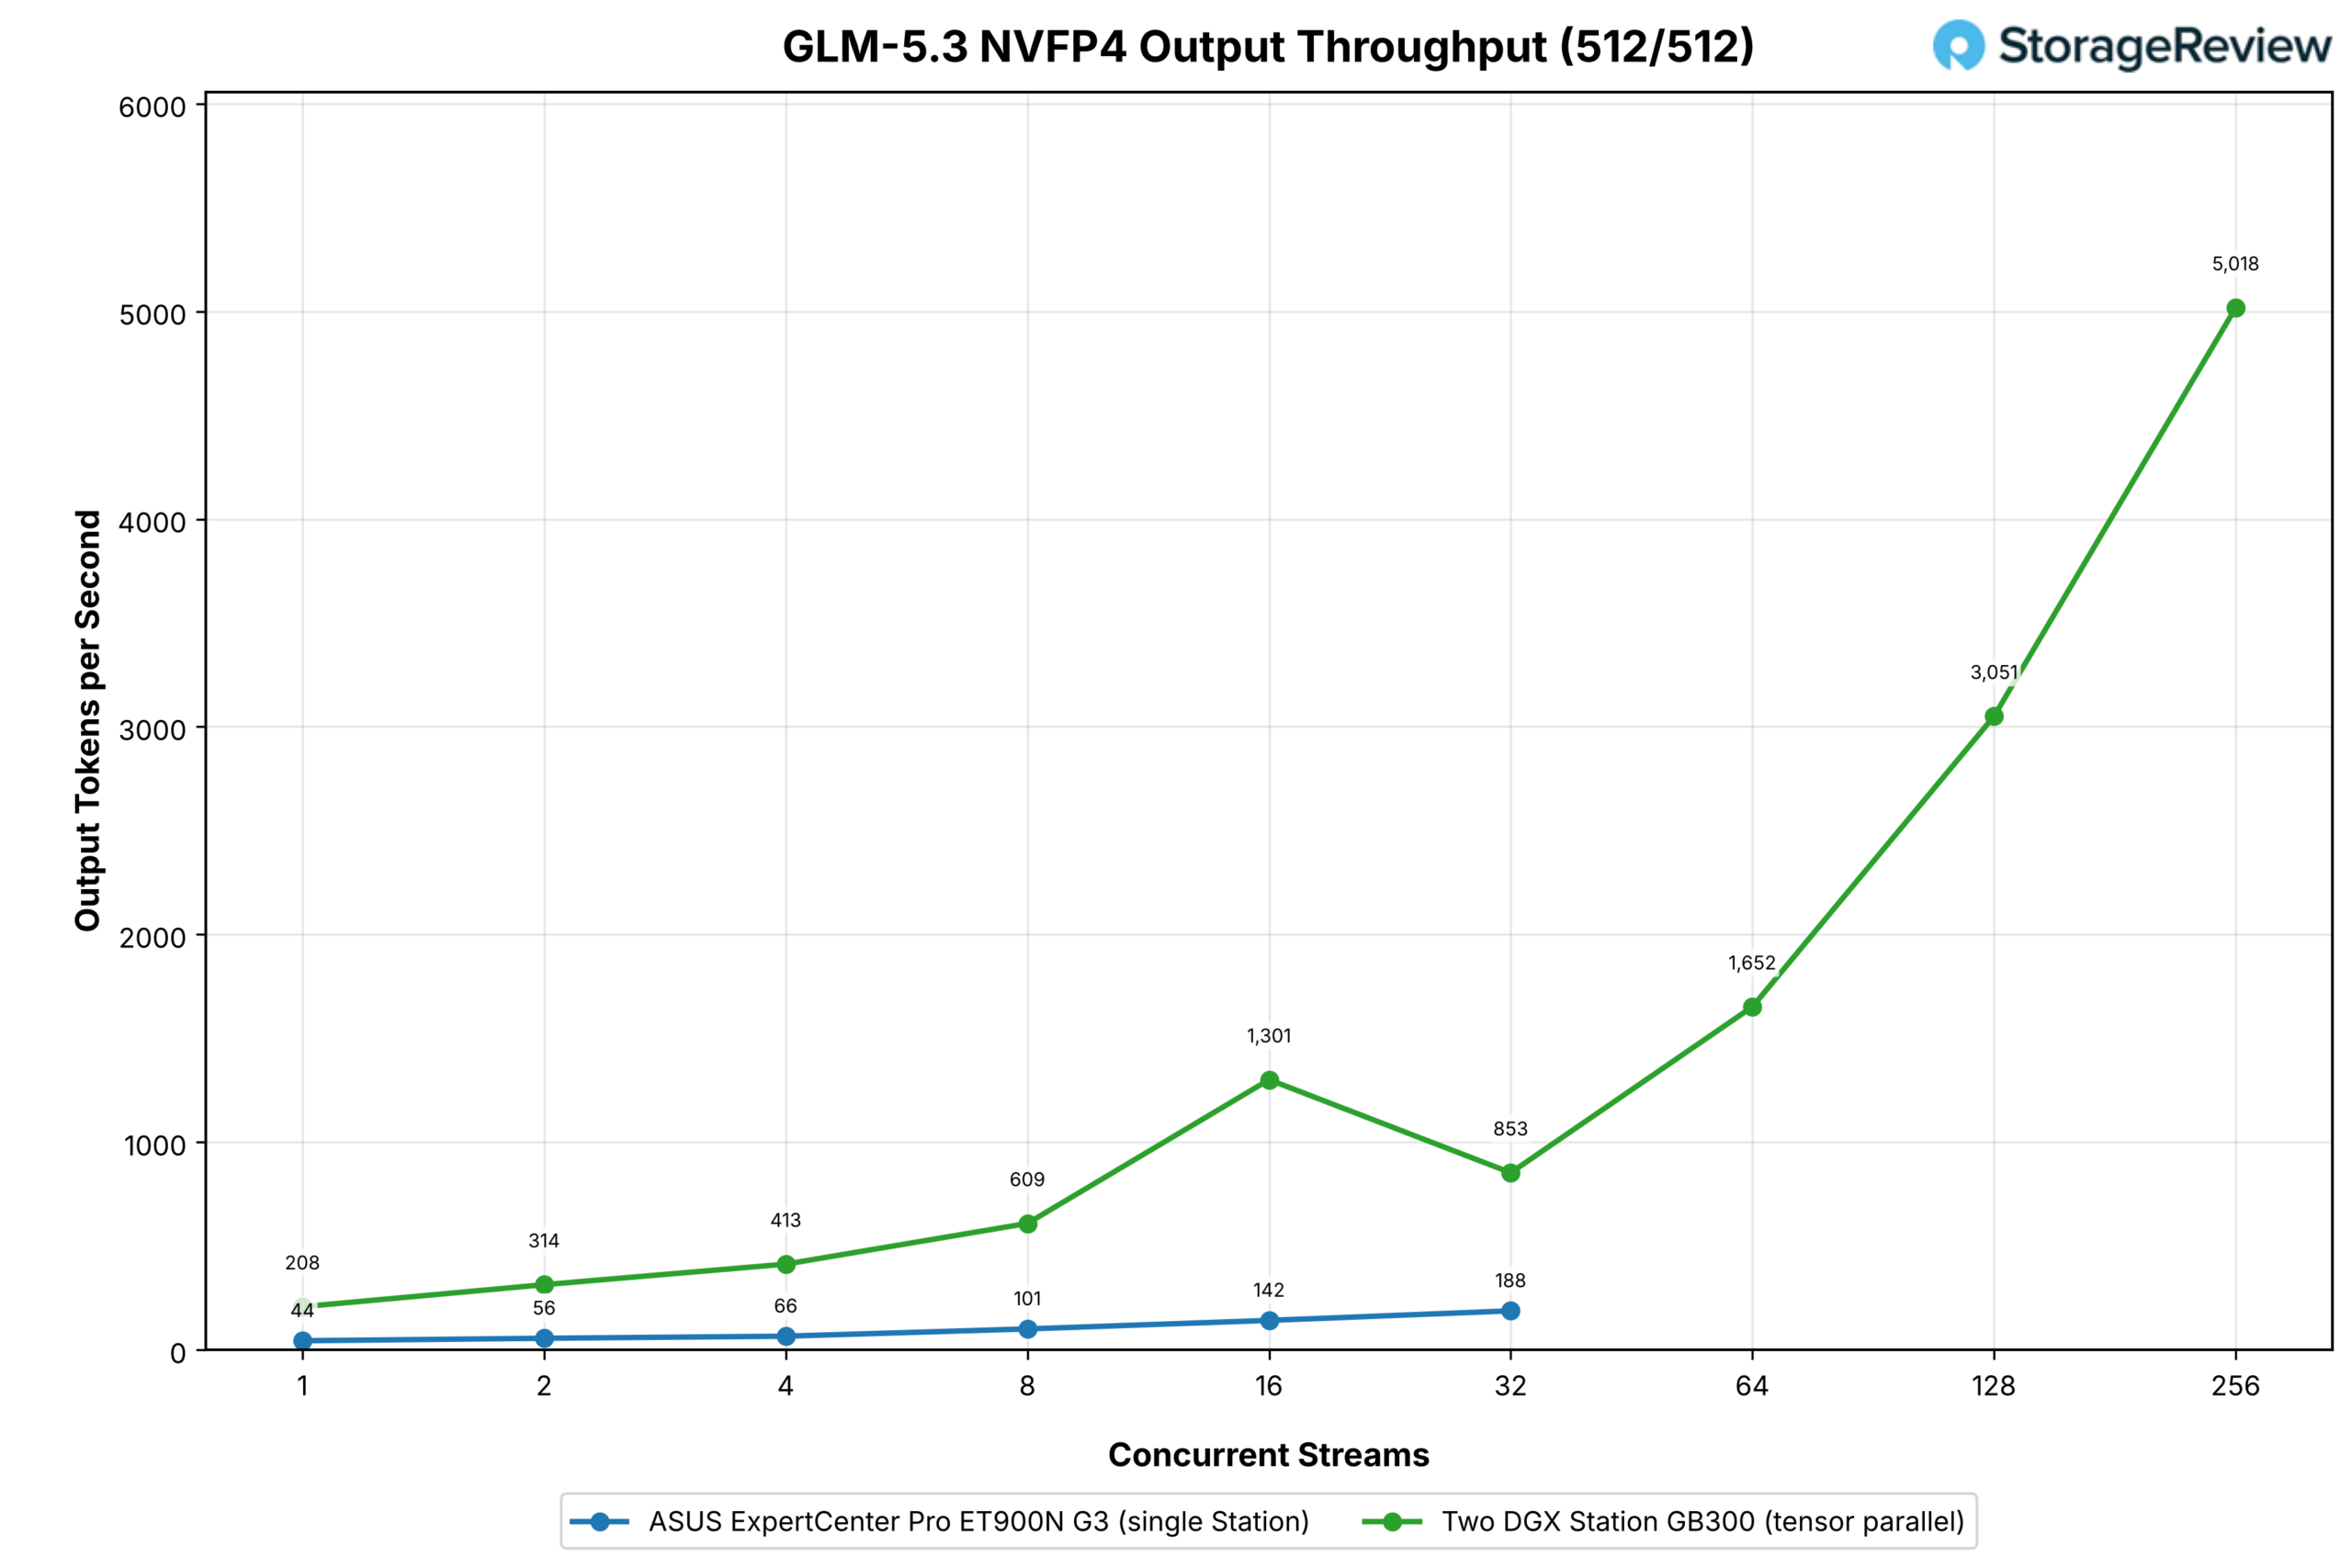
Модель GLM-5.3 работала в режиме TP2 без выгрузки (offload) в Grace. На одной станции она выгружает 215 ГБ весов экспертов в память Grace, и результаты кластера следуют за GLM-5.2 на большей части диапазона, прежде чем становятся неравномерными. Одна станция показала результат от 44 токенов в секунду при одном потоке до 188 при 32 в рамках стандартной нагрузки. Двухсерверный кластер начал с 208 токенов при одном потоке, достиг 1301 при 16 (в 4,7–9,2 раза выше, чем у одной башни), упал до 853 при 32, а затем продолжил рост до 1652 при 64, 3051 при 128 и 5018 при 256 токенах в секунду. Показатель при 32 потоках отражает собранные данные: решения по пакетной обработке и выбору ядер меняются по мере роста конкурентности, а развертывание с тензорным параллелизмом добавляет коллективную операцию на каждом слое, которая должна завершиться до следующего шага, поэтому кривая не является прямой. Однако потолок в 256 потоков в 27 раз превышает показатель одной станции при 32 потоках.
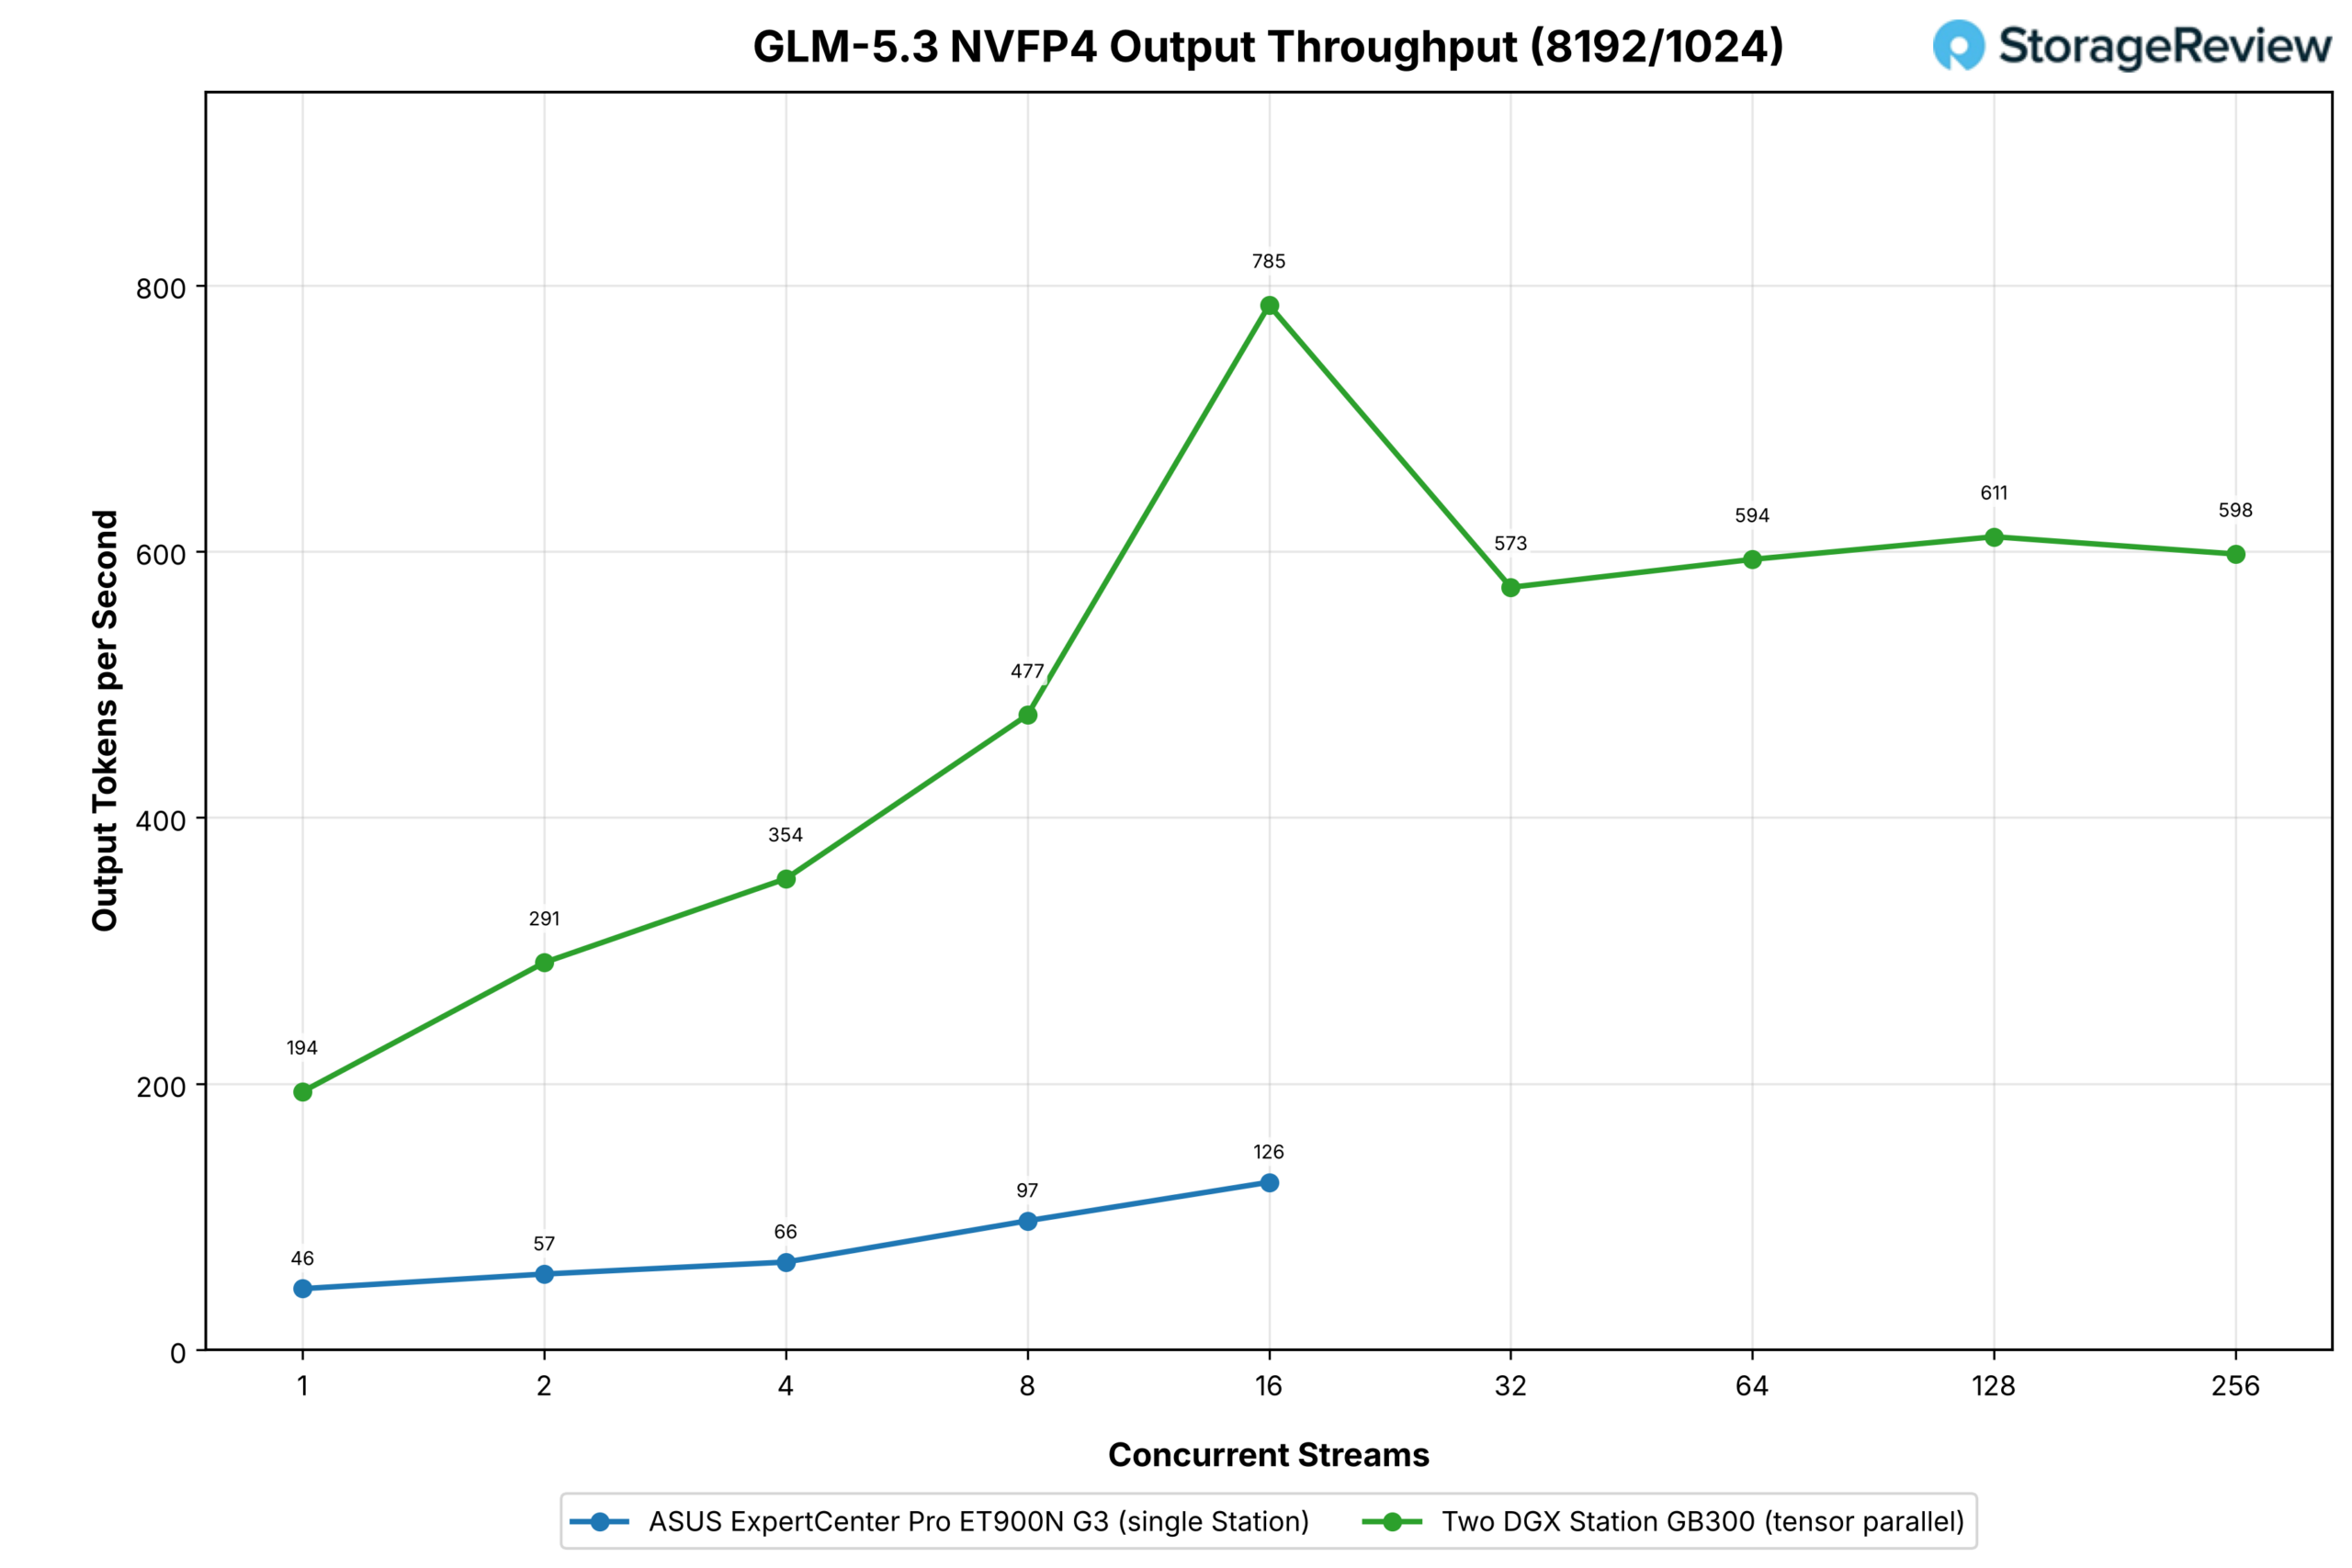
В профиле с интенсивным префиллом одна станция по проекту остановилась на 16 потоках, так как выгружаемая модель быстро выходит на плато и дальнейшее увеличение нагрузки не дает новой информации. Она показала рост от 46 до 126 выходных токенов в секунду. Кластер в том же диапазоне показал рост от 194 до 785 токенов (в 6,2 раза выше в пике), затем стабилизировался в диапазоне от 573 до 611 токенов в секунду при нагрузке от 32 до 256 потоков — это «потолок» для длинных запросов, который все равно примерно в пять раз превышает лучший результат одной станции.
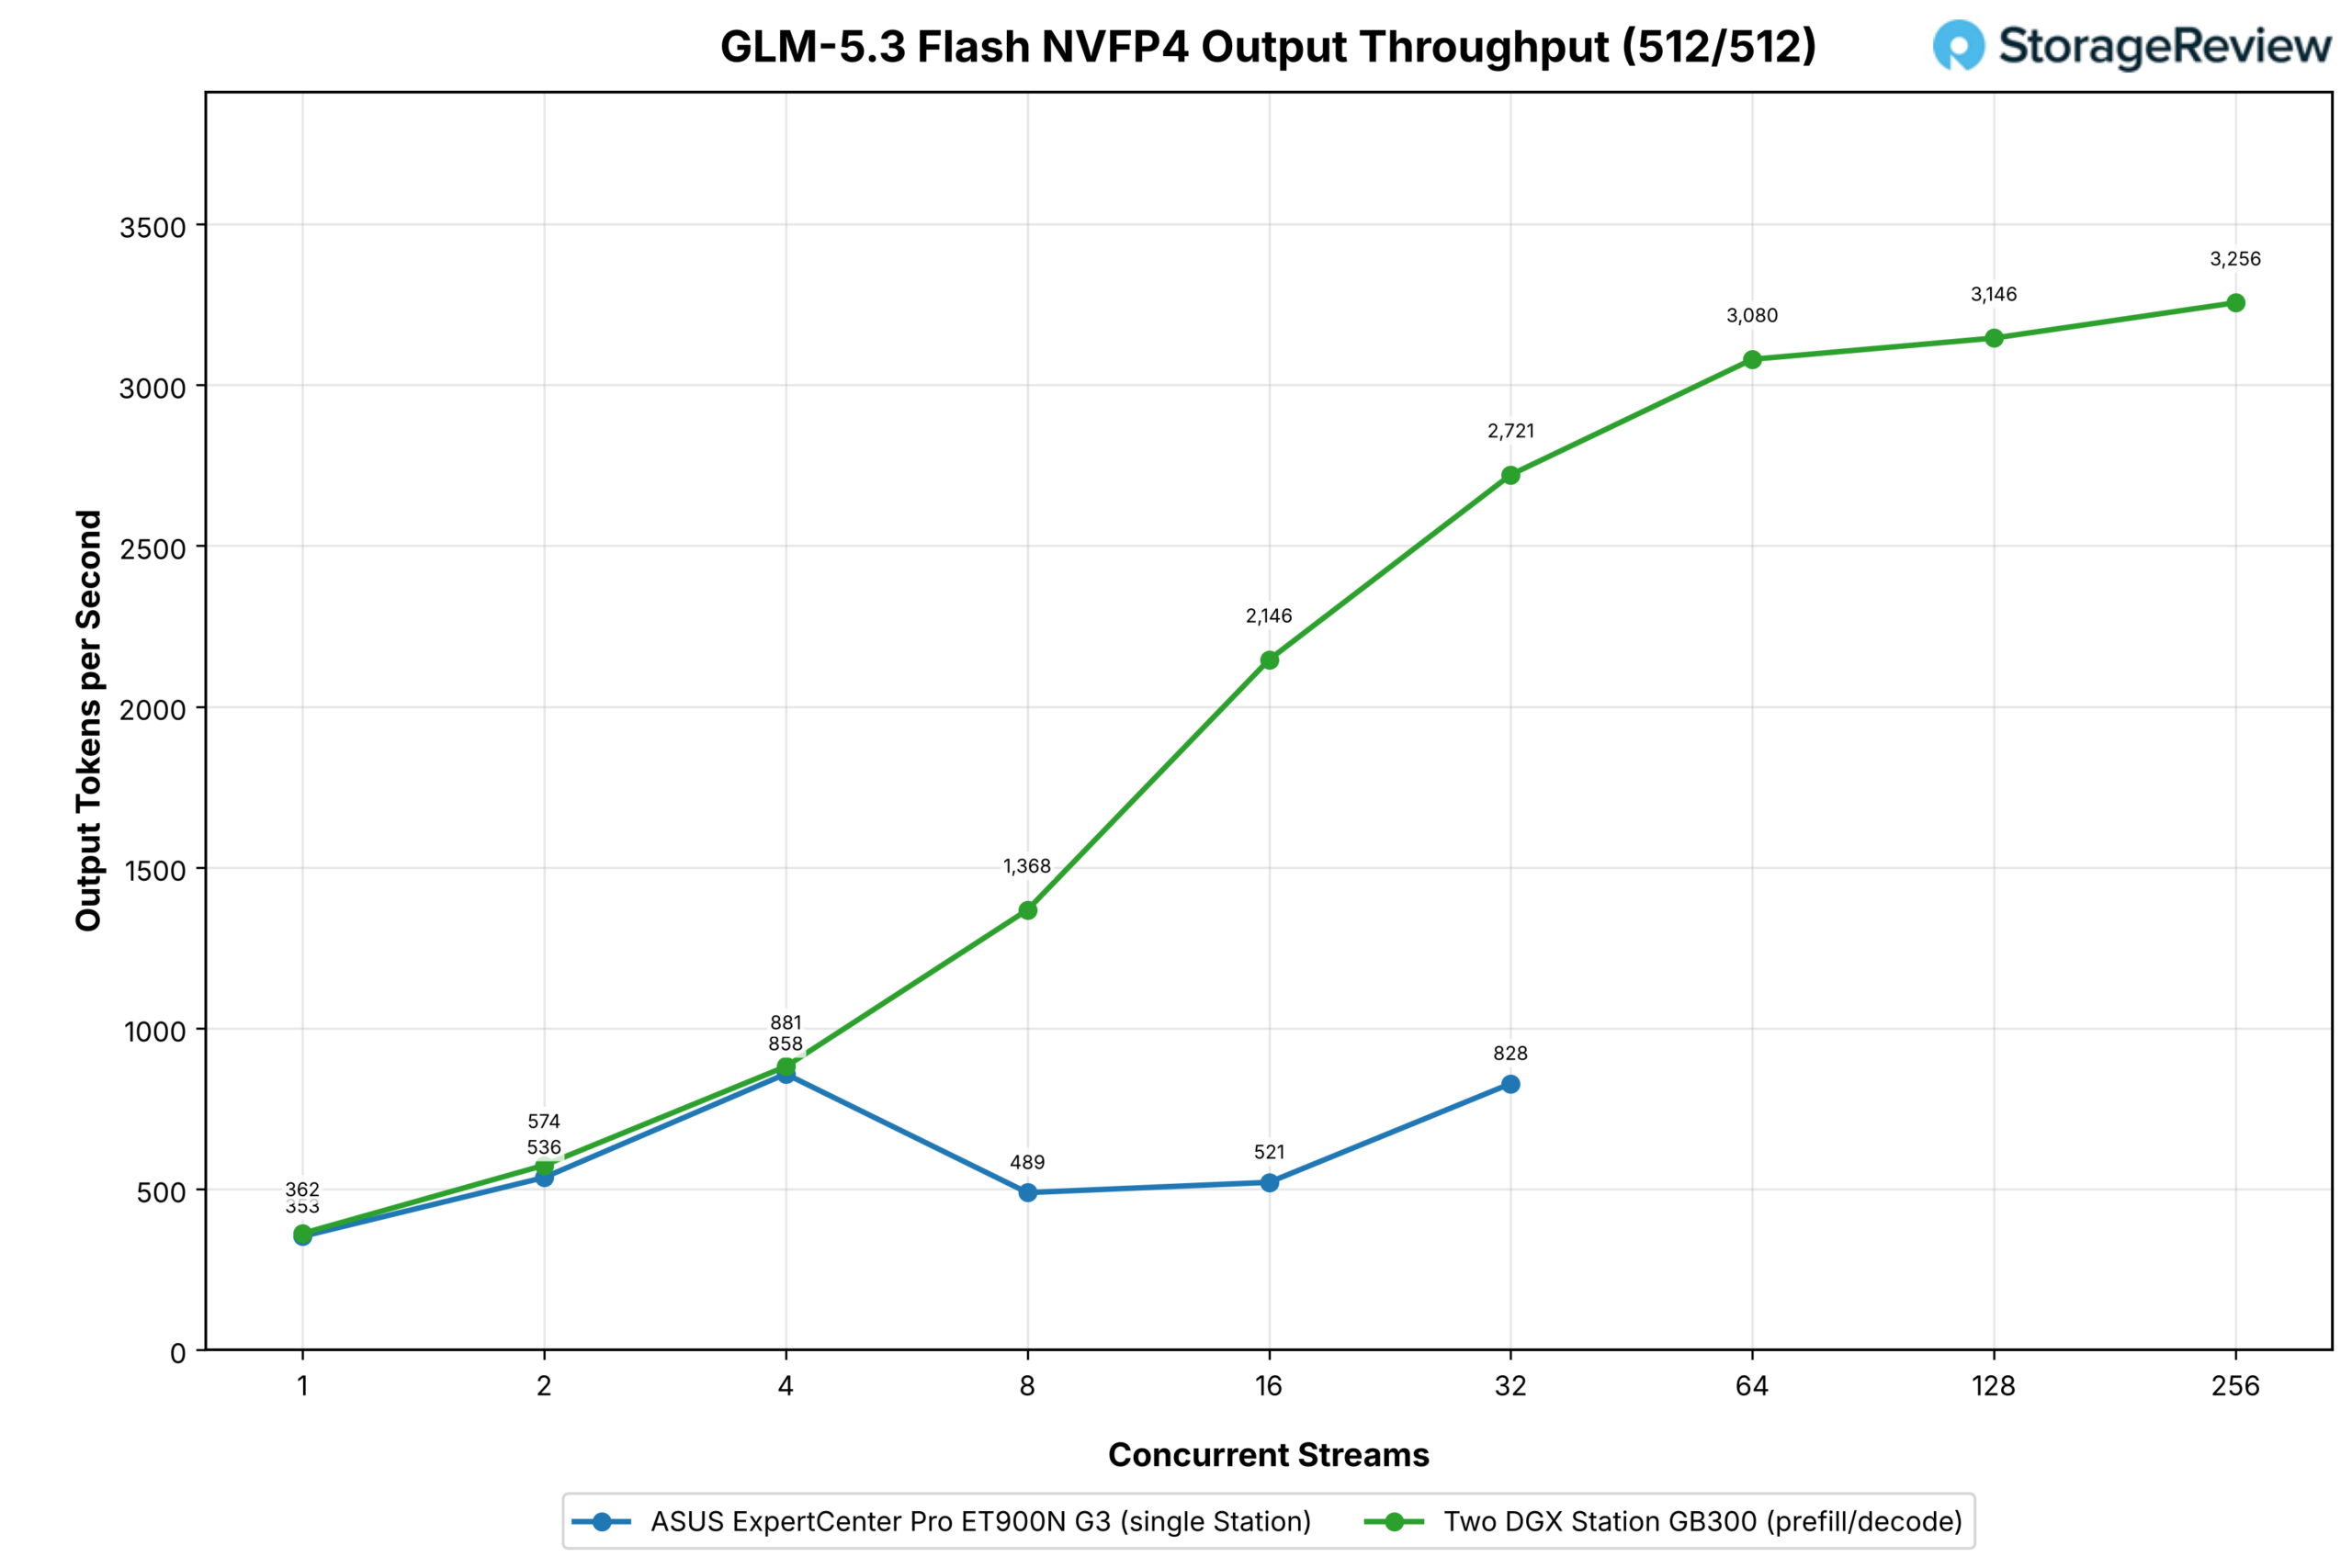
GLM-5.3 Flash
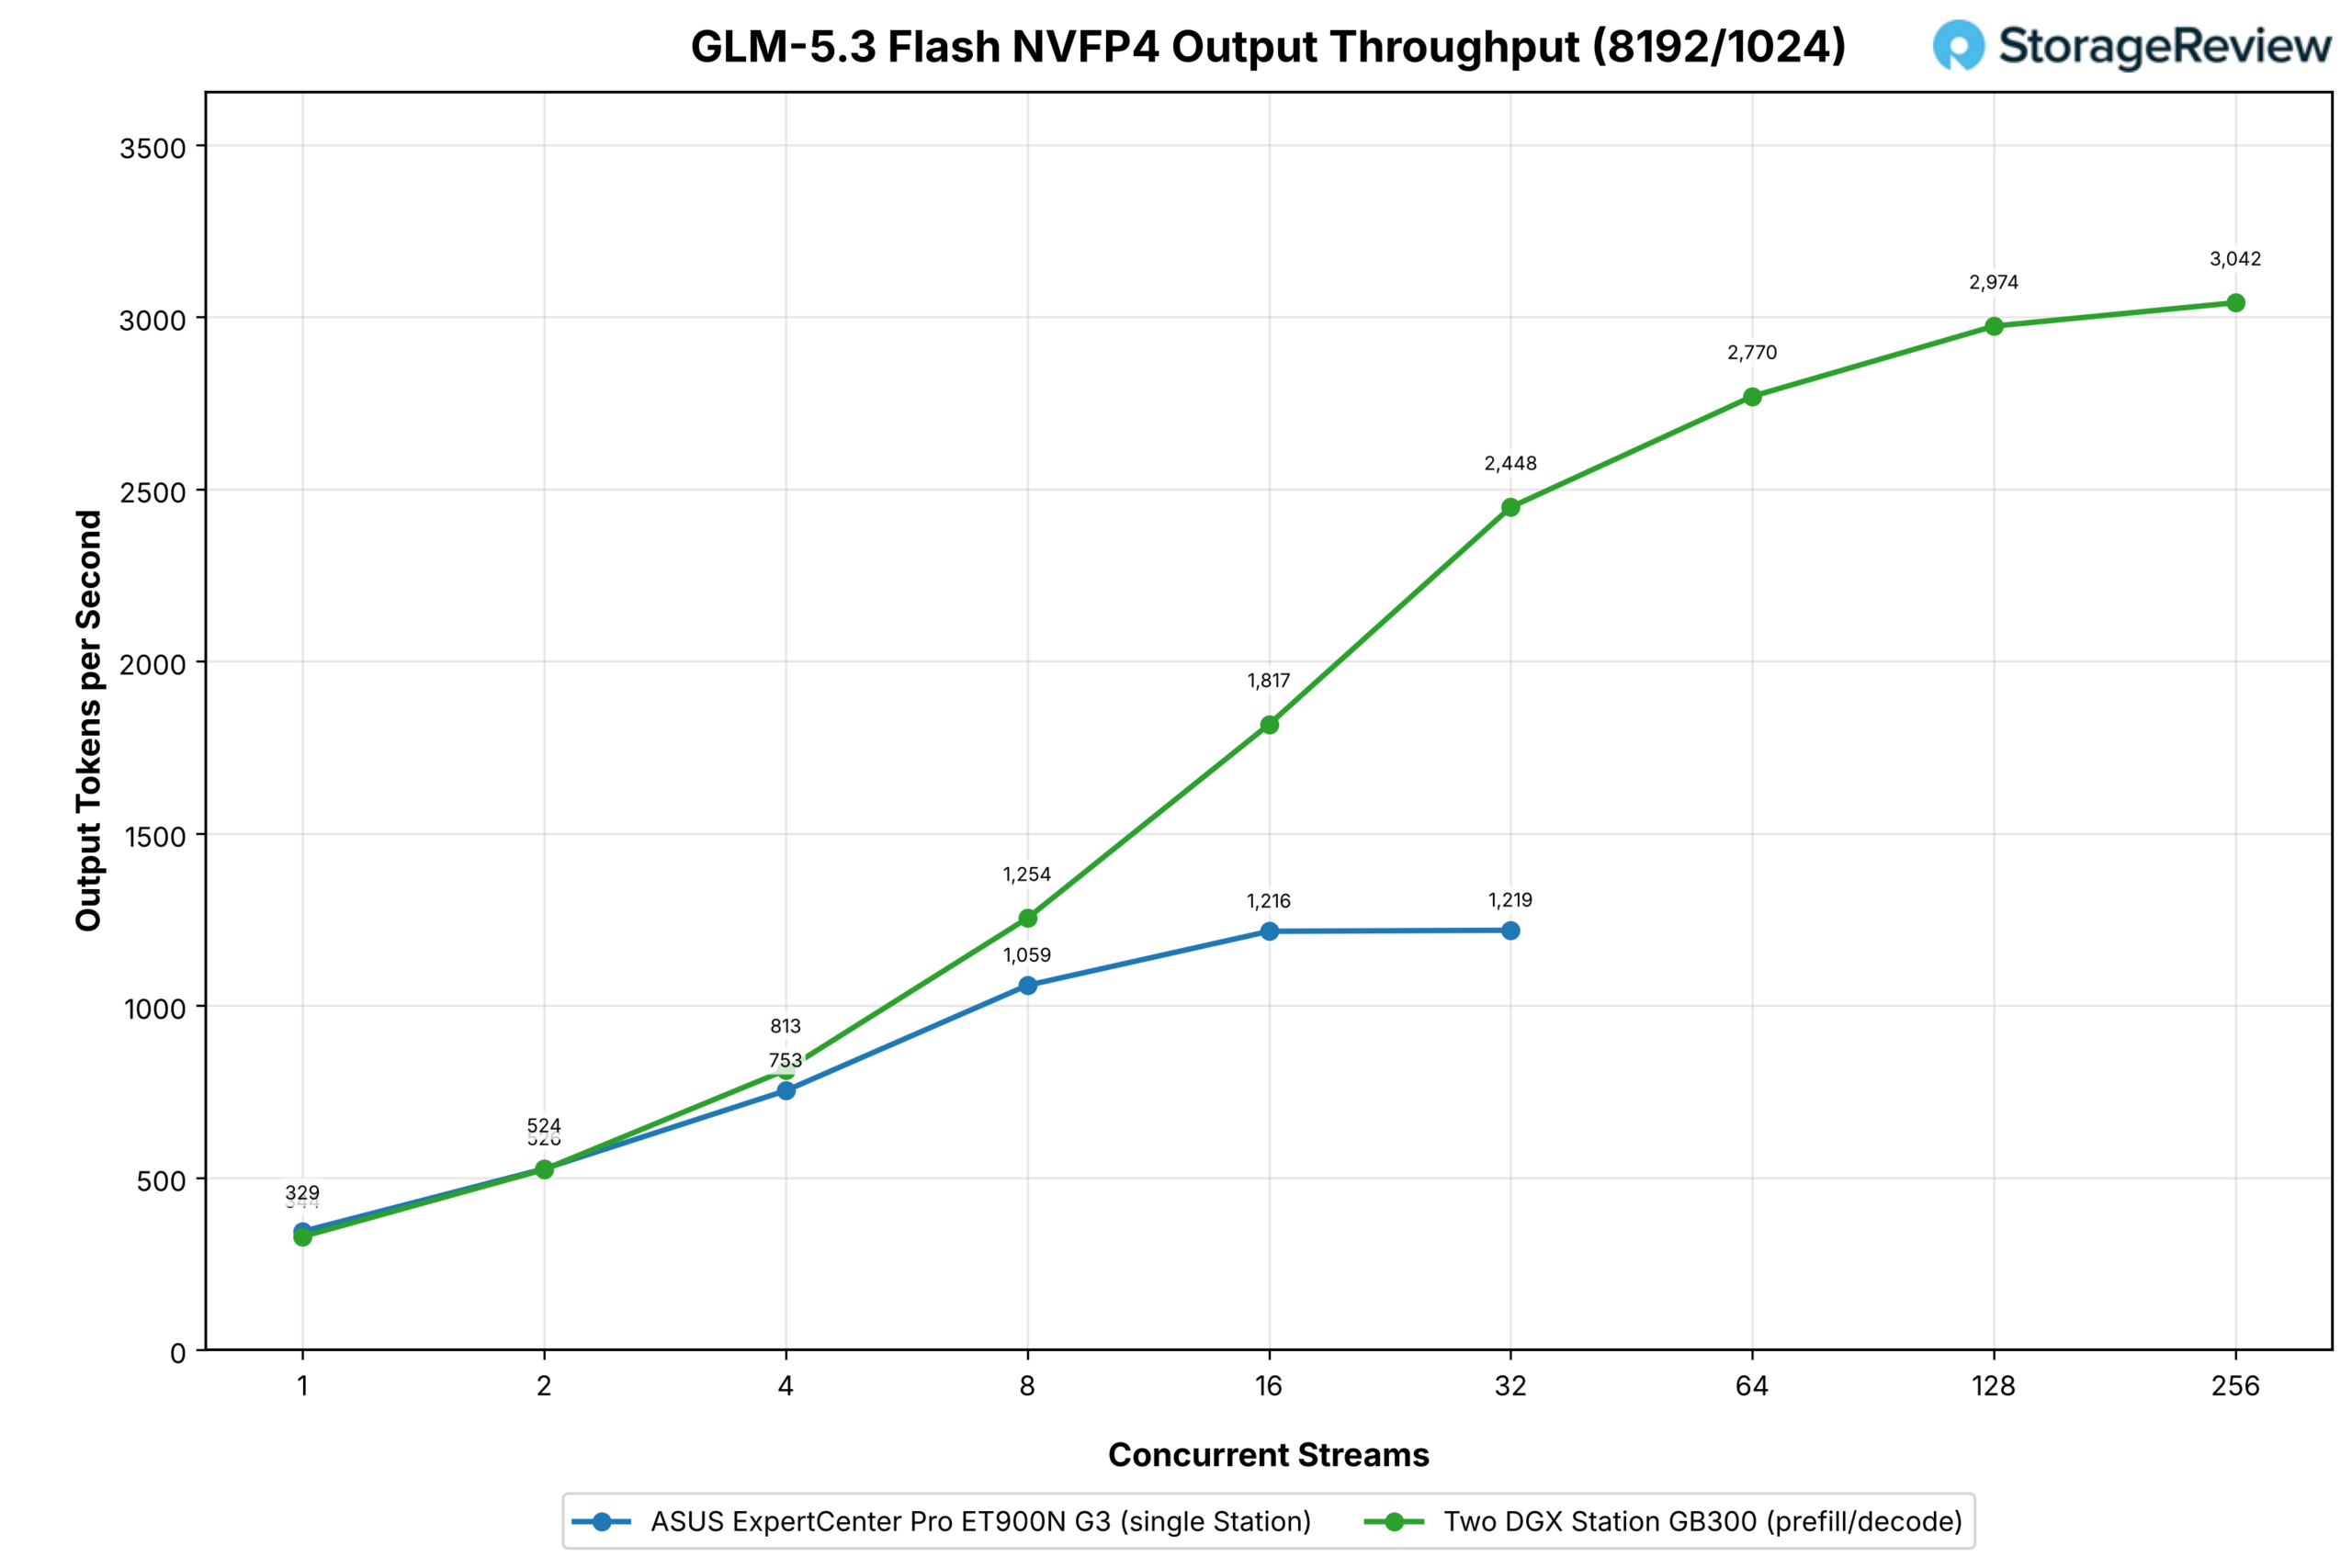
Модель GLM-5.3 Flash достаточно компактна, чтобы каждая станция хранила ее полную копию, поэтому она работала в дезагрегированном режиме: ASUS обрабатывала префилл, а HP — декодирование. Flash имеет небольшое количество активных параметров, поэтому на одной станции она работает быстро: 353 выходных токена в секунду при одном потоке и 828 при 32 (стандартная нагрузка), с неравномерным участком в середине (858 при четырех потоках, 489 при восьми), данные о котором мы приводим как есть. В паре серверов при стандартной нагрузке скорость выросла с 362 токенов в секунду при одном потоке до 2721 при 32 (в 3,3 раза быстрее одной башни) и до 3256 при 256 потоках.
При одном и двух потоках пара практически идентична результатам одной станции, что логично, так как станция декодирования выполняет ту же работу в одиночку; выигрыш появляется, когда количество запросов достаточно велико, чтобы станция префилла оставалась загруженной, а станция декодирования получала преимущество, не прерываясь на префилл. В профиле с интенсивным префиллом одна станция выросла от 344 до 1216 токенов в секунду при 16 потоках и удержала 1219 при 32, выйдя на плато. Пара префилл/декодирование продолжала расти: от 329 при одном потоке до 2448 при 32 (в два раза выше одной станции) и до 3042 при 256. Длинные промпты — это сценарий, для которого создано такое разделение, поскольку станция префилла поглощает запросы по 8192 токена, в то время как KV-кэш и вычислительные мощности станции декодирования остаются задействованы исключительно в генерации.
GLM-5.2
GLM-5.2 работала в режиме TP2 без выгрузки в Grace на кластере, и именно эта модель лучше всего обосновывает использование второй станции. Контрольная точка NVFP4 занимает около 433 ГБ, поэтому на одном GB300 примерно 215 ГБ весов экспертов находятся в памяти Grace, и каждый шаг декодирования, затрагивающий их, проходит через NVLink-C2C к LPDDR5X на скорости 396 ГБ/с. При разделении на две станции каждый B300 удерживает около половины модели в HBM3e.
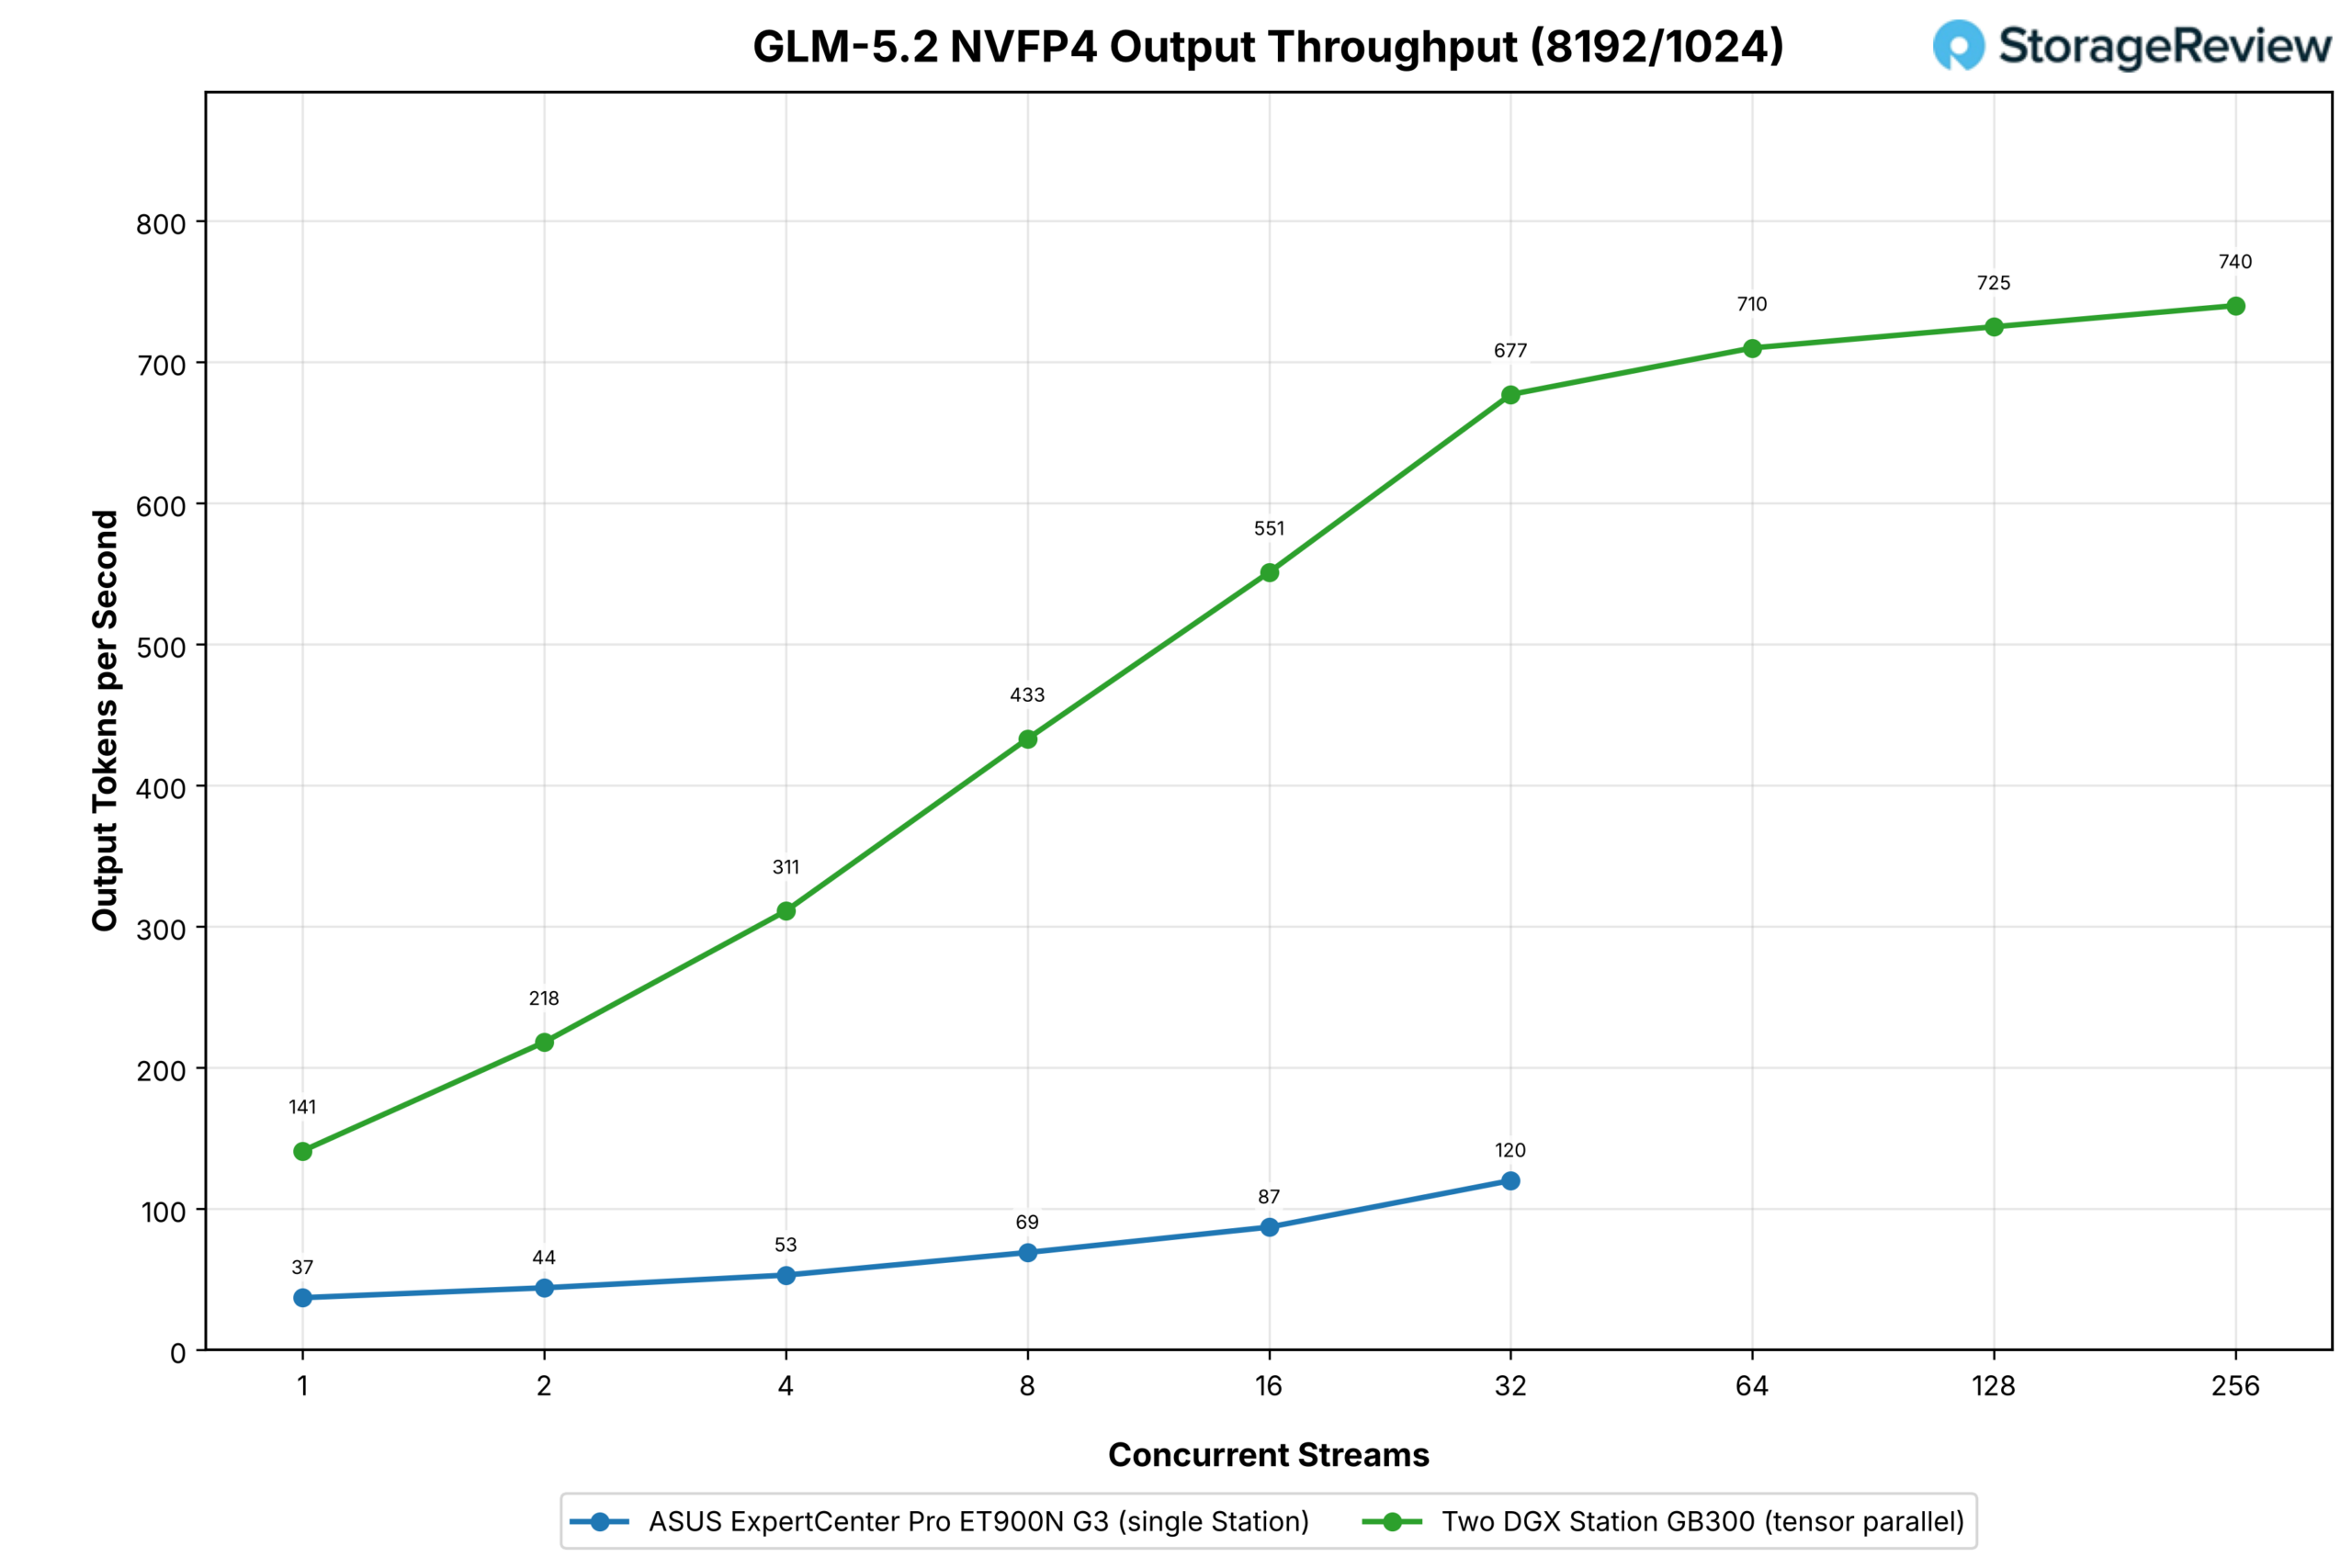
При стандартной нагрузке одна станция ET900N G3 выдавала 35 токенов в секунду при одном потоке и 139 при 32. Двухсерверный кластер начал со 149 токенов в секунду при одном потоке (в 4,3 раза выше одной башни), достиг 1525 при 32 потоках (в 11 раз выше) и продолжил рост сверх показателей одной станции до 2316 при 64 и 3141 при 256 (с просадкой до 2012 при 128 потоках). Модель, которую одна станция обслуживает на разговорной скорости для нескольких пользователей, превращается в модель, которую две станции могут обслуживать для целого отдела.
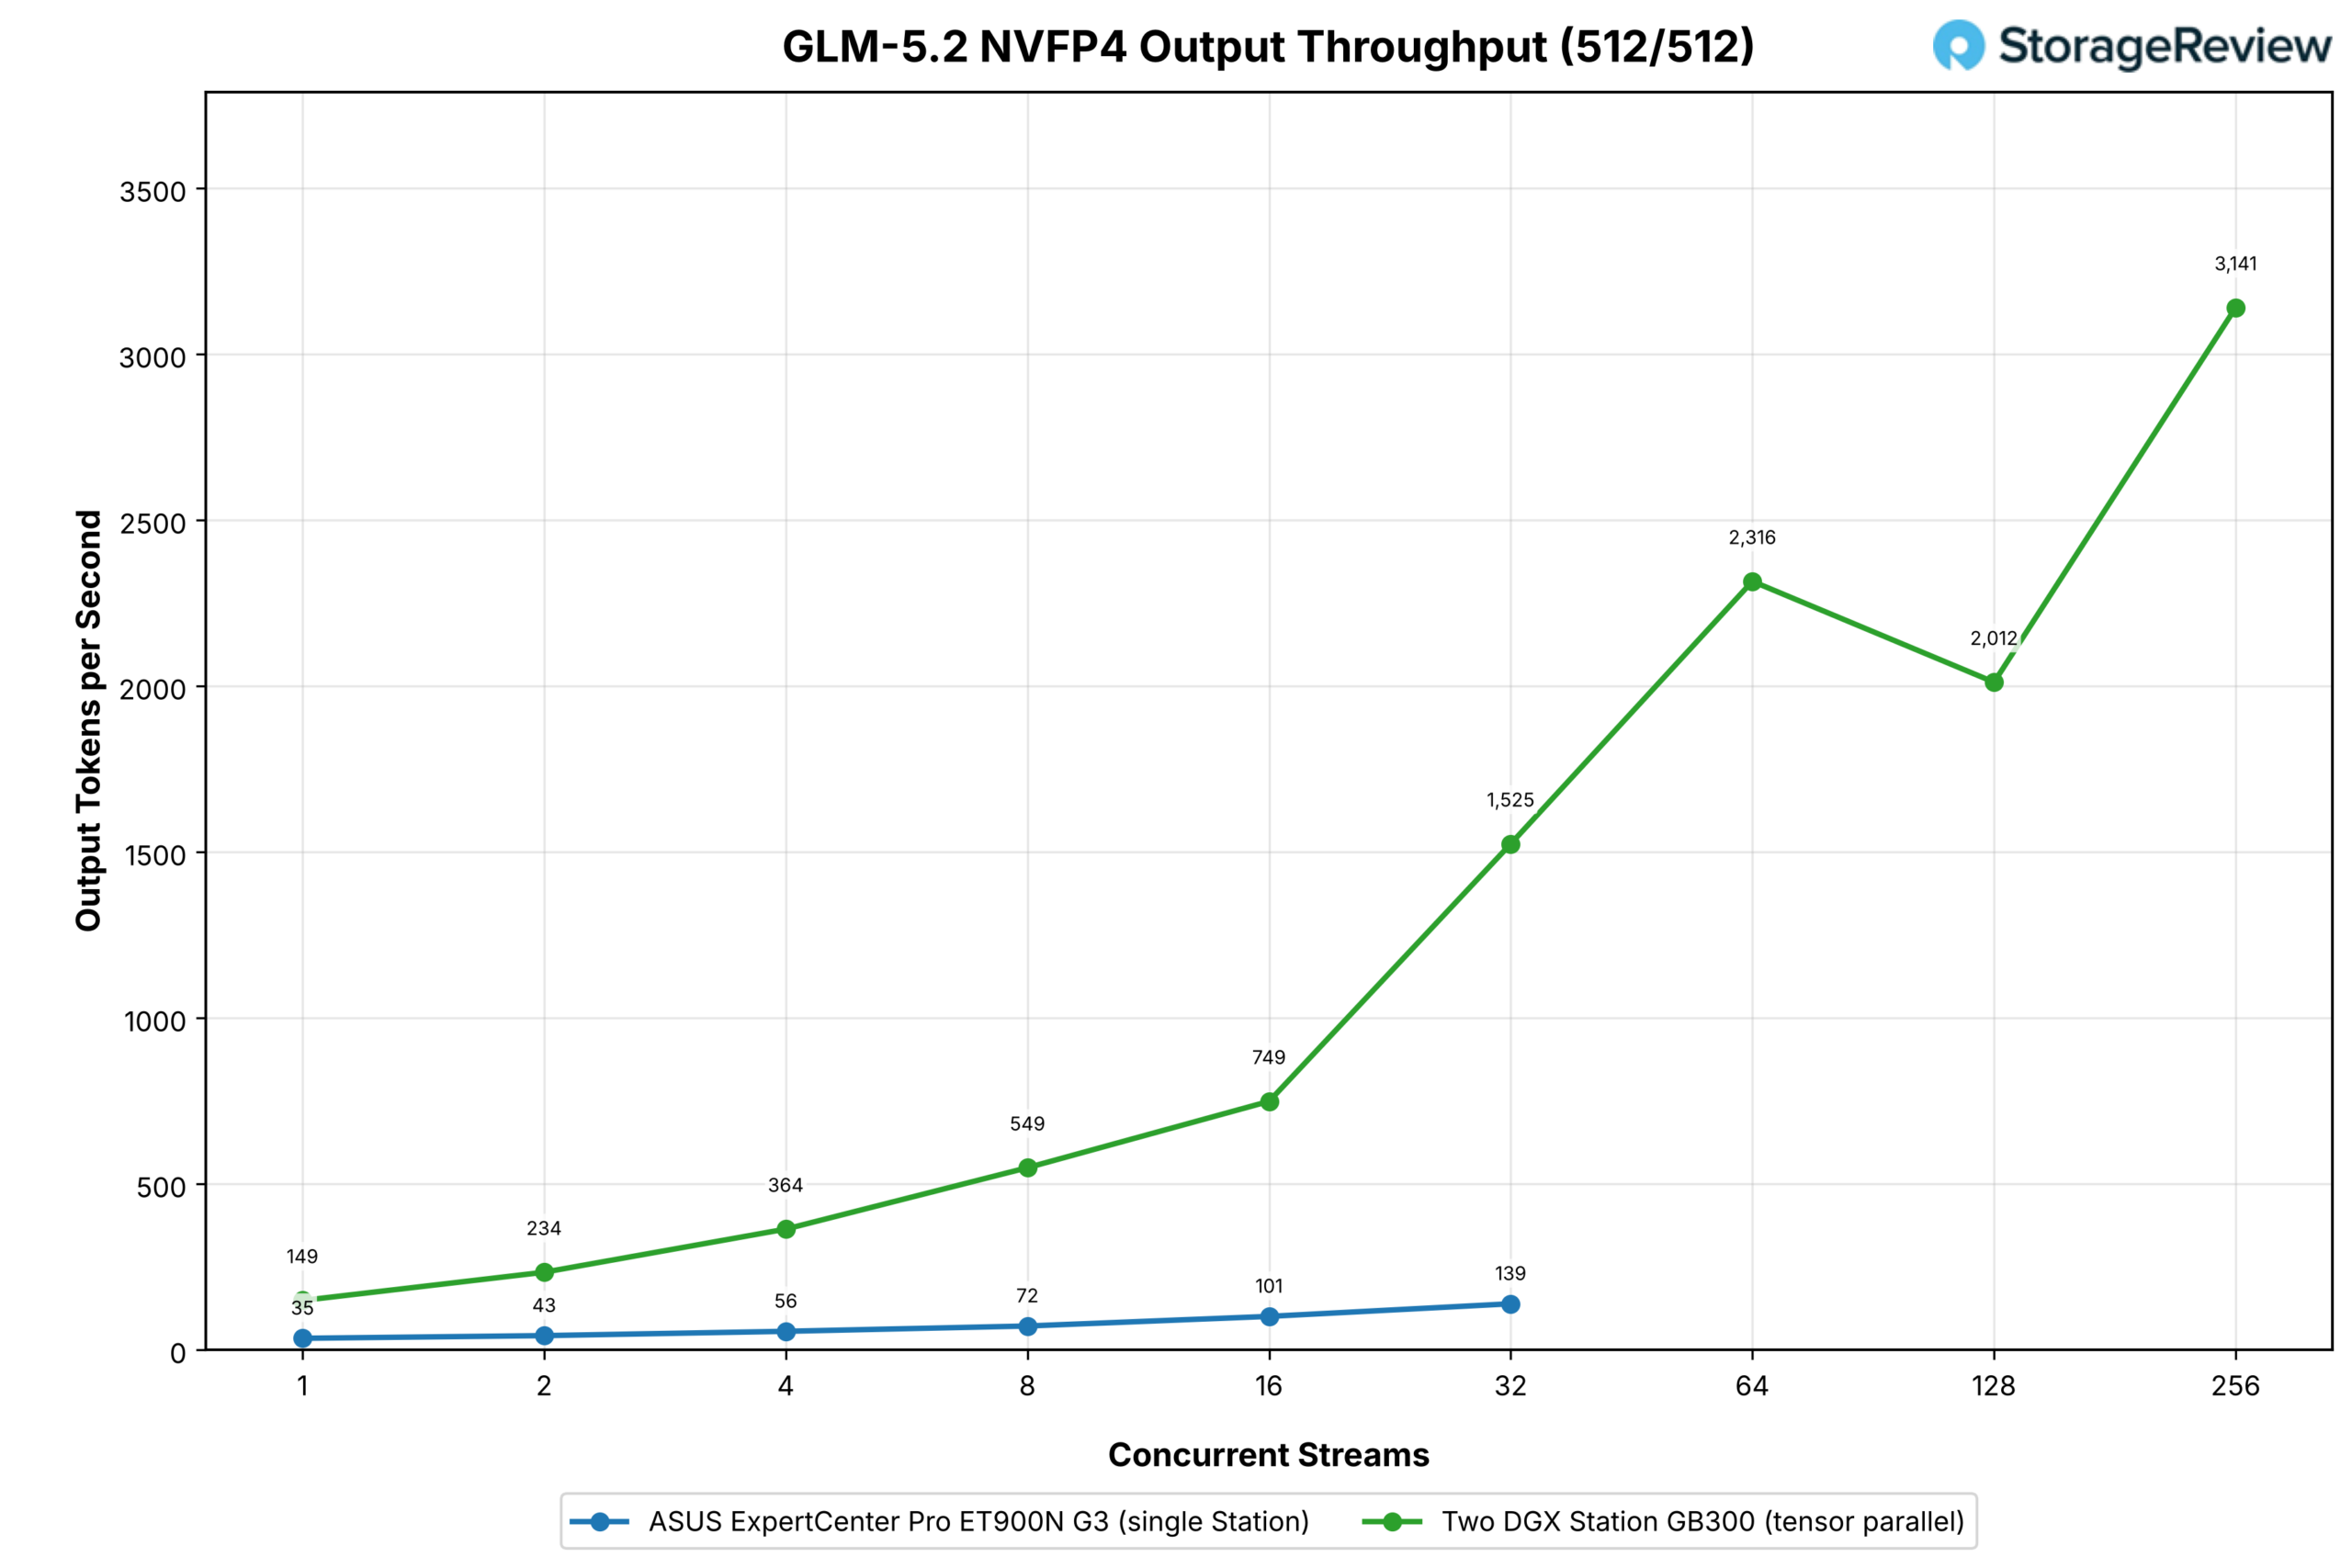
Профиль с интенсивным префиллом демонстрирует аналогичную картину на более низких значениях: одна станция выросла от 37 до 120 токенов в секунду при 32 потоках, а кластер — от 141 до 677 токенов в том же диапазоне (в 3,8 раза выше в начале и в 5,6 раза в пике), затем выйдя на плато 710, 725 и 740 токенов в секунду при нагрузке до 256 потоков. Длинные промпты перекладывают больше работы на этап префилла, где обе конфигурации ограничены вычислительными мощностями, поэтому штраф за выгрузку, который устраняет вторая станция, составляет меньшую долю от общего объема работы, чем при коротких промптах.
Производительность MiniMax-M3 и масштабируемость системы
Прирост производительности в обоих профилях нагрузки значительно превышает двукратный, так как вторая станция позволяет перенести 433-гигабайтную модель из памяти LPDDR5X полностью в HBM, и этот фактор играет более важную роль, чем просто дополнительные вычислительные мощности второго B300.
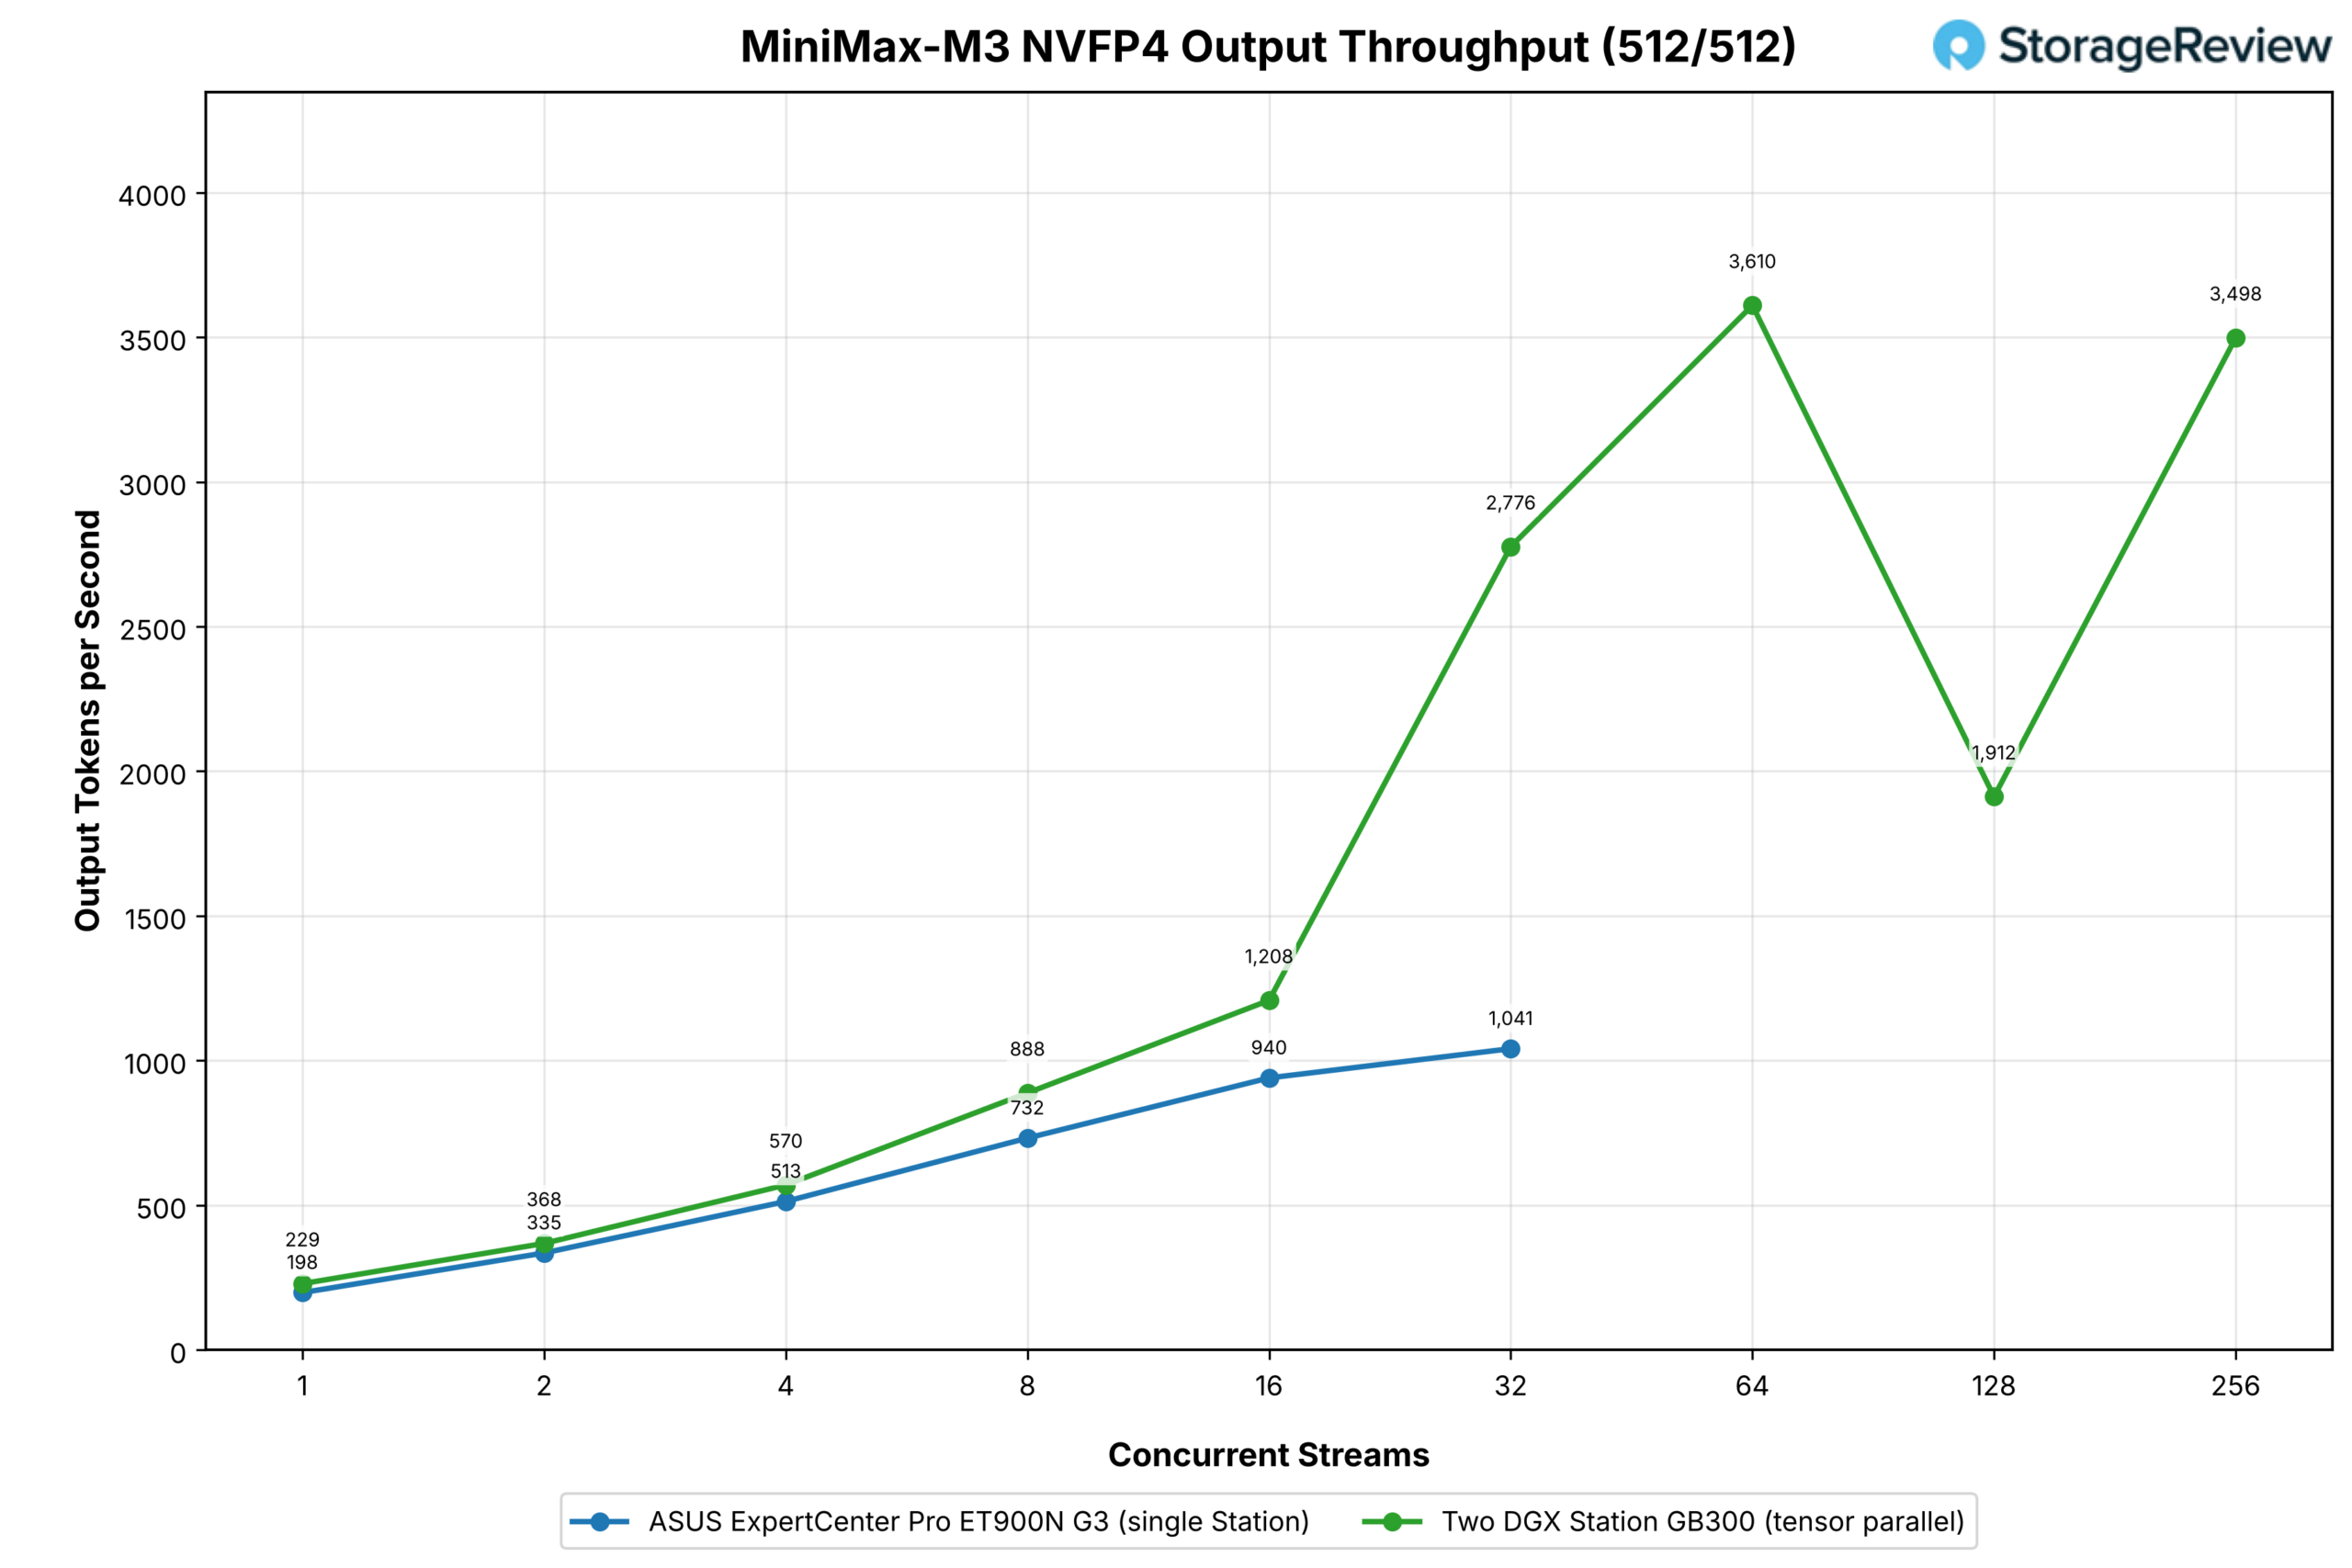
Модель MiniMax-M3 тестировалась в конфигурации TP2 без использования выгрузки в Grace. На одной станции она находится на границе объема HBM, часть её экспертных слоев размещается в памяти Grace. В обзоре ASUS эта система на аналогичной рабочей нагрузке с EAGLE3 достигла показателя 1 041 токен в секунду при 32 потоках.
Кластер из двух станций демонстрирует схожие с одиночной системой результаты до 16 потоков (1 208 против 940 токенов в секунду), после чего значительно вырывается вперед: 2 776 токенов в секунду при 32 потоках (в 2,7 раза быстрее одной «башни»), 3 610 при 64 потоках, небольшое снижение до 1 912 при 128 и 3 498 при 256 потоках. Две станции дают меньший прирост, чем в случае с GLM-5.2, поскольку одна станция уже удерживает большую часть этой модели в HBM, поэтому вклад второго GPU ближе к стандартному масштабированию вычислений с дополнительным запасом по KV-кэшу.
Профили с интенсивным префиллом
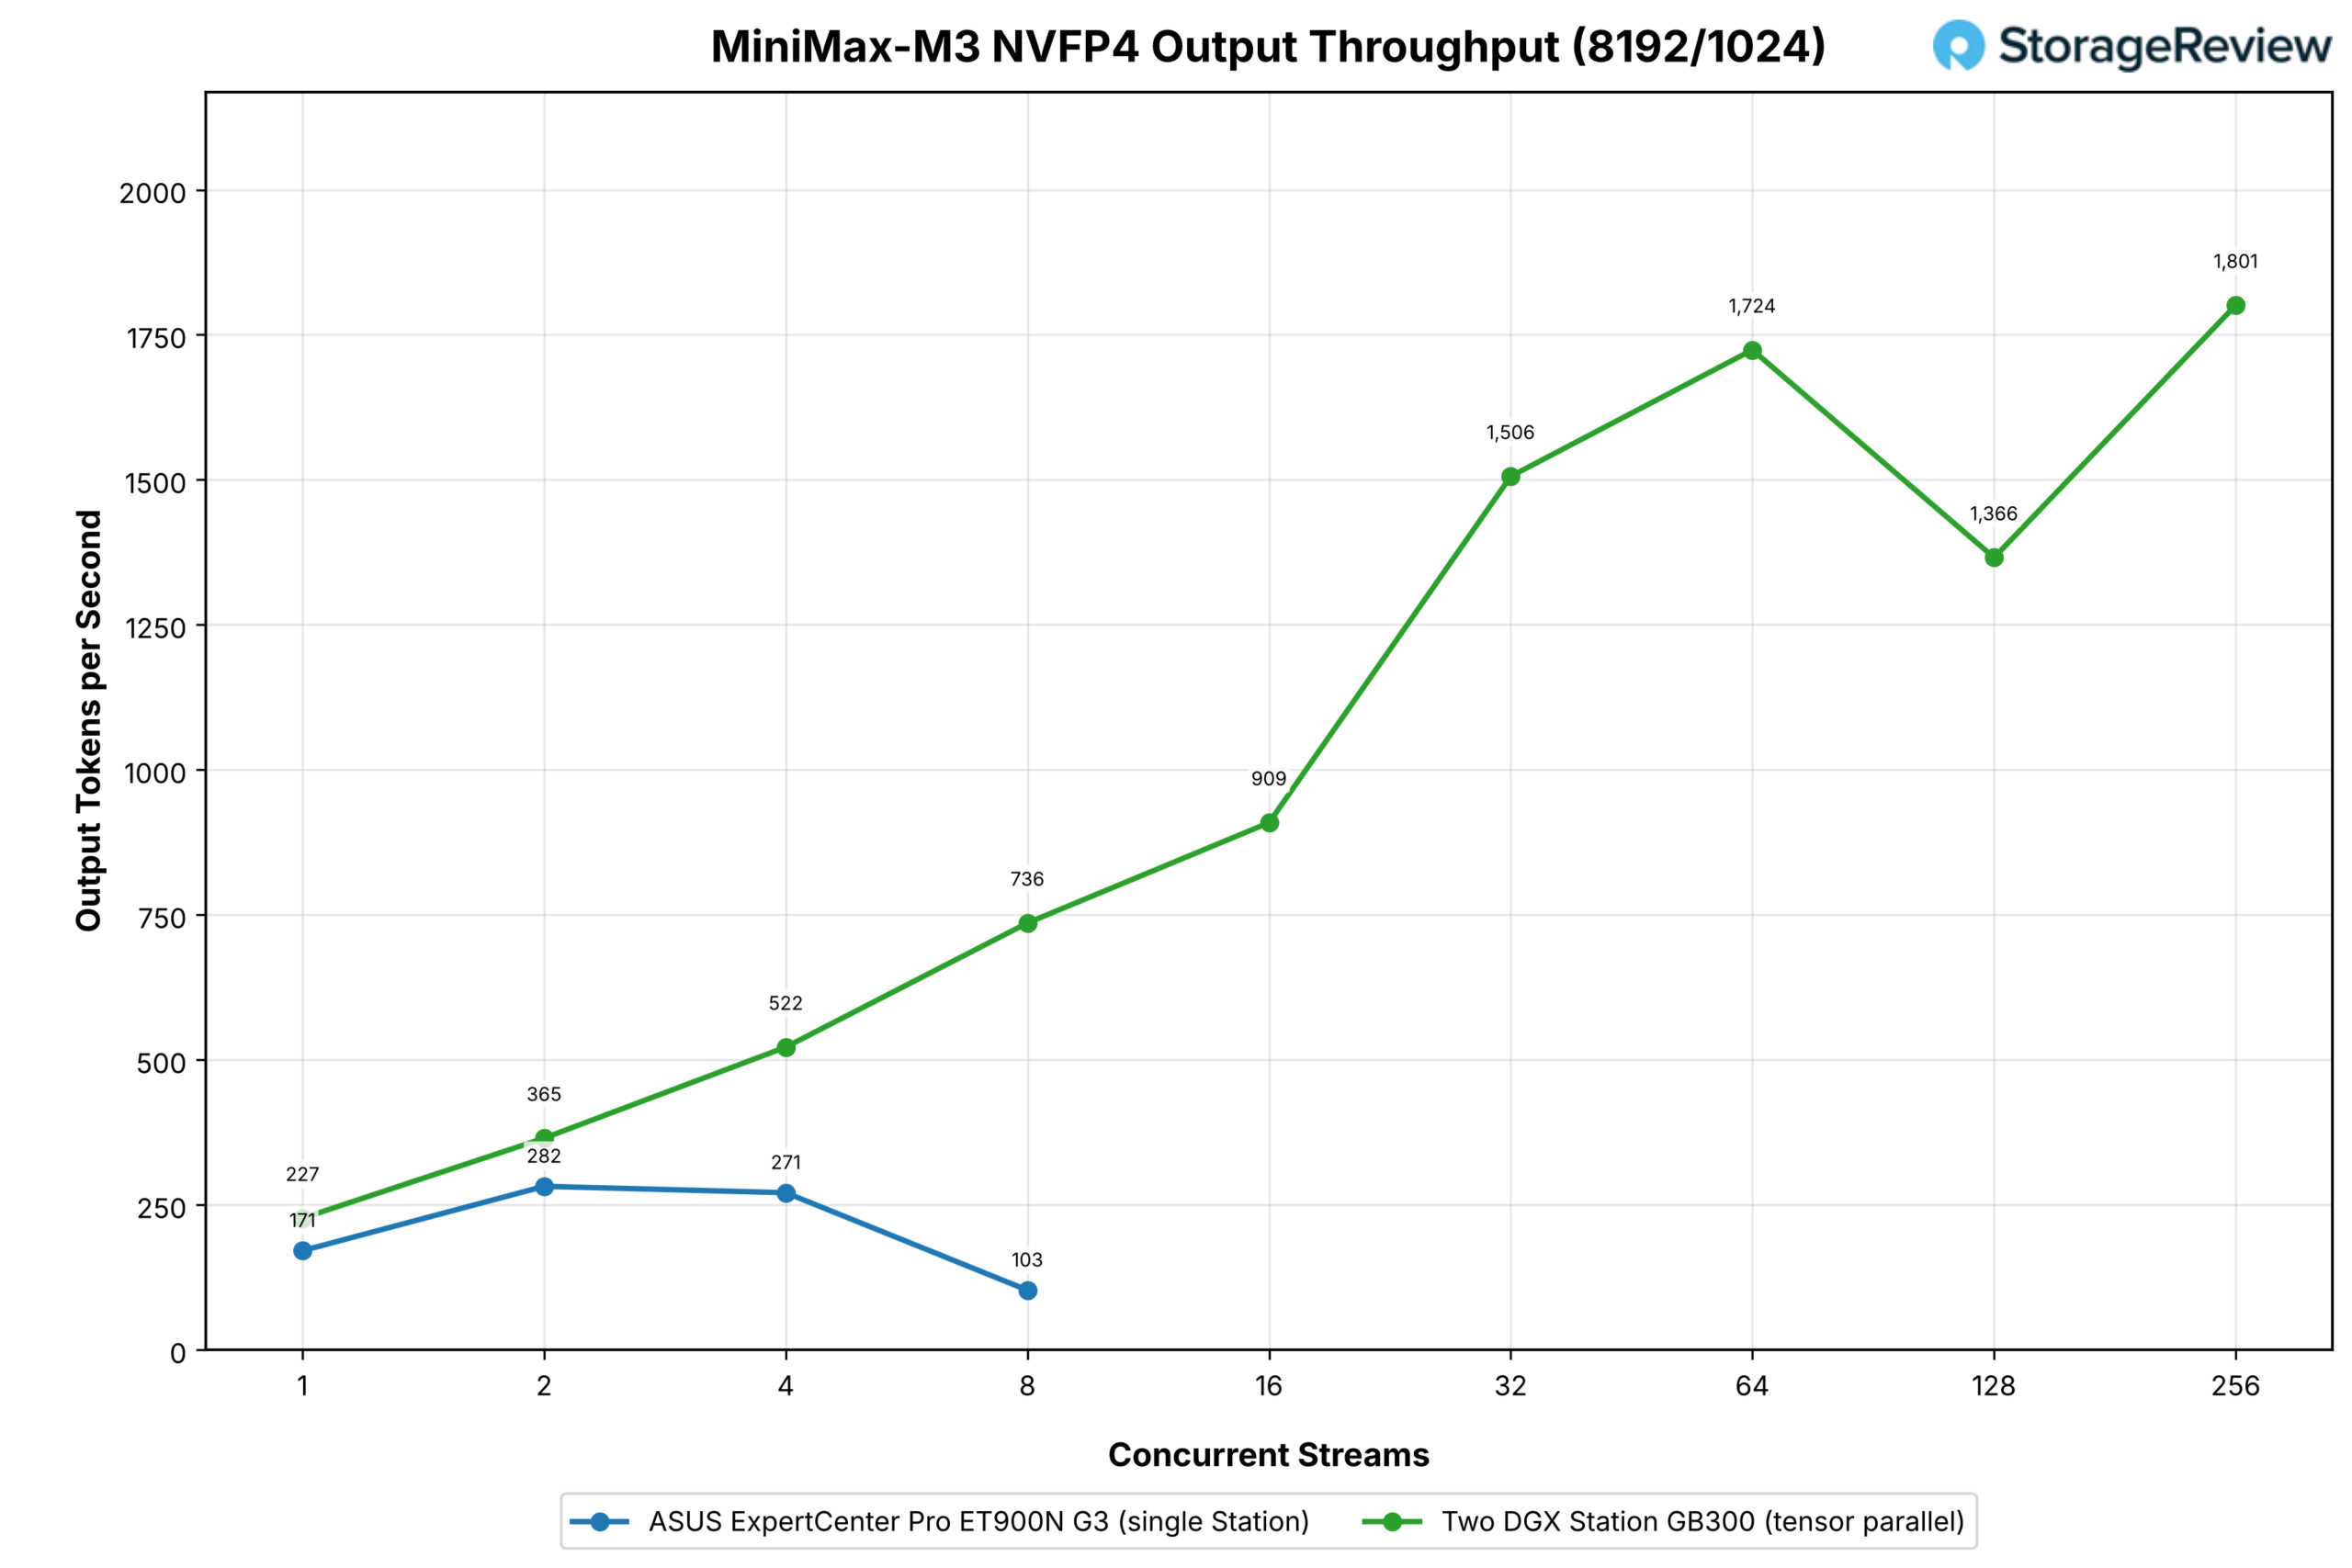
В профиле с интенсивным префиллом MiniMax-M3 на одной станции столкнулась с нехваткой ресурсов: промпты объемом 8 192 токена быстро исчерпывают оставшийся KV-кэш. В результате пиковая производительность одиночной системы составила 282 токена в секунду при двух потоках, 271 при четырех и упала до 103 при восьми, на чем тестирование завершилось из-за отсутствия свободных ресурсов.
При распределении модели между двумя станциями показатели составили 365, 522 и 736 токенов в секунду. Это дает 30% прироста при двух потоках, когда у обеих конфигураций есть запас кэша, и 7,1-кратный прирост при восьми потоках, где одна система уже достигла своего предела. Далее кластер показал 909 токенов в секунду при 16 потоках, 1 506 при 32, 1 724 при 64, 1 366 при 128 и 1 801 при 256 — диапазон, который одиночная станция в данном профиле достичь не может.
Итоги тестирования двухстанционной конфигурации
Две станции GB300 DGX, соединенные напрямую через порты ConnectX-8, работают в строгом соответствии с документацией NVIDIA. Процесс настройки прошел беспроблемно, а мы получили первые данные по пропускной способности для конфигурации из двух систем. Вторая станция оправдывает себя на моделях, объем которых превышает 252 ГБ HBM3e: так, показатели GLM-5.2 растут со 139 токенов в секунду (32 потока) на одной станции до 1 525 на двух, достигая 3 141 на 256 потоках, так как распределение нагрузки освобождает модель объемом 433 ГБ от использования LPDDR5X. Модель GLM-5.3 достигает 5 018 токенов в секунду на 256 потоках, преодолевая потолок в 188 токенов на одной системе.
Для моделей, которые помещаются на одну станцию (GLM-5.3 Flash и DeepSeek V4.1 Flash), эффективнее использовать вторую станцию иначе: загрузить на каждую полную копию модели, разделив префилл и декодирование. Это позволило на GLM-5.3 Flash удвоить производительность на длинных промптах при 32 потоках и утроить на коротких, а DeepSeek V4.1 Flash показала лучший результат в серии — 5 248 токенов в секунду.
Наше мнение о продукте не изменилось со времен обзора MSI XpertStation WS300: это интересная машина для узкого рынка, и если у вас возникла потребность в одной, возможно, понадобится и вторая. Оптимальный сценарий использования — гибкая инфраструктура, где пул ресурсов распределяется под задачи команды и перенастраивается по мере смены проектов. Экосистема NVIDIA, включающая Run:ai для планирования, Brev для сред разработки и Lepton для маркетплейса вычислений, делает продукт еще более привлекательным при наличии доступа к ним.
Конфигурация из двух блоков показала отличное масштабирование: лучший зафиксированный прирост у GLM-5.3 — с 188 до 5 018 токенов в секунду (27-кратный рост). Это результат работы GB300 через два канала 400G. Подобная эффективность заставляет с интересом ждать появления станций Vera Rubin с HBM и NVLink-C2C следующего поколения. Две станции на рабочем столе теперь справляются с задачами, ранее требовавшими выделенных GPU-серверов и соответствующей инфраструктуры ЦОД. Это дает командам, не имеющим доступа к серверным мощностям, путь к нейросетевым вычислениям класса «frontier» прямо на рабочем месте, и NVIDIA установила планку в этой категории, если не учитывать цену.