Проблема доступности сервисов — классическая ситуация для владельца домашнего сервера. Часто бывает так, что Docker сообщает о штатной работе контейнера, однако само приложение внутри не отвечает на запросы. Подобный инцидент произошел с Nextcloud после автоматического обновления через инструмент Watchtower: контейнер запустился, но из-за несовпадения версии кода и схемы базы данных сервис остался неработоспособным. В такой ситуации стандартный мониторинг не фиксирует сбой, так как Docker отслеживает лишь жизненный цикл процесса, а не корректность функционирования приложения.
Почему Docker не всегда гарантирует доступность сервиса
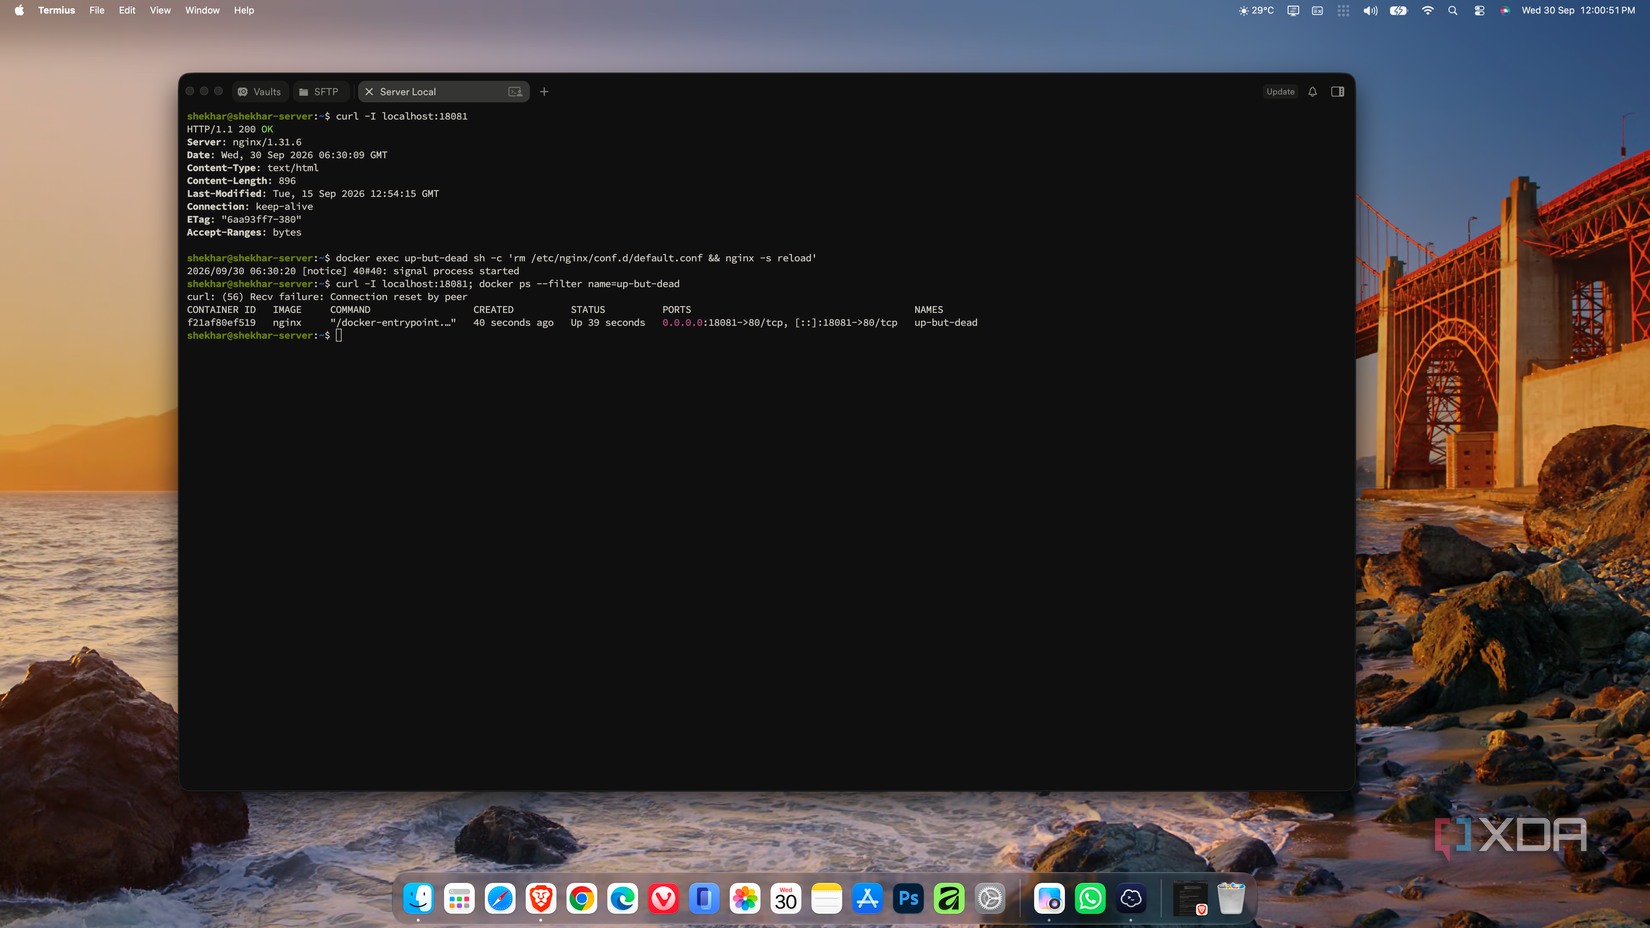
Docker считает контейнер работающим, если активен его основной процесс. Чтобы продемонстрировать разрыв между статусом контейнера и реальным состоянием приложения, можно провести простой тест с Nginx. После удаления файла конфигурации внутри контейнера и перезагрузки службы команда docker ps по-прежнему будет отображать статус Up, тогда как попытка обращения к сервису через curl вернет ошибку.
Анализ существующих проверок состояния
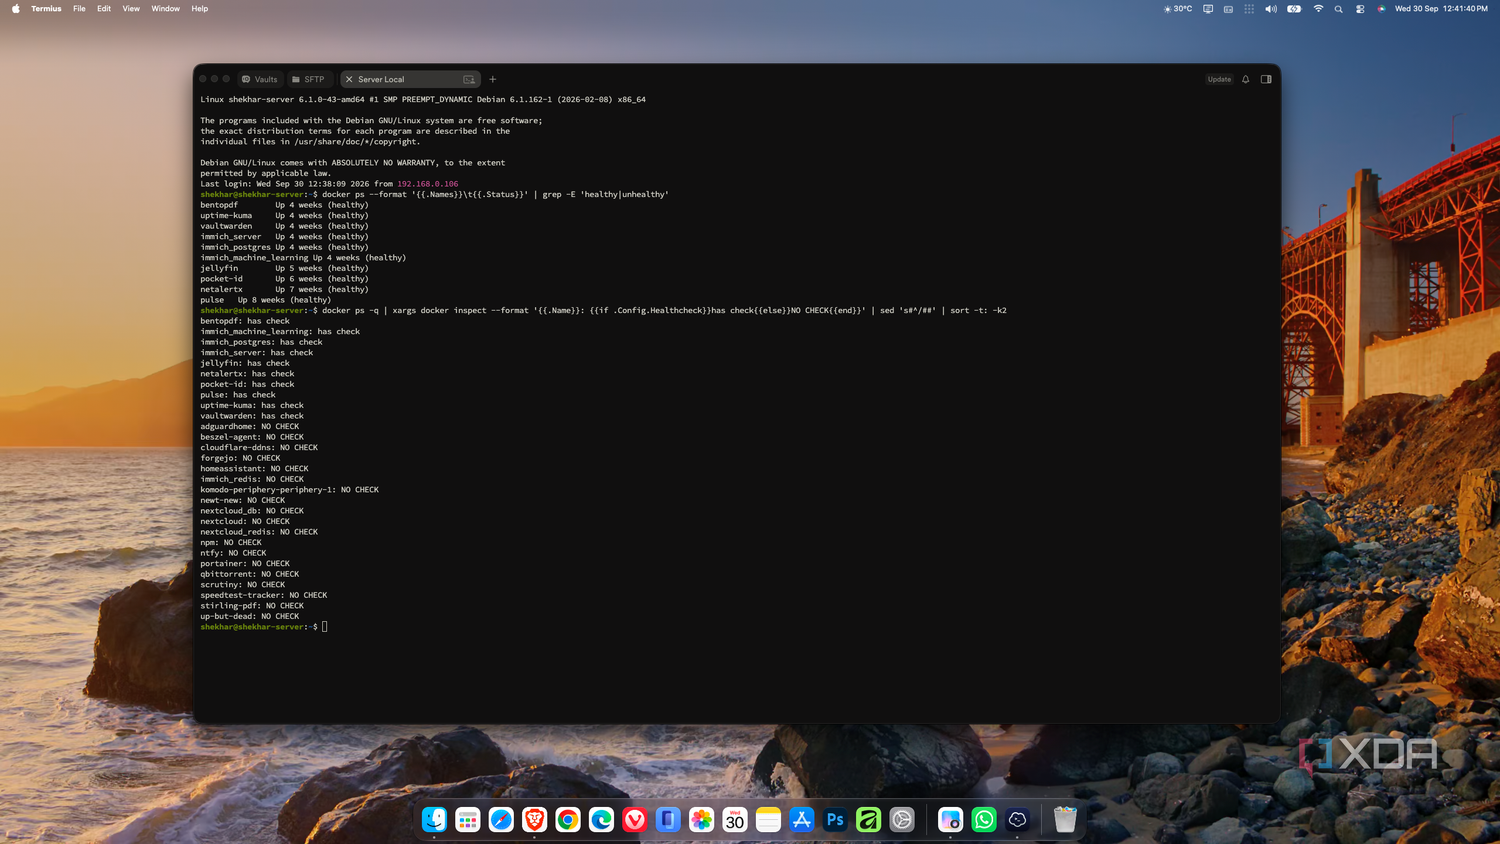
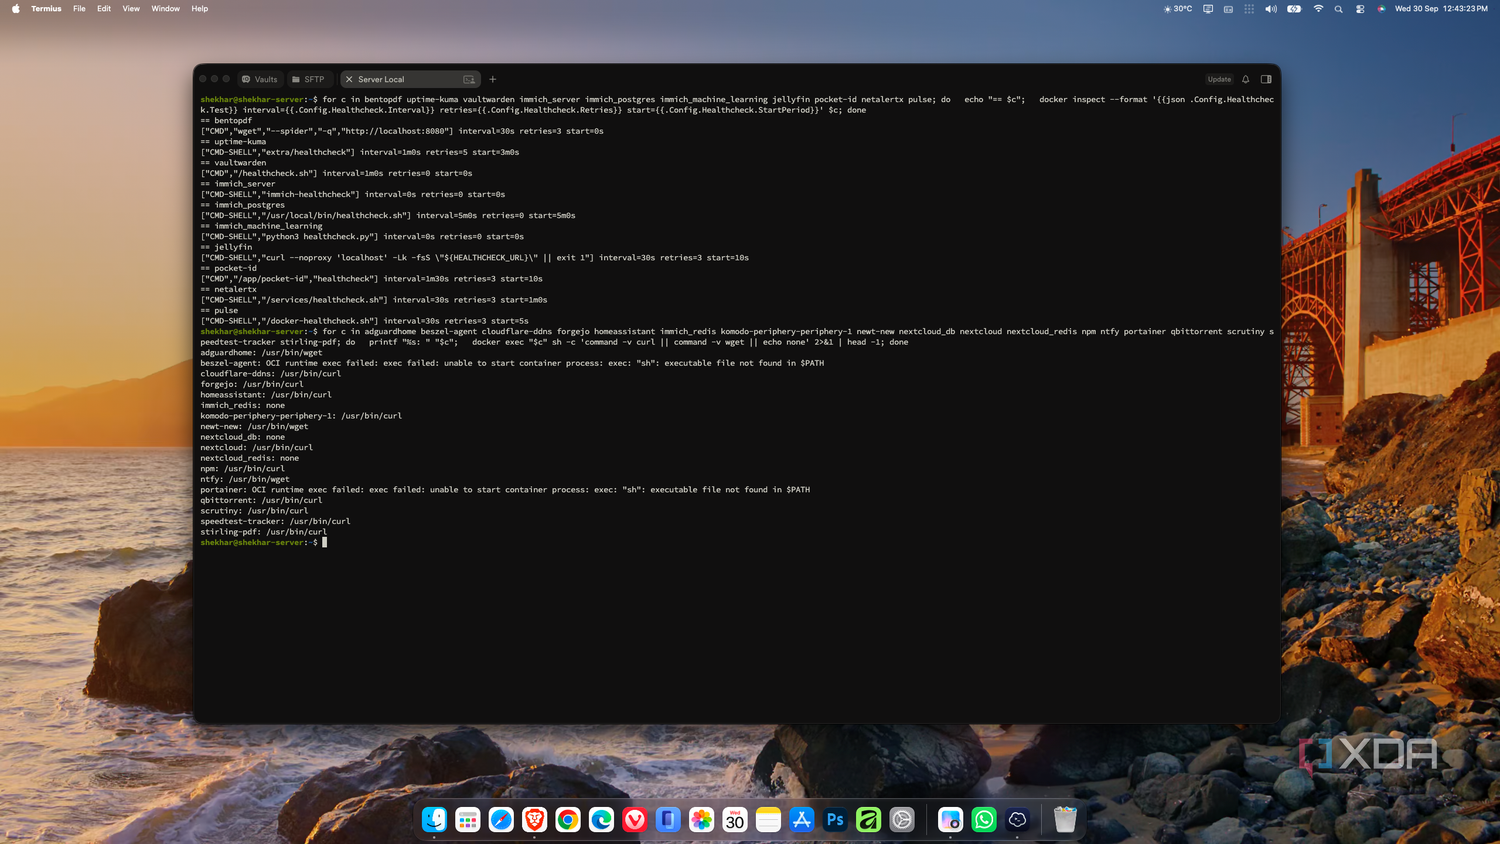
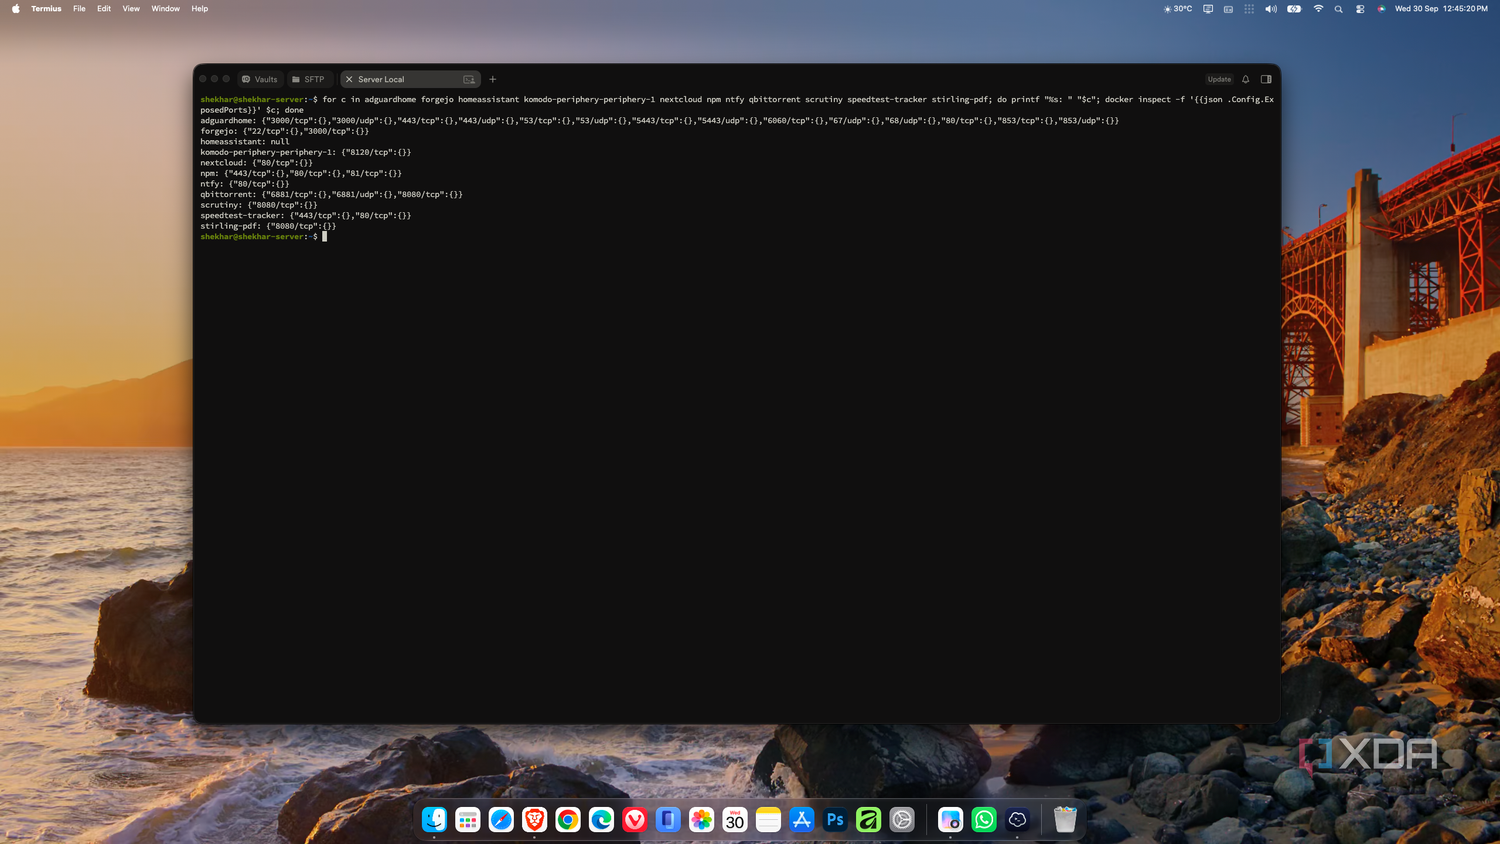
Перед внедрением глобальной системы мониторинга необходимо оценить текущее положение дел. Из 28 запущенных контейнеров автора 10 уже имели встроенные проверки (health checks). Анализ с помощью команд docker inspect и docker exec позволил определить интервалы проверок и количество попыток до фиксации сбоя. Большинство настроек были сконфигурированы на обнаружение ошибки через 90 секунд (30 секунд интервала и 3 попытки). При этом для контейнеров, не имеющих встроенных проверок, потребовалось проверить наличие инструментов curl или wget внутри образа.
Настройка healthcheck в Docker Compose
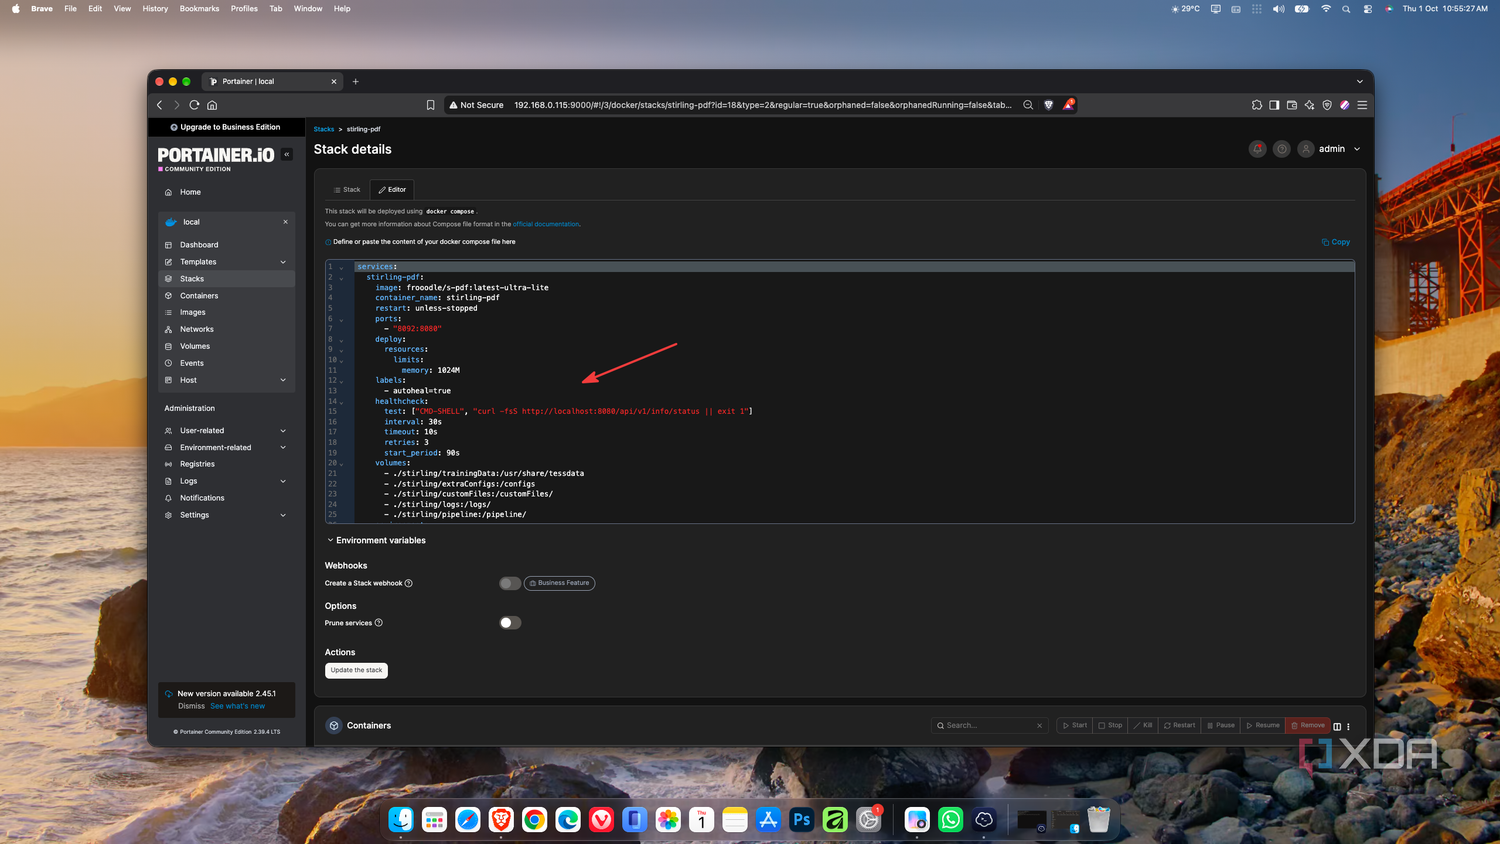
Для контейнеров без встроенного мониторинга необходимо вручную добавить параметры в файл docker-compose.yml. Пример конфигурации для Stirling PDF:
- labels: — autoheal=true
- healthcheck: test: [«CMD-SHELL», «curl -fsS http://localhost:8080/api/v1/info/status || exit 1»]
- interval: 30s
- timeout: 5s
- retries: 3
- start_period: 90s
Эти параметры позволяют Docker регулярно опрашивать сервис и фиксировать статус unhealthy в случае отсутствия ответа.
Автоматизация восстановления контейнеров
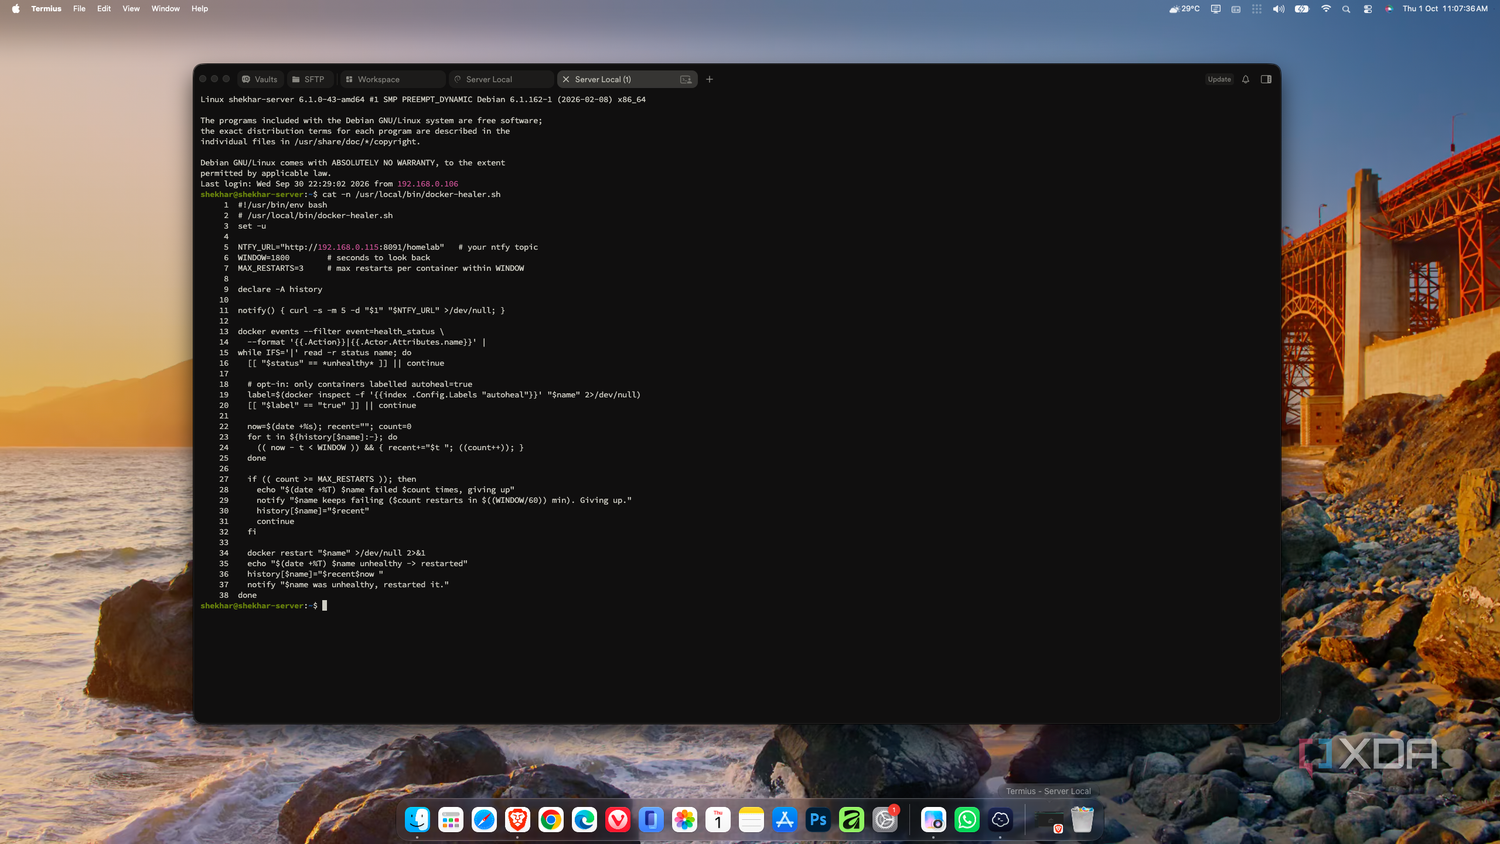
Сами по себе проверки лишь констатируют факт сбоя. Для активного реагирования был внедрен вспомогательный скрипт, работающий через systemd. Он отслеживает поток событий health-status в Docker и перезапускает контейнеры при переходе в состояние unhealthy, если для них установлен лейбл autoheal=true.
Ограничения системы самовосстановления
Данная система имеет важные предохранители:
- Ограничение на три перезапуска в течение 30 минут для предотвращения циклической нагрузки.
- Лейбл autoheal=true защищает критически важные базы данных от неконтролируемой перезагрузки.
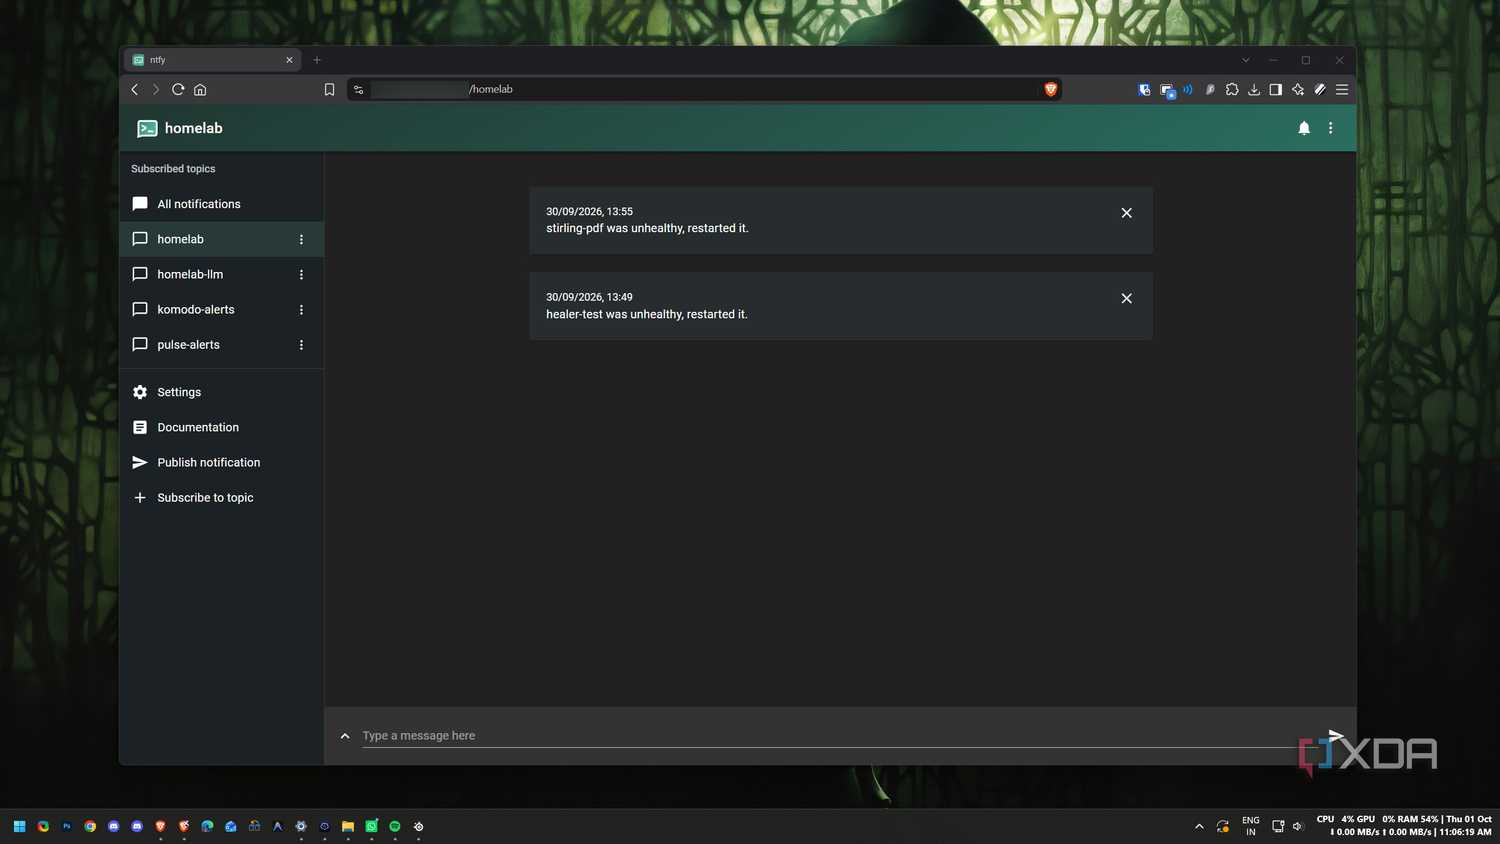
- Система уведомлений через ntfy сообщает обо всех событиях перезапуска.
Важно понимать, что перезапуск не является универсальным решением. В случае с ошибкой миграции базы данных Nextcloud скрипт лишь перезапустит контейнер, не устранив саму причину ошибки. Система не диагностирует некорректные конфигурации, но позволяет автоматически восстанавливать работу «зависших» процессов, что значительно упрощает эксплуатацию домашнего сервера.
Почему концепция «работает» в Docker — это ловушка
Многие пользователи домашних серверов пребывают в уверенности: если Docker сообщает, что контейнер в статусе «Up», значит, сервис доступен. Однако за годы работы с homelab я усвоил, что это не так. Docker лишь отслеживает жизненный цикл основного процесса — если он запущен и не завершился с ошибкой, Docker считает задачу выполненной. Но что происходит внутри «черного ящика» контейнера, системе зачастую неведомо. Это не теоретические рассуждения, а горький опыт, с которым я сталкивался неоднократно.
Одним из ярких примеров стал случай с инструментом Watchtower, который я внедрил для автоматизации обновлений. Идея выглядела безупречно: никакой рутины, актуальные версии образов прилетают сами. Но в одно прекрасное утро я обнаружил ошибку базы данных в Nextcloud. Проблема оказалась банальной: Watchtower выкачал свежий образ, код которого оказался «старше» текущей схемы БД. Произошел конфликт версий, и приложение перестало отвечать. Устранить ошибку было легко — достаточно было выполнить docker exec nextcloud php occ upgrade. Но главная проблема заключалась в том, что все мои инструменты мониторинга промолчали. Контейнер ведь был «Up», мониторинг был спокоен, хотя по факту сервис был мертв.
Репродукция ошибки: как Docker обманывает пользователя
Чтобы убедиться, что проблема не в Nextcloud, а в самой логике Docker, я воспроизвел ситуацию с помощью обычного Nginx:
- Запускаем контейнер: docker run -d —name up-but-dead -p 18081:80 nginx
- Проверяем доступность: curl -I localhost:18081 (все работает).
- Ломаем приложение, удалив конфиг: docker exec up-but-dead sh -c ‘rm /etc/nginx/conf.d/default.conf && nginx -s reload’
- Снова проверяем доступность: curl -I localhost:18081 (получаем ошибку).
- Смотрим статус в Docker: docker ps —filter name=up-but-dead — и видим статус «Up», хотя сервис фактически недоступен.
Аудит инфраструктуры: кто уже умеет себя проверять?
Прежде чем внедрять проверки везде, я решил просканировать текущие 28 контейнеров. Я использовал два простых цикла с командами docker inspect и docker exec. Выяснилось, что 10 контейнеров уже имели базовые проверки, но их настройки сильно разнились. Например, сервис Immich был настроен очень консервативно: ему требовалось около 15 минут, чтобы официально сообщить о сбое, тогда как большинство остальных укладывались в 90 секунд.
Для оставшихся 18 контейнеров задача усложнилась. Мне нужно было найти инструмент для проверки (curl или wget) внутри каждого образа. Оказалось, что некоторые контейнеры, такие как nextcloud_db, вообще лишены этих утилит, а в Portainer и beszel-agent даже нет полноценной оболочки (shell), что делает внедрение проверок в них нетривиальной задачей.
Тестирование «автолекаря»
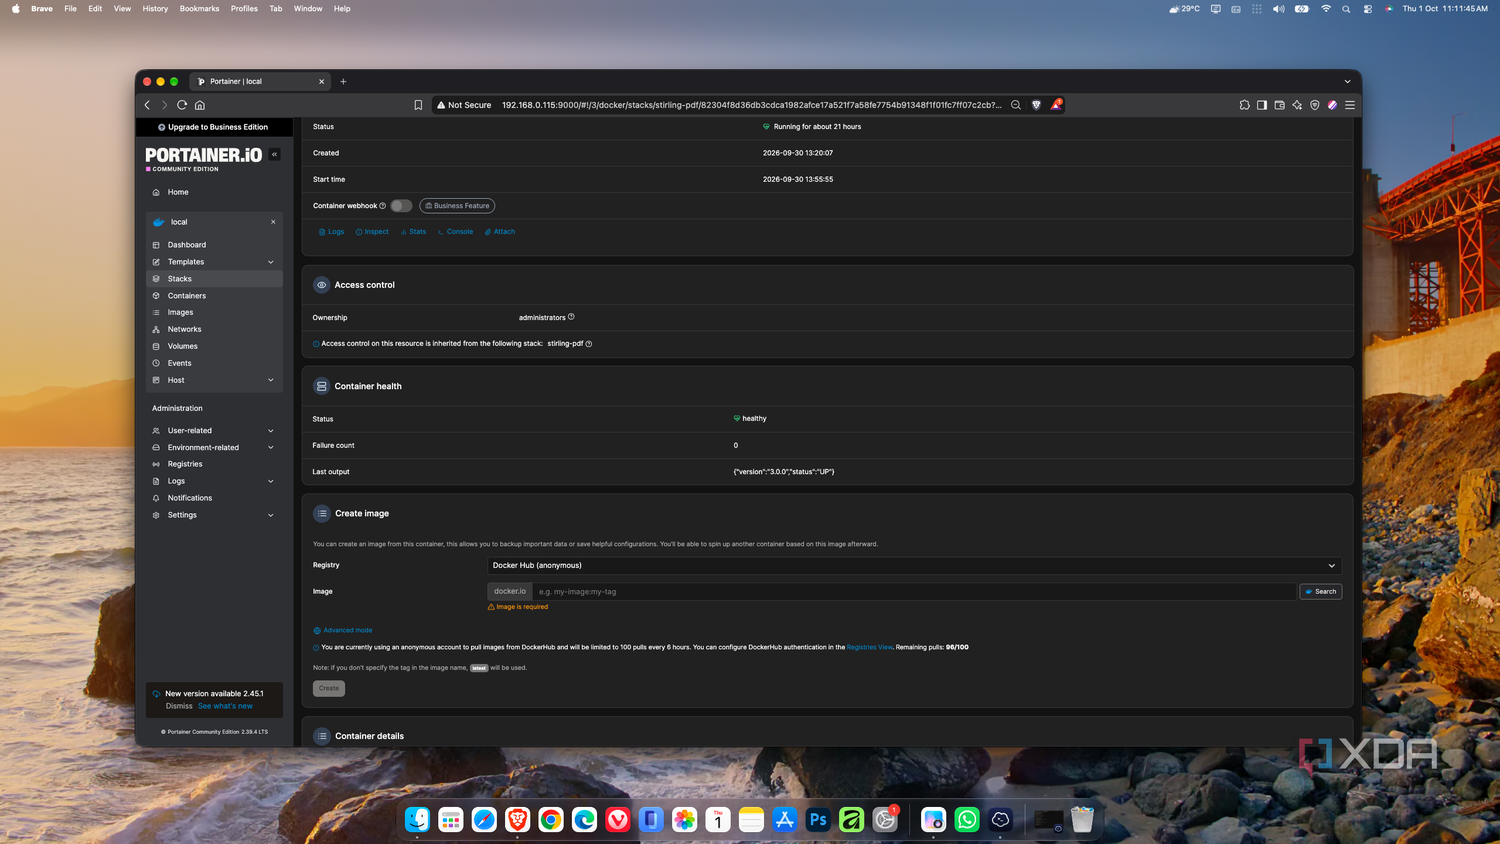
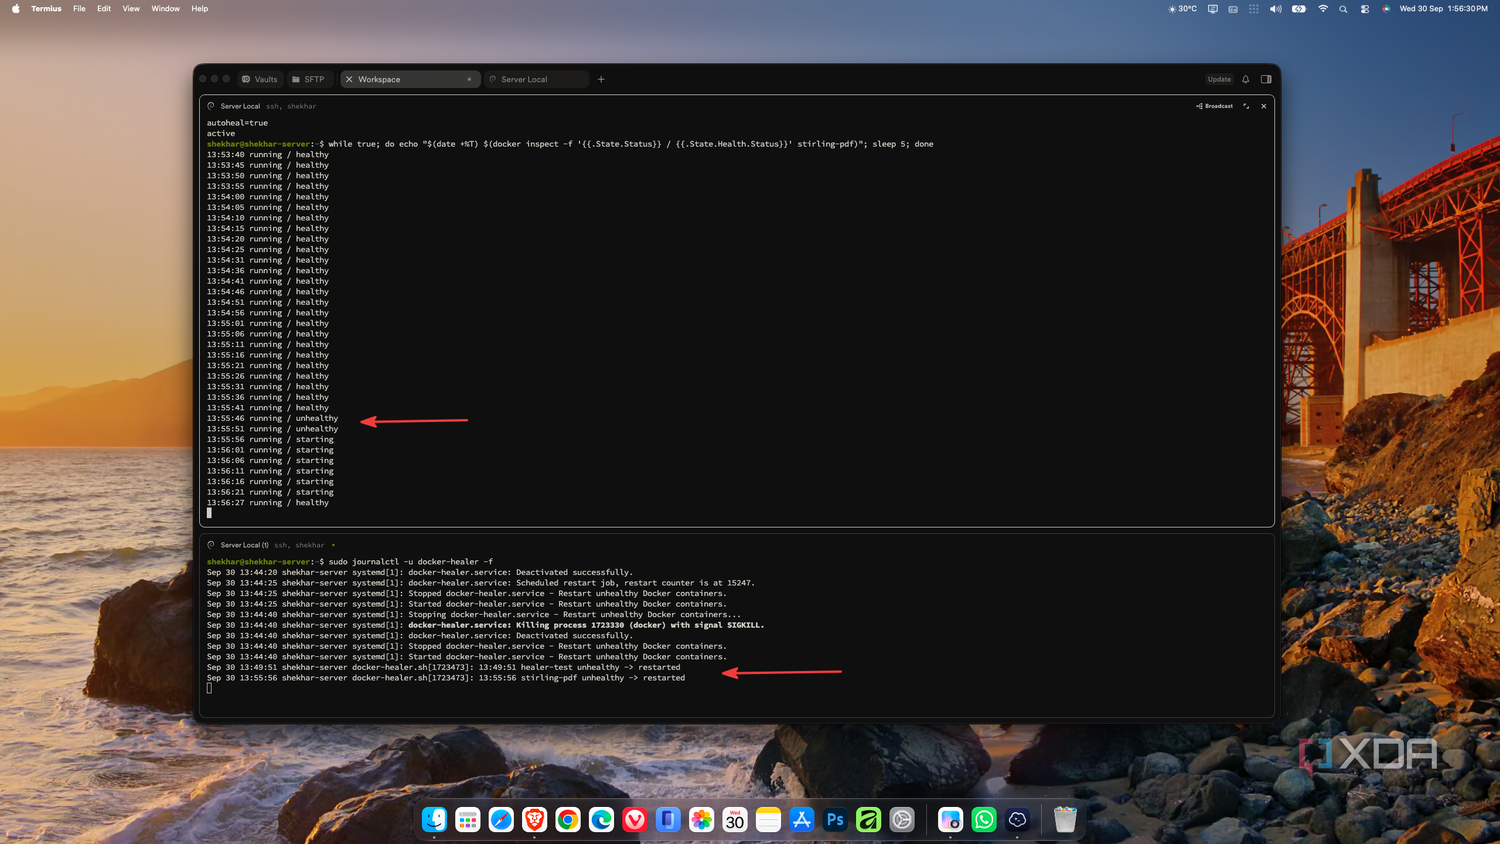
Скрипт, который я написал, работает как «наблюдатель» (watcher) через systemd. Чтобы проверить его эффективность, я не стал имитировать простой сбой (поскольку Docker и так умеет перезапускать упавшие процессы), а «заморозил» процесс Java в контейнере Stirling PDF. Поскольку процесс оставался «живым», но перестал реагировать, Docker считал его исправным. Однако через 90 секунд после перехода контейнера в состояние unhealthy мой скрипт зафиксировал сбой и инициировал перезапуск. Всего за две минуты сервис был восстановлен и снова перешел в состояние healthy.
Важно понимать: это не полноценный искусственный интеллект. Мой «автолекарь» не умеет анализировать логи и понимать, почему возникла ошибка. Если случится такой же инцидент, как с миграцией БД в Nextcloud, скрипт будет бесконечно перезапускать контейнер в надежде на чудо. Это лишь полумера, «костыль», который исправляет зависшие процессы, но не лечит глубокие архитектурные ошибки конфигурации.
Заключение: стоит ли игра свеч?
Мой самописный скрипт сейчас «сыроват» и требует доработки. В планах — интеграция локальной LLM для анализа причин падения, но это проект на будущее. Однако даже в нынешнем виде этот «наблюдатель» — маст-хэв для домашнего сервера. Само наличие качественной проверки состояния (health check) — это уже огромный шаг вперед по сравнению с тем, чтобы просто доверять флагу «Up» от Docker. Даже если вы не решитесь на автоматизацию перезапуска, добавление простых проверок для каждого контейнера в docker-compose поможет вам оперативно узнавать о реальных проблемах, а не обнаруживать их случайно спустя несколько дней.