Реляционные базы данных на базе SQL широко распространены, однако Linux предлагает альтернативный подход. В этой системе текстовый файл является основой, а наличие мощных встроенных утилит позволяет организовать структурированное хранение данных, их быструю проверку и версионный контроль без использования громоздкого стороннего ПО.

Инструменты командной строки для работы с данными
Для создания базы данных в Linux используются стандартные команды, работающие с потоками ввода и вывода. Ключевые утилиты включают:
- grep — поиск строк по заданным шаблонам;
- cut — извлечение определенных фрагментов данных из строк;
- awk — продвинутый язык для сканирования и обработки текстовых структур;
- sort — сортировка данных по столбцам с учетом численных или алфавитных значений;
- head и tail — извлечение заданного диапазона строк из общего объема данных;
- join — объединение информации из нескольких файлов на основе общих полей.
Организация таблиц в виде плоских файлов
Самым простым форматом для структурированного текста является DSV (delimiter-separated values), где поля разделены специальными символами, например, двоеточием. В качестве примера можно рассмотреть системный файл /etc/passwd. Для создания базы данных задач (todo-лист) можно сформировать файл следующего вида:
Buy milk:2024-10-21:2:openCall bank:2024-10-20:1:closed
Обновлять такую базу можно любым текстовым редактором или через командную строку, используя перенаправление вывода echo в файл: echo «Take out the trash:$(date -I):3:open» > tasks. Это действие аналогично SQL-запросу INSERT INTO tasks VALUES(…).
Выборка и фильтрация данных
Получение всех данных из файла осуществляется командой cat tasks. Если необходимо выбрать конкретные столбцы, используется инструмент cut. Параметр -d задает разделитель (в данном случае двоеточие), а -f указывает нужный номер поля.

Для фильтрации строк с заданными критериями идеальна утилита grep. Например, команда grep ‘open$’ tasks найдет все задачи со статусом «open». В случаях, когда требуются более сложные логические операции — например, поиск задач до определенной даты или сравнение числовых полей, — лучше воспользоваться мощностью awk: awk -F’:’ ‘$2<«2024-10-21» {print $1 «:» $2 }’ tasks.

Пагинация, сортировка и объединение таблиц
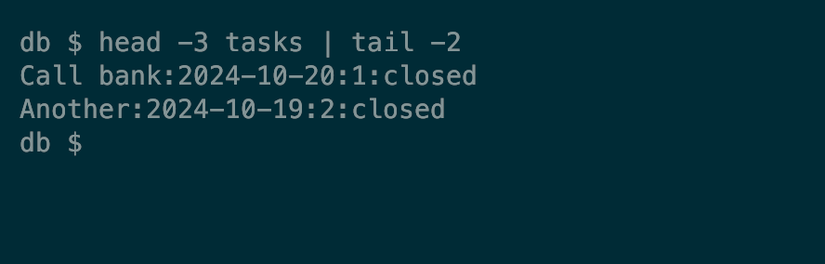
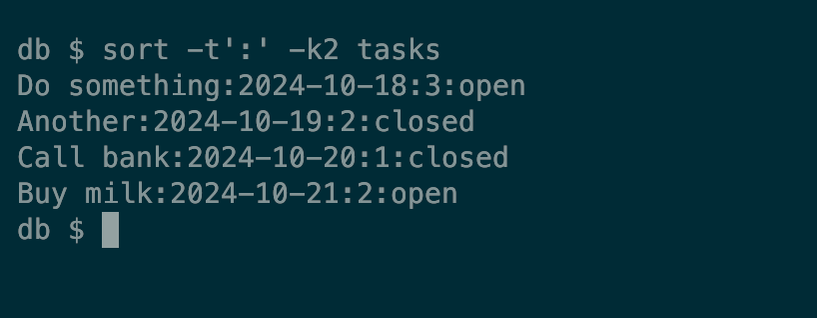
Для имитации SQL-команды LIMIT применяются head и tail. Комбинация head -3 tasks | tail -2 позволит извлечь вторую и третью строки из списка. Сортировка данных выполняется утилитой sort, где ключи -t и -k определяют разделитель и столбец соответственно.
Для работы со связанными данными, хранящимися в разных файлах, используется команда join. При объединении файла задач с файлом пользователей (people) достаточно указать номера полей для связи с помощью опций -1 и -2. Итоговый конвейер команд может выглядеть так:

join -t’:’ -1 5 -2 1 tasks people | awk -F’:’ ‘{print $2″:»$3″:»$4″:»$5″:»$6″ «$7}’ | grep ‘:2:’ | sort -t ‘:’ -k2 | head -1
Эта цепочка команд последовательно выполняет объединение, форматирование, фильтрацию по приоритету, сортировку по дате и вывод первой строки, успешно заменяя сложный SQL-запрос.

Почему стоит выбрать текстовый подход?
В Linux текстовый файл — это «король» данных. Благодаря экосистеме, которая активно поощряет объединение инструментов в цепочки (конвейеры), вы можете добиться впечатляющих результатов при минимальных затратах ресурсов. Использование простых текстовых файлов для организации базы данных дает несколько преимуществ:
- Прототипирование: Вы можете быстро набросать структуру данных и протестировать логику приложения.
- Инспекция: Ваши данные всегда доступны для просмотра в любом текстовом редакторе, их легко прочитать человеку без специального ПО.
- Версионный контроль: Поскольку база данных — это обычный текст, вы можете управлять её версиями через Git так же легко, как и программным кодом.
Тонкости работы с инструментами фильтрации
Хотя команды вроде grep кажутся простыми, их возможности значительно шире, если понимать, как они работают с входными потоками. Например, при фильтрации по статусу задачи grep ‘open$’ tasks мы используем спецсимвол $, который обозначает конец строки. Это делает поиск максимально точным, так как мы ищем именно те записи, где статус является последним полем.
Однако, если требуется отфильтровать данные, находящиеся в середине строки, регулярные выражения могут усложниться. Допустим, вам нужно найти все задачи с приоритетом 2. В этом случае команда будет выглядеть так: grep ‘:2:[^:]*$’ tasks. Здесь [^:]* означает «любые символы, кроме двоеточия», что позволяет корректно захватить поле приоритета, даже если после него в строке идет другой текст.
Когда задачи становятся сложнее, чем просто поиск подстроки — например, логическое сравнение дат (date < 2024-10-21) — grep уступает место awk. Команда awk -F’:’ ‘$2<«2024-10-21» {print $1 «:» $2 }’ tasks не просто фильтрует вывод, она выполняет роль парсера: -F’:’ задает разделитель, а условие $2 < «2024-10-21» работает как полноценная логическая проверка, после которой утилита выводит только те столбцы, которые нам нужны.
Управление постраничным выводом
SQL-запросы часто используют LIMIT для ограничения выборки. В Linux-терминале мы имитируем это поведение комбинацией head и tail. Если head -2 tasks просто выдает первые две строки, то использование head -3 tasks | tail -2 позволяет организовать полноценное смещение (offset), отсекая первую строку и оставляя строки со второй по третью. Это гибкий инструмент для постраничного отображения данных в консольных интерфейсах.

Реляционные связи в консоли
Многие пользователи недооценивают мощь команды join. В реляционных базах данных связь строится по внешним ключам, и join делает в точности то же самое для текстовых файлов. Например, если в файле tasks 5-е поле содержит идентификатор пользователя, а файл people хранит детали об этих пользователях, команда join -t’:’ -1 5 -2 1 tasks people сопоставит строки на основе этих полей.

После объединения вывод часто бывает избыточным, так как дублирует поле связи. Его легко «очистить», направив результат в cut: join -t’:’ -1 5 tasks people | cut -d’:’ -f2-, где -f2- означает «вывести все поля, начиная со второго». Для ещё более тонкой настройки отображения, например, объединения имени и фамилии в одну колонку, можно добавить awk: join -t’:’ -1 5 tasks people | awk -F’:’ ‘{print $2″:»$3″:»$4″:»$5″:»$6″ «$7}’. Это превращает разрозненные файлы в один аккуратно отформатированный отчет.
Перспективы развития
Описанный метод — это отличная отправная точка. Создав прототип на текстовых файлах, вы в любой момент сможете масштабировать решение. Как только функционала командной строки станет недостаточно, вы легко перенесете данные в полноценную СУБД или напишете скрипт на языке программирования, который будет автоматизировать работу с этим же форматом DSV. Помните: навыки, полученные при работе с базовыми утилитами Linux, универсальны и помогут вам лучше понимать, как устроены данные в любой другой системе.

Дополнительные возможности и нюансы работы с данными
Важно понимать, что использование текстовых файлов в Linux — это не просто способ хранения, а полноценная среда для быстрой разработки. В отличие от тяжеловесных SQL-систем, текстовый формат позволяет выполнять отладку данных буквально «на лету», используя стандартные потоки ввода (stdin) и вывода (stdout). Многие команды, которые мы рассматриваем, являются фильтрами: они принимают данные, трансформируют их согласно заданным условиям и передают результат дальше по цепочке.
Для эффективной работы с форматом DSV (delimiter-separated values) полезно помнить о гибкости командной строки:

- Инспекция и версии: Вы можете использовать любой текстовый редактор для внесения изменений, что делает процесс управления базой данных интуитивно понятным.
- Масштабируемость: По мере усложнения проекта вы всегда можете написать скрипт на языке программирования или перенести структуру в реляционную СУБД, имея на руках уже отлаженный прототип.
- Специфика сортировки: Утилита sort поддерживает не только алфавитный, но и числовой порядок. Использование флага -n (numeric sort) помогает избежать ошибок, когда число «10» ошибочно ставится перед «2» при стандартном сравнении строк.
Практические советы по написанию сложных конвейеров
Хотя примеры команд выглядят как набор случайных символов, их логика строго детерминирована. Рассмотрим, как именно инструменты дополняют друг друга при создании комплексных отчетов:

«Изучение Linux похоже на кулинарию. Навыки, которые вы приобретаете при работе над одним проектом, расширяются и переносятся на другие задачи. Вы можете создавать решения, которых до вас никто не реализовывал, просто комбинируя инструменты в уникальные цепочки».
При объединении таблиц с помощью команды join, помните о параметре -1 и -2. Они критически важны, если поля, по которым происходит связывание, не являются первыми в файлах. По умолчанию join всегда ожидает, что общим является именно первый столбец. Если ваша структура данных отличается, вы можете сэкономить время, заранее подготовив файлы или правильно указав индексы полей, что позволит избежать лишних этапов обработки через cut или awk.
Для автоматизации задач, подобных INSERT в SQL, использование echo с подстановкой текущей даты через $(date -I) является отличным способом ведения логов. Это удобно, когда данные нужно добавлять программно в скриптах, где ручной ввод недопустим. Освоение этих инструментов дает вам глубокое понимание принципов работы с потоками данных, которые лежат в основе любой современной технологической платформы.